
1. 들어가며
고객사의 앱에 음성·텍스트로 매장을 찾고 예약까지 이어 주는 AI 컨시어지를 PoC에서 MVP까지 구축한 과정을 기록했습니다. Google ADK로 만든 에이전트를 Vertex AI Agent Engine에 올리고, 매장 검색은 AlloyDB 하이브리드 검색을 MCP Toolbox for Databases 도구를 통해 붙인 AI 컨시어지 구축 과정 입니다.
2. 전체 구성
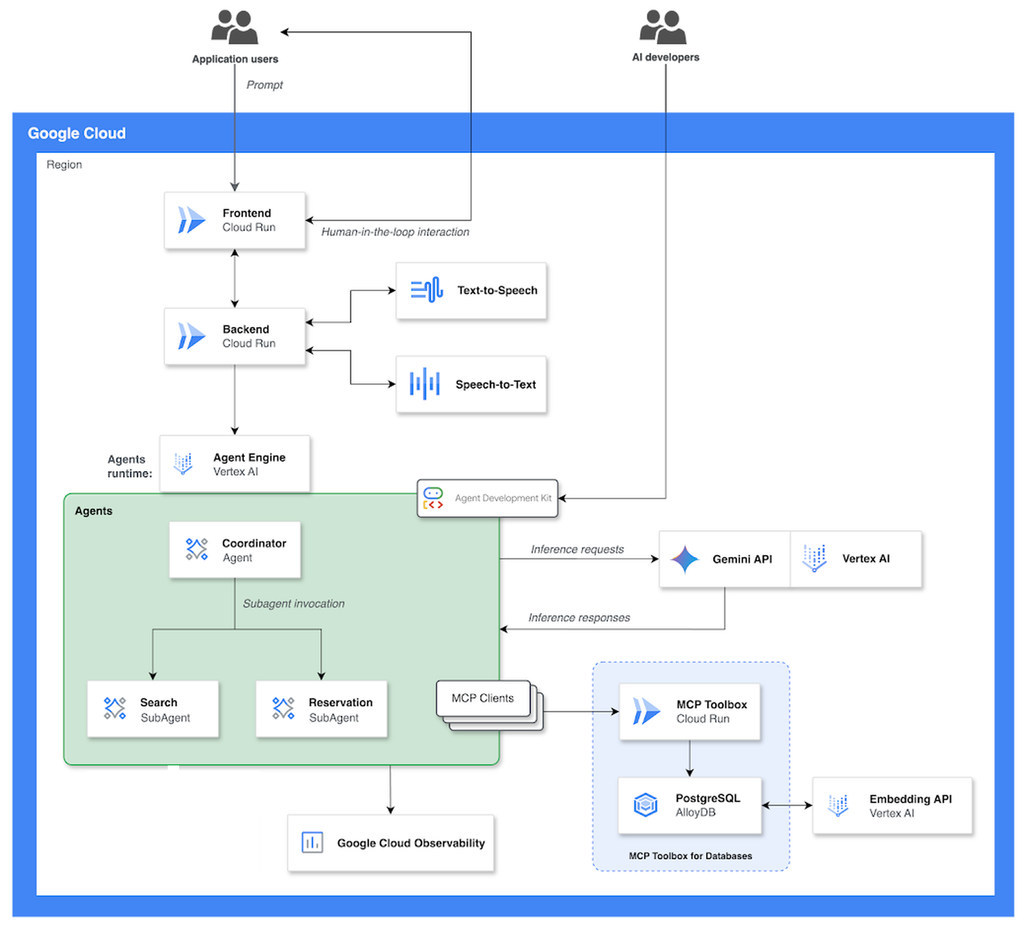
전체 구성. 에이전트 세 개가 Agent Engine 위에서 돌고, Search SubAgent 가 MCP 클라이언트로 Cloud Run 의 MCP Toolbox 를 거쳐 AlloyDB 를 조회합니다. 질문 임베딩은 AlloyDB 가 Vertex AI Embedding API 를 직접 호출해 만듭니다. Frontend 로 되돌아가는 Human-in-the-loop 화살표는 타임슬롯 버튼처럼 대화를 끊고 화면으로 넘기는 지점입니다.
- Frontend · Backend · MCP Toolbox — Cloud Run
- 에이전트 런타임 · 세션 — Vertex AI Agent Engine (ADK)
- 모델 — Gemini (Vertex AI)
- 검색 — AlloyDB (pgvector + GIN 인덱스), Vertex AI Embedding API
- 음성 — Speech-to-Text, Text-to-Speech
- 실행 추적 — Google Cloud Observability
에이전트는 세 개입니다. 의도를 보고 하위 에이전트로 넘기는 Coordinator Agent, 검색을 맡는 Search SubAgent, 타임슬롯 조회와 예약 정보 수집을 맡는 Reservation SubAgent입니다. 이 중 검색이 가장 손이 많이 갔습니다. 그림에는 없지만 Backend에는 한국어 형태소 분석 API도 있습니다. 검색 토큰을 만들 때 씁니다.
3. AlloyDB 하이브리드 검색
AlloyDB는 Google Cloud의 PostgreSQL 호환 관리형 데이터베이스입니다. 검색에 필요한 것이 한 DB 안에 다 있어서 골랐습니다. pgvector의 벡터 컬럼과 거리 연산, PostgreSQL 전문 검색의 tsvector 컬럼과 GIN 인덱스, 그리고 AlloyDB AI의 google_ml_integration 확장입니다. 마지막 것은 SQL 안에서 Vertex AI 임베딩 모델을 바로 부르게 해 줍니다. 벡터 인덱스는 pgvector의 HNSW 외에 AlloyDB 전용 ScaNN도 지원합니다.
조건 기반 추천에는 의미 검색이 잘 맞습니다. 데이트하기 좋은 같은 표현은 임베딩이 잘 잡습니다. 문제는 상호명입니다. 특정 매장을 지정한 질문에서 벡터 검색은 이름이 비슷한 곳이나 업종이 비슷한 곳을 데려옵니다. 그래서 매장 테이블에 벡터 컬럼 embed_shop 과 tsvector 컬럼 fts_document_shop 을 두고, 둘을 Cloud Functions 배치로 채웠습니다.
임베딩은 매장 설명을 Vertex AI의 gemini-embedding-001 로 만들어 넣습니다. 여기까지는 특별한 것이 없습니다.
Full-Text 쪽이 한국어라서 손이 갔습니다. PostgreSQL에 내장된 전문 검색 구성은 영어·독일어 같은 스노우볼 계열만 있고 한국어가 없습니다. AlloyDB가 지원하는 확장 목록에도 한국어 형태소 사전은 없습니다. n-gram 방식의 pg_bigm 정도가 있을 뿐입니다. 룸 있고 주차 가능한 식당 을 to_tsvector 에 그대로 넘기면 조사와 어미가 붙은 채로 토큰이 만들어집니다. 그래서 형태소 분석기 Kiwi로 명사류만 뽑아 simple 사전에 넣었습니다.
입력    룸 있고 주차 가능한 스시 오마카세 식당
Kiwi    룸 주차 가능 스시 오마카세            ← 명사류만 남기고 '식당' 같은 불용어는 제거
저장    to_tsvector('simple', '룸 주차 가능 스시 오마카세')
simple 사전을 쓰는 이유는 어간 처리를 Kiwi가 이미 했기 때문입니다. 검색할 때도 같은 분석기로 질문을 토큰화해 to_tsquery('simple', ...) 를 만들어야 양쪽 토큰이 맞습니다. 이 분석기는 Backend에 /text/analyze API로 띄워 두었습니다.
4. MCP Toolbox for Databases
MCP Toolbox for Databases는 SQL을 YAML로 등록하면 그것을 MCP 도구로 노출해 주는 서버입니다. AlloyDB, Cloud SQL, BigQuery 등을 소스로 잡을 수 있고, 에이전트 쪽에서는 toolbox_core 클라이언트로 도구 목록을 받아 씁니다. 저희는 Cloud Run에 올렸고, tools.yaml 은 Secret Manager에 두고 마운트했습니다. 같은 조합을 처음부터 따라가 보려면 공식 Codelab이 있습니다.
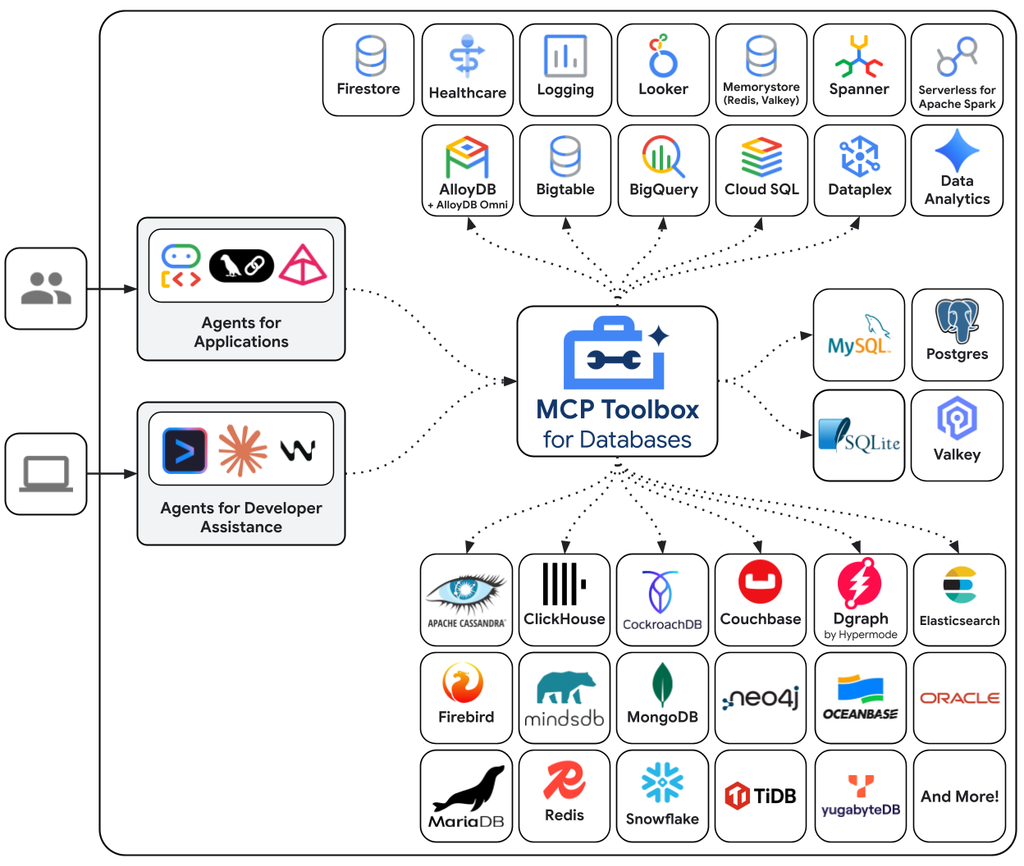
MCP Toolbox for Databases 개요. 에이전트 프레임워크와 DB 사이에 서서, YAML 로 정의한 SQL 을 MCP 도구로 내어 줍니다. 이 글에서는 이 중 AlloyDB 를 썼습니다. (그림: Google, MCP Toolbox for Databases 저장소)
tools.yaml 은 sources · tools · toolsets 세 블록입니다. 검색 도구는 hybrid_search 하나뿐이고 파라미터가 17개입니다.
sources:
  restaurant-db:
    kind: alloydb-postgres
    project: <PROJECT_ID>
    region: asia-northeast3
    cluster: <CLUSTER>
    instance: <INSTANCE>
    database: <DATABASE>
    user: <USER>
    password: <PASSWORD>        # 파일 전체를 Secret Manager 에서 주입
    ipType: private

tools:
  hybrid_search:
    kind: postgres-sql
    source: restaurant-db
    description: >-
      Full-Text와 Vector Search를 결합하여 식당을 검색합니다.
      A. 특정 매장 검색 ("OO 주차 정보"): query='None', shop_name_boost=매장명 토큰, 필터='None'
      B. 조건 기반 추천 ("강남 주차 가능한 맛집"): query=질문 전체, 해당 필터 적용
      지역명 언급 시 display_region_filters 와 subway_filters 둘 다 설정.
      필터 조합은 |(OR), &(AND). 기본값은 문자열 'None'.
    parameters:
      - name: query
        type: string
        description: 벡터 검색용 자연어 쿼리. 특정 매장명만 찾을 때는 'None'
      - name: ts_query
        type: string
        description: Full-Text Search 쿼리. 토큰을 |로 연결
      - name: cuisine_filters
        type: string
        description: 음식 종류 필터. [사용 가능한 값: '한식', '일식', '스시오마카세', ...]
      # ... 지역 · 지하철역 · 가격 · 평점 · 분위기 · 시설 · 인원 · 정렬 · 매장명 부스트 등 총 17개
    statement: |
      WITH
        filtered_shops     AS ( ... ),   -- 필터 (JSONB ?| ?&)
        shop_vector_search AS ( ... ),   -- pgvector 거리 순위
        shop_text_search   AS ( ... ),   -- ts_rank + 매장명 부스트 순위
        shop_name_intent   AS ( ... ),   -- 이름이 일치하는 매장
        top_relevant AS (
          SELECT fs.id,
                 COALESCE(1.0 / (60 + svs.rank), 0.0)
               + COALESCE(1.0 / (60 + sts.rank), 0.0)
               + CASE WHEN sni.id IS NOT NULL THEN 100.0 ELSE 0.0 END AS rrf_score
          FROM filtered_shops fs
          LEFT JOIN shop_vector_search svs ON fs.id = svs.id
          LEFT JOIN shop_text_search   sts ON fs.id = sts.id
          LEFT JOIN shop_name_intent   sni ON fs.id = sni.id
          ORDER BY rrf_score DESC LIMIT 5
        )
      SELECT s.* FROM top_relevant t JOIN shops_master s ON t.id = s.id;

toolsets:
  restaurant_search_tools:
    - hybrid_search
모델은 이 도구를 고를 때 도구와 파라미터의 description 을 읽습니다. 검색 모드 A/B 구분, 지역명이 나오면 지하철역 필터도 함께 채우라는 규칙, 필터 값은 허용 목록에 있는 것만 쓰라는 규칙이 여기 있습니다. 처음에는 이런 규칙을 에이전트 instruction에 두었는데, 모델이 도구를 고르는 순간에 필요한 규칙은 도구 스키마 쪽에 있는 편이 잘 지켜졌습니다. 이 파일의 description 이 사실상 검색 프롬프트입니다.
statement 는 CTE 네 개를 RRF로 합칩니다. 벡터 쪽은 embed_shop <#> google_ml.embedding('gemini-embedding-001', $1)::vector 로 정렬하는데, AlloyDB AI의 google_ml.embedding() 이 질문 임베딩을 DB 안에서 만들어 줍니다. 그림에서 AlloyDB와 Embedding API가 직접 이어진 이유이고, 애플리케이션이 임베딩 API를 따로 부를 필요가 없습니다. 텍스트 쪽은 ts_rank 에 매장명 토큰 가중치 1.5배와 ILIKE 보조 매칭을 더합니다. 두 순위를 1 / (60 + rank) 로 합치고, 이름이 일치한 매장에는 +100을 더해 상호명을 말한 질문에서 그 매장이 5위 밖으로 밀리지 않게 했습니다. 다중값 필터는 JSONB 배열 연산자 ?| (하나라도 포함)와 ?& (모두 포함)로 OR/AND를 가릅니다.
cuisine_filters 의 [사용 가능한 값: ...] 은 DB에 실제로 있는 값입니다. 매장 데이터가 바뀌면 이 목록도 바뀌어야 하는데, 손으로 고치다 보면 어긋납니다. 그래서 Cloud Functions 하나가 JSONB 컬럼의 distinct 값을 읽어 tools.yaml 의 해당 구간을 치환하고, Secret Manager에 새 버전으로 올린 뒤 Cloud Run 리비전을 갱신해 Toolbox를 다시 배포합니다.
5. ADK 에이전트
ADK에서 Toolbox를 붙이는 방법은 toolbox_core 의 ToolboxClient 로 도구 목록을 받아 FunctionTool 로 감싸는 것입니다. Toolbox가 Cloud Run에 인증 필수로 올라가 있어서 ID 토큰을 헤더에 붙입니다.
from toolbox_core import ToolboxClient, auth_methods
from google.adk.tools import FunctionTool

client = ToolboxClient(
    TOOLBOX_SERVER_URL,
    client_headers={"Authorization": auth_methods.get_google_id_token(TOOLBOX_SERVER_URL)},
)
tools = [FunctionTool(func=t) for t in await client.load_toolset("restaurant_search_tools")]
Search SubAgent에는 이 도구 하나만 두고 나머지 처리는 콜백에 맡겼습니다. 콜백은 모델의 판단을 기다리지 않고 도구 호출 직전·직후, 모델 응답 직후 같은 정해진 지점에서 항상 실행되는 코드입니다.
search_agent = Agent(
    model=Gemini(model=os.getenv("AGENT_MODEL_NAME")),
    name="search_agent",
    instruction=SEARCH_INSTRUCTION,
    tools=tools,
    output_schema=SearchOutputSchema,                     # 응답을 JSON 으로 고정
    disallow_transfer_to_parent=True,
    before_tool_callback=before_hybrid_search_callback,   # query 형태소 분석 → ts_query
    after_model_callback=after_model_callback,            # function_call 인자 보정
    after_tool_callback=after_hybrid_search_callback,     # 결과에 예약 가능 여부 부착, 에러 재시도
)
처음부터 이 모양은 아니었습니다. 초기 구조는 검색 한 번에 도구를 세 개 썼습니다. 형태소 분석, 하이브리드 검색, 예약 가능 여부 확인입니다. 각각이 별개의 도구라 검색 1회당 모델 호출이 최소 3회 붙었습니다. 그런데 이 세 가지는 검색할 때면 항상 해야 하는 일입니다. 판단할 여지가 없는 처리를 모델에게 물어볼 이유가 없어서 콜백으로 옮겼습니다.
before_tool_callback 은 모델이 넘긴 query 를 형태소 분석 API에 보내 ts_query 를 채우고, 한 턴에 검색이 두 번을 넘으면 도구를 실행하지 않고 받은 결과로 답을 완성하라는 안내를 대신 돌려줍니다. after_tool_callback 은 검색 결과의 매장 목록으로 예약 플랫폼 API를 조회해 available 필드를 붙입니다. 모델은 가능 여부가 이미 붙은 결과를 받으므로 두 번째 도구를 부를 일이 없습니다.
이렇게 해서 Search SubAgent의 도구는 hybrid_search 하나로 줄었습니다. 모델 왕복이 줄어 응답이 빨라졌고 호출 비용도 함께 내려갔습니다.
6. 트러블슈팅
속도 · 정확도 · 일관성
Trace로 보니 가장 큰 병목은 모델 추론 시간이었습니다. 그래서 도구 세 개를 콜백으로 옮겨 모델 왕복을 줄였고, thinking budget을 0으로 두었고, 필터 파라미터 7개를 걷어냈습니다.
그 대가는 정확도에서 나왔습니다. thinking을 끄자 모델이 어떤 필터에 어떤 값을 넣을지 덜 정확하게 판단했고, 필터를 걷어내자 룸과 주차를 동시에 요구하는 조건을 처리하지 못했습니다. 형태소 분석을 콜백으로 자동화한 뒤에는 모델이 의도한 것과 다른 토큰이 들어가는 경우가 생겼습니다.
세 가지는 각각 다르게 풀었습니다. thinking을 끄고 떨어진 필터 정확도는 instruction이 아니라 tools.yaml 의 description 을 보강해 되돌렸습니다. 검색 모드 A/B 구분, 지역명이 나오면 지하철역 필터도 채우라는 규칙, 허용 값 목록이 이때 들어갔고, 모델이 도구를 고르는 순간에 읽는 글이라 thinking 없이도 잘 지켜졌습니다. 걷어낸 필터는 MVP에서 되살렸고, 대신 AND 조합에서 0건이 나오는 경우를 위해 결과 없음 응답을 따로 설계했습니다. 없다는 것을 인정하고, 대안을 제시하고, 지역을 넓힐지 조건 하나를 놓을지 양자택일로 유도하는 순서입니다. 형태소 분석은 도구로 되돌린 버전과 나란히 돌려 본 뒤 콜백을 유지하기로 하고, 대신 after_model_callback 에서 모델이 넘긴 인자를 보고 이미 토큰이면 그대로 두고 원문이면 분석기를 태우는 보정 지점을 하나 더 두었습니다. 음성 대화에서는 왕복 한 번의 지연이 정확도 손실보다 크게 느껴졌기 때문입니다.
일관성은 또 다른 축이었습니다. 같은 질문에 응답 형식이 흔들리는 문제는 output_schema 로 JSON을 고정해 잡았고, 모델이 같은 검색을 되풀이하는 문제는 한 턴 호출 상한 2회로 막았습니다. 상한에 걸리면 도구를 실행하지 않고 받은 결과로 답을 완성하라는 안내를 대신 돌려줍니다. 응답 시간의 편차는 못 잡았습니다. 같은 질의를 반복하면 대부분 비슷한데 한 번이 크게 튀는 경우가 있었고, 질의 복잡도와 무관하게 나타났습니다. Trace 상 모델 추론 시간 자체가 튀는 것이라 이 부분은 아직 숙제로 남았습니다.
Toolbox prepared statement 에러
MVP 테스트 중 hybrid_search 가 간헐적으로 아래 에러를 돌려줬습니다.
unable to execute query: ERROR: prepared statement "stmtcache_..." does not exist (SQLSTATE 26000)
Toolbox가 쓰는 pgx 드라이버는 기본 실행 모드가 QueryExecModeCacheStatement 라 prepared statement를 서버 쪽에 캐시합니다. Cloud Run 인스턴스가 유휴 상태를 지나거나 스케일링되면서 AlloyDB 커넥션이 다시 맺어지면 서버 쪽 캐시는 사라지는데 클라이언트는 옛 statement 이름을 그대로 부르는 것입니다. 처음 한 번은 잘 되고 한참 뒤 두 번째 호출에서 나는 패턴이라 재현에 시간이 걸렸습니다.
해결은 AlloyDB 쪽에서 했습니다. Cloud Run과 AlloyDB 사이에 있는 AlloyDB managed connection pooling 설정을 바꿔, 커넥션이 풀을 거치며 바뀌어도 prepared statement 상태가 어긋나지 않게 했습니다. 그 뒤로는 같은 에러가 나지 않았습니다.
Toolbox 쪽에서 근본적으로 풀려면 pgx 실행 모드를 simple_protocol 로 바꿀 수 있어야 하는데, 당시 Toolbox 0.26에는 그 설정이 없었습니다. 소스 설정에 queryExecMode 필드를 추가해 달라는 이슈를 올려 두었습니다 (mcp-toolbox #2385).
평가
평가는 처음에 Vertex AI의 Gen AI Evaluation SDK로 하려 했습니다. Agent Engine에 올린 에이전트를 client.evals.run_inference() 에 걸면 질의 세트를 돌려 응답을 모아 주고, 그 위에 평가 지표를 얹는 구조입니다. 단일 에이전트는 잘 돌았는데, Coordinator가 transfer_to_agent 로 하위 에이전트에 넘기는 구조에서는 SDK가 응답을 파싱하지 못했습니다.
Failed to parse agent run response [...] to intermediate events and final response: 'text'
이벤트 안에 transfer_to_agent 의 function_response 가 result: None 으로 들어오는데 SDK가 거기서 text 를 찾다가 실패하는 것으로 보여서 이슈를 올렸습니다 (generative-ai #2578).
그래서 Backend의 Chat API를 실제 사용자와 같은 경로로 두드리는 스크립트 통해 평가 하였습니다. 고객사와 협의한 질의 세트를 같은 질의마다 여러 번 부르고, 호출마다 세션을 새로 만들어 직전 대화가 다음 결과에 섞이지 않게 했습니다. 호출별 응답 시간을 기록하고 응답 JSON은 파일로 저장합니다. 검증 기준이 응답 속도와 정답률이었기 때문에 에이전트만 따로 재는 것이 아니라 음성 전환을 제외한 실제 API 경로를 그대로 재야 했고, 같은 질의를 여러 번 돌린 것은 평균보다 편차를 보기 위해서 입니다.
채점은 저장된 응답을 가지고 했습니다. 질의 별로 기대 결과를 적어 두고, 각 응답이 그에 맞는지는 LLM에게 O/X로 1차 판정을 시켜 표로 만들었습니다. 다만 거기서 끝내지 않고 X가 나온 것은 저장된 JSON을 직접 열어 어떤 필터와 어떤 토큰으로 그 매장이 나왔는지를 확인했습니다. 그것을 봐야 tools.yaml 의 어느 규칙을 고칠지 정할 수 있었고, 점수만 남으면 다음 액션이 없었습니다.
7. 마치며
돌아보면 기술적인 커버리지가 꽤 넓은 프로젝트였습니다. Cloud Run과 AlloyDB 같은 인프라부터 매장 데이터 적재, 임베딩 및 검색 토큰 파이프라인, 그 위의 멀티 에이전트까지 PoC에서 MVP로 끌고 가야 했습니다. 예전 같았으면 어느 한 축은 놓쳤을 텐데, AI 덕분에 생소한 도구의 설정 파일을 잡고 SQL을 다듬거나 콜백 코드를 붙이는 작업 속도를 크게 줄일 수 있었습니다.
하지만 AI가 대신해 줄 수 없는 영역도 명확했습니다. Toolbox의 prepared statement 에러, 평가 SDK가 멀티 에이전트 응답을 제대로 읽지 못하던 문제, 당시 Live API 위에서 하위 에이전트를 쓸 수 없었던 이슈 등은 도구 자체의 버그이거나 미지원의 문제였습니다. 이런 건 AI에게 물어봐도 그럴듯한 코드 수정안만 내놓을 뿐이었습니다. 결국 로그와 트레이스를 직접 확인하고 동작을 하나하나 까본 뒤에야 코드 문제가 아니라는 결론을 내릴 수 있었습니다.
도구 버전과 문서가 몇 달 단위로 뒤바뀌는 영역이라 AI가 주는 답변을 그대로 믿을 수도 없었습니다. 결국 이슈가 터졌을 때 우리 코드의 실수인지, 도구의 버그인지, 아직 지원하지 않는 조합인지를 가려내는 일은 온전히 사람이 해야 했습니다. 속도와 완성도 사이에서 무엇을 취할지, 우회책을 쓸지 근본 수정 패치를 기다릴지 결정하는 것도 마찬가지였습니다.
AI 덕분에 넓은 범위를 빠르게 쳐낼 수 있었지만, AI로 생산성을 높일수록 시스템 전반에 대한 이해도가 뒷받침되어야 정확한 디버깅과 의사결정이 가능하다는 점을 체감한 프로젝트였습니다.
참고 자료
- ADK — MCP Toolbox for Databases tool
- ADK Callbacks
- MCP Toolbox for Databases 문서
- MCP Toolbox for Databases (GitHub)
- Codelab — MCP Toolbox for Databases 와 ADK 로 여행 에이전트 만들기
- AlloyDB — 개요
- AlloyDB — 임베딩 생성 및 저장
- AlloyDB — 벡터 검색 수행
- kiwipiepy