
들어가며
Azure를 쓰다 보면 “스토리지 계정 = Blob”이라는 등식이 머릿속에 박히기 쉽습니다. 이미지든 백업이든 일단 Blob에 넣으니까요. 그런데 스토리지 계정을 하나 만들면, 그 안에는 사실 네 가지 데이터 서비스가 함께 들어 있습니다.
- Blob — 비정형 객체 저장 (이미지, 로그, 백업)
- Files — SMB/NFS로 마운트하는 관리형 파일 공유
- Queue — 메시지 큐
- Table — NoSQL 키-값 저장소
앞의 두 개(Blob, Files)는 워낙 많이 쓰이고 자료도 넘칩니다. 그래서 이 글에서는 상대적으로 조명을 덜 받지만, 알아두면 작은 시스템을 아주 저렴하고 가볍게 엮을 수 있는 두 조연, Queue와 Table에 집중하겠습니다.
두 서비스를 따로따로 소개하는 데서 그치지 않고, “주문 접수 → 상태 관리”라는 작은 시나리오 하나로 엮어서 각자 어떤 자리에서 빛나는지, 그리고 실무에서 자주 헷갈리는 “그럼 Service Bus / Cosmos DB랑 뭐가 다른데?” 라는 질문에도 답해보겠습니다.
이 글의 모든 실습은 실제 Azure 구독에서 리소스를 만들어 수행했고, 명령 출력과 포털 화면을 그대로 실었습니다. 리전은
koreacentral기준입니다.
1. 공통 토대 — 스토리지 계정과 엔드포인트
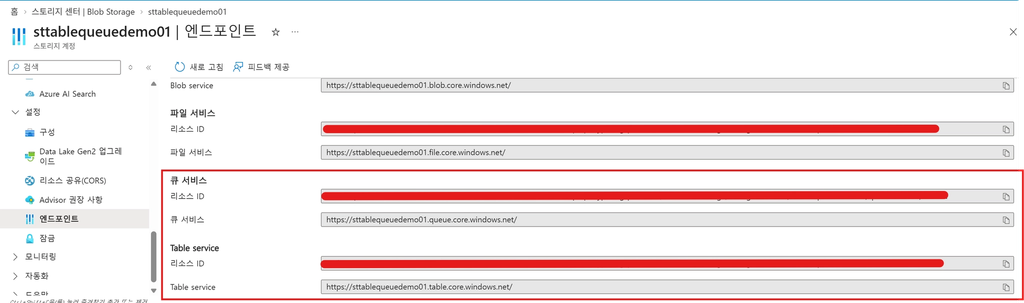
네 가지 서비스는 각각 자신만의 엔드포인트를 가집니다. 이 글에서 다룰 두 개는 다음과 같습니다.
- Table:
https://<account>.table.core.windows.net - Queue:
https://<account>.queue.core.windows.net
먼저 실습용 리소스 그룹과 스토리지 계정을 만듭니다. 계정 종류는 범용으로 가장 널리 쓰이는 StorageV2(GPv2) 를 사용합니다.
# 리소스 그룹 생성
az group create -n rg-tablequeue-demo -l koreacentral

# 스토리지 계정 생성 (StorageV2, LRS)
az storage account create \
  -n sttablequeuedemo01 \
  -g rg-tablequeue-demo \
  -l koreacentral \
  --sku Standard_LRS \
  --kind StorageV2
포털 > 스토리지 계정 엔드포인트 화면
이후 명령에서 매번 키를 입력하지 않도록, 연결 문자열을 환경 변수로 잡아두면 편합니다.
# 연결 문자열 조회 후 환경 변수 설정 (PowerShell 기준)
$env:AZURE_STORAGE_CONNECTION_STRING = (az storage account show-connection-string
  -n sttablequeuedemo01 -g rg-tablequeue-demo --query connectionString -o tsv)
2. 관통 시나리오 — “주문 접수 → 상태 관리”
이 글의 예시는 하나의 작은 흐름을 기준으로 합니다. 3장과 4장에서 각 서비스를 하나씩 살펴볼 때 이 주문 상황을 그대로 씁니다.
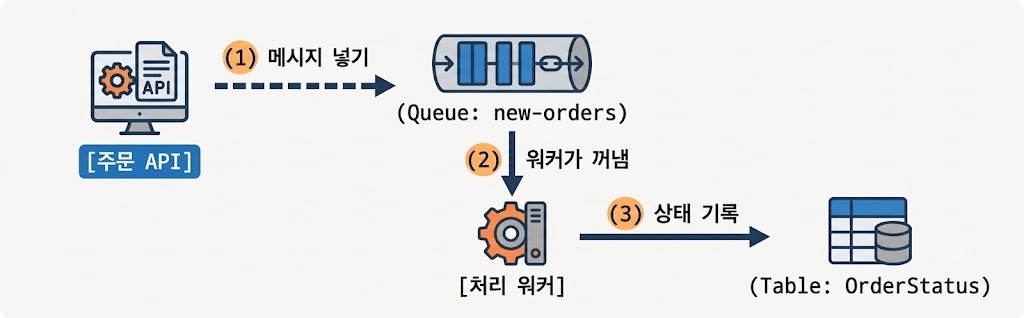
- Queue: 주문이 들어오면 일단 메시지를 큐에 넣어 비동기로 접수합니다. 주문 API는 큐에 넣기만 하면 되니 빠르게 응답하고, 실제 처리는 뒤에서 천천히 진행됩니다.
- Table: 워커가 메시지를 꺼내 처리한 뒤, 주문 상태를 Table에 key-value로 기록합니다. 이후 상태 조회는 Table에서 빠르게 읽습니다.
이 구조의 장점은 느슨한 결합입니다. 주문이 몰려도 큐가 버퍼 역할을 하고, 워커는 자기 속도로 처리하면 됩니다.
3. Queue Storage — 단순하고 저렴한 메시지 큐
3-1. 개념
Queue Storage는 메시지(최대 64KB)를 넣고 빼는 단순한 큐입니다. 핵심은 세 가지입니다.
- 느슨한 결합: 생산자(주문 API)와 소비자(워커)가 직접 연결되지 않습니다.
- 부하 평탄화: 요청이 몰려도 큐에 쌓아두고 워커가 자기 속도로 소비합니다.
- 가시성 타임아웃(visibility timeout): 메시지를 꺼내면 바로 사라지는 게 아니라 일정 시간 “숨겨집니다”. 워커가 처리를 끝내고 명시적으로 삭제해야 완전히 제거됩니다. 처리 중 워커가 죽으면, 타임아웃 후 메시지가 다시 보여서 재처리됩니다. 이게 큐의 안전망입니다.
3-2. 실습
# 큐 생성
az storage queue create --name new-orders

# 생산자: 주문 접수 메시지 넣기
az storage message put --queue-name new-orders --content "order-123 created"

# 소비자: 메시지 꺼내기 (아직 삭제 전 — 숨김 상태가 됨)
az storage message get --queue-name new-orders
message get 결과
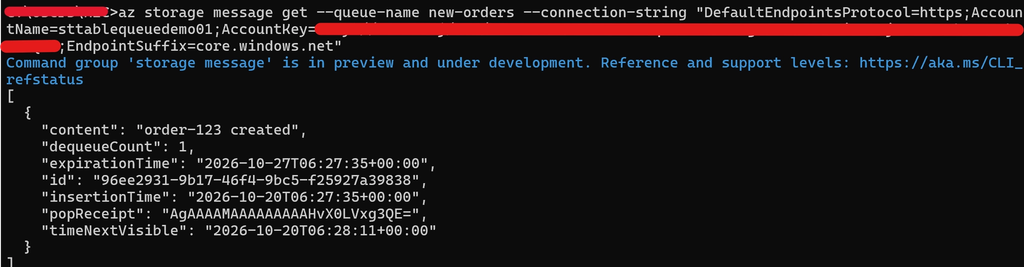
여기서 재미있는 걸 하나 시연할 수 있습니다. get으로 꺼낸 직후 바로 다시 get을 하면 메시지가 안 보입니다(가시성 타임아웃 동안 숨겨져서). 삭제하지 않고 타임아웃이 지나면 다시 나타납니다. 처리를 끝냈다면 popReceipt를 이용해 명시적으로 삭제합니다.
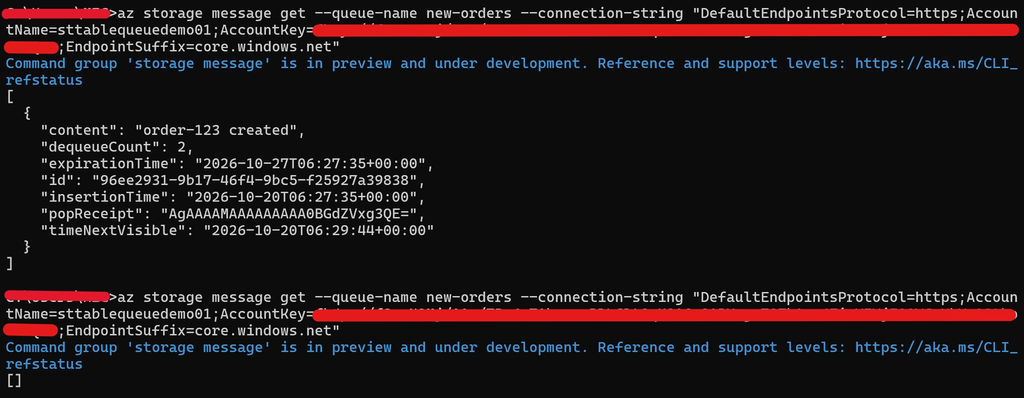
# 처리 완료 후 삭제 (message get 출력의 id와 popReceipt 사용)
az storage message delete --queue-name new-orders \
  --id <messageId> --pop-receipt <popReceipt>
3-3. 선 긋기 — Queue Storage vs Service Bus
Queue를 보면 누구나 묻습니다. “그냥 Service Bus 쓰면 안 돼?” 둘은 비슷해 보이지만 체급이 다릅니다.
| 항목 | Queue Storage | Service Bus |
|---|---|---|
| 성격 | 단순·대용량·저렴 | 엔터프라이즈 메시징 |
| 순서 보장(FIFO) | 보장 안 함 | 세션으로 보장 |
| 토픽/구독(Pub-Sub) | 없음 | 있음 |
| 중복 제거·트랜잭션 | 없음 | 있음 |
| 메시지 크기 | 64KB | 더 큼 (계층별로 상이) |
판단 기준은 간단합니다. 그냥 작업을 버퍼링하고 느슨하게 연결하는 용도면 Queue Storage로 충분합니다. 메시지 순서 보장, 토픽 기반 발행/구독, 트랜잭션 같은 기능이 필요한 순간 Service Bus로 올라가면 됩니다.
4. Table Storage — 아주 저렴한 NoSQL 키-값
4-1. 개념
Table Storage는 스키마리스 NoSQL 키-값 저장소입니다. 모든 엔터티(행)는 두 개의 키로 식별됩니다.
- PartitionKey: 데이터를 분산/확장하는 단위. 같은 파티션 키를 가진 엔터티들이 함께 묶입니다.
- RowKey: 파티션 안에서의 정렬·식별 키.
이 둘의 조합이 기본 키(primary key)이고, 나머지 속성은 자유롭게 넣을 수 있습니다. 행마다 속성이 달라도 됩니다.
4-2. 설계 주의 — 이게 Table의 핵심 교훈
Table Storage에서 가장 중요한 건 키 설계입니다. 이유는 쿼리 동작 때문입니다.
- PartitionKey + RowKey로 조회하면 → 매우 빠름 (키 직접 조회)
- PartitionKey 없이 그 외의 속성으로 조회하면 → 전체 스캔이 발생해 느리고 비쌉니다
예를 들어 “상태가 Paid인 주문을 모두 찾아줘” 같은 쿼리를 자주 한다면, Status를 일반 속성으로만 두면 전체 스캔이 걸립니다. 이런 접근 패턴이 중요하다면 PartitionKey/RowKey 설계에 그 패턴을 녹여야 합니다. “데이터를 어떻게 저장할까”가 아니라 “어떻게 조회할까를 먼저 정하고 키를 설계” 하는 게 Table의 핵심입니다.
4-3. 실습
주문 상태를 저장해봅니다. PartitionKey는 월 단위(2026-10), RowKey는 주문 번호(order-123)로 잡았습니다.
# 테이블 생성
az storage table create --name OrderStatus

# 주문 상태 저장
az storage entity insert --table-name OrderStatus \
  --entity PartitionKey=2026-10 RowKey=order-123 Status=Paid Amount=15000

# 키로 조회 (빠름)
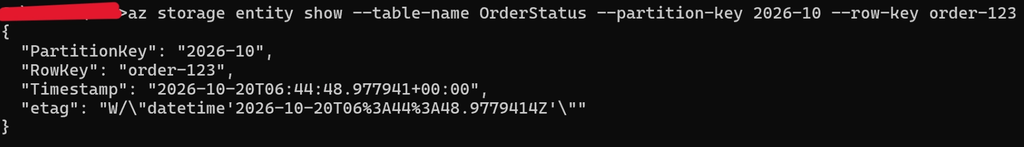
az storage entity show --table-name OrderStatus \
  --partition-key 2026-10 --row-key order-123
entity show 결과 (PartitionKey, RowKey, Status, Amount, Timestamp)
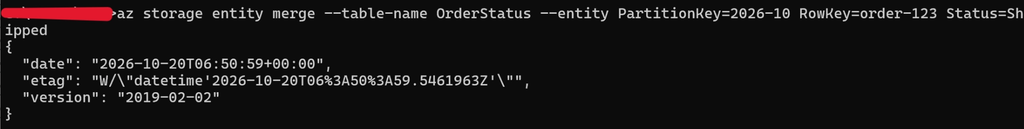
상태를 갱신할 때는 merge(지정한 속성만 병합)와 replace(엔터티 전체 교체)가 다릅니다. 일부 속성만 바꾸려면 merge를 씁니다.
# 상태만 Shipped로 갱신 (merge: Amount 등 나머지 속성은 유지)
az storage entity merge --table-name OrderStatus \
  --entity PartitionKey=2026-10 RowKey=order-123 Status=Shipped
4-4. 선 긋기 — Table Storage vs Cosmos DB for Table
Table도 똑같은 질문을 받습니다. “Cosmos DB랑 뭐가 달라?” 재밌는 건 API와 데이터 모델이 동일해서, 코드 변경 거의 없이 갈아탈 수 있다는 점입니다. 차이는 성능과 비용에 있습니다.
| 항목 | Table Storage | Cosmos DB for Table |
|---|---|---|
| API/데이터 모델 | 동일 | 동일 (코드 거의 그대로 이전 가능) |
| 인덱싱 | PK/RK 중심, 제한적 | 전 속성 자동 인덱싱 |
| 지연시간 SLA | 공식 SLA 없음 (일반적으로 수십 ms 수준) | 읽기 10ms 미만, 쓰기 15ms 미만 |
| 글로벌 분산 | 지역 복제 (재해 대비용) | 다중 지역 분산 (저지연 서비스용) |
| 비용 | 아주 저렴 | 비쌈 |
판단 기준: 싸고 단순한 키-값 저장이면 Table Storage로 시작합니다. 전역 저지연, 키가 아닌 속성으로도 빠른 쿼리, 글로벌 분산이 필요해지면 Cosmos DB for Table로 올라가면 됩니다. 같은 API라 이전 부담이 작은 게 큰 장점입니다.
5. 직접 측정해보기 — Queue·Table과 Service Bus·Cosmos DB 비교
지금까지는 각 서비스가 어떻게 동작하는지 봤습니다. 이번엔 직접 측정하면서, Queue와 Table이 어떤 지점에서 아쉬운지, 그리고 상위 서비스(Service Bus, Cosmos DB)가 그 지점을 어떻게 달리 처리하는지 같은 조건에서 비교해봅니다. 두 가지를 봅니다.
- 5-1 Queue 팬아웃(1→N) — Service Bus 토픽과 비교
- 5-2 Table 키가 아닌 속성으로 조회 — Cosmos DB for Table과 비교
먼저 밝혀둘 점: 측정 중 Queue나 Table이 오류를 내며 멈추거나 실패한 적은 없었습니다. 확인하려는 건 “어디서 깨지는가”가 아니라 “어떤 부분에서 상위 서비스와 차이가 나는가” 입니다.
5-1. 팬아웃(1 → N) — Queue와 Service Bus 토픽 비교
팬아웃(fan-out) 은 하나의 입력이 여러 곳으로 퍼져 나가는 것, 즉 한 메시지를 여러 서비스가 각자 받아야 하는 상황을 말합니다(입력 1개, 받는 곳 N개라서 “1 → N”이라고도 합니다). 발행/구독(Pub/Sub)과 거의 같은 뜻으로 쓰입니다.
         ->재고 서비스
주문 1건 ->알림 서비스
         ->정산 서비스
         ->분석 서비스
Queue에는 이런 팬아웃 상황에서 드러나는 구조적 차이가 있습니다.
먼저 짚어둘 점이 있습니다. 받는 쪽이 하나의 서비스인 일반적인 사용(예: 결제 작업을 결제 워커들이 가져가 처리)에서는 이 차이가 문제 되지 않습니다. 생산자는 큐 이름만 알면 되고, 워커가 몇 대로 늘어나든 생산자 코드는 그대로입니다. Queue Storage가 원래 잘 맞는 용도입니다. 아래에서 보는 부담은 한 메시지를 여러 서비스가 각자 받아야 할 때만 생깁니다.
시나리오: 주문 1건이 발생하면 재고·알림·정산·분석 4개 서비스가 모두 그 주문을 받아야 합니다. 이걸 하루 수만 건 규모로 돌린다고 해봅시다.
Queue Storage 방식 — 토픽이 없으므로, 생산자가 소비자 수만큼 큐를 만들고 메시지를 4번 복제 전송해야 합니다. (loadtest_fanout_queue.py)
import os
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed
from azure.storage.queue import QueueClient

CONN = os.environ["AZURE_STORAGE_CONNECTION_STRING"]
CONSUMERS = ["inventory", "notify", "settlement", "analytics"]
ORDERS = 500
WORKERS = 32
REQUEST_TIMEOUT = 10

_local = threading.local()


def get_clients():
    if not hasattr(_local, "clients"):
        _local.clients = {
            name: QueueClient.from_connection_string(
                CONN, f"fanout-{name}",
                retry_total=1,
            )
            for name in CONSUMERS
        }
    return _local.clients

_progress = {"done": 0}
_lock = threading.Lock()

def setup():
    for name in CONSUMERS:
        q = QueueClient.from_connection_string(CONN, f"fanout-{name}")
        try:
            q.create_queue()
        except Exception:
            pass
        try:
            q.clear_messages()
        except Exception:
            pass


def send_order(i: int):
    order = f"order-{i:06d}"
    clients = get_clients()
    sent = 0
    for name in CONSUMERS:
        clients[name].send_message(order, timeout=REQUEST_TIMEOUT)
        sent += 1
    with _lock:
        _progress["done"] += 1
        if _progress["done"] % 100 == 0:
            print(f"  ... {_progress['done']}/{ORDERS} 주문 처리됨")
    return sent


def main():
    print(f"[Queue 방식] 주문 {ORDERS}건 × 소비자 {len(CONSUMERS)}개 팬아웃")
    print("큐 준비 중...")
    setup()
    print("전송 시작 (Ctrl+C로 중단 가능)\n")

    start = time.time()
    total_sends = 0
    failed = 0
    try:
        with ThreadPoolExecutor(max_workers=WORKERS) as ex:
            futures = [ex.submit(send_order, i) for i in range(ORDERS)]
            for f in as_completed(futures):
                try:
                    total_sends += f.result()
                except Exception as e:
                    failed += 1
                    if failed <= 5:
                        print(f"  [전송 실패] {type(e).__name__}: {e}")
    except KeyboardInterrupt:
        print("\n중단됨. 현재까지 집계로 출력합니다.")

    elapsed = time.time() - start

    print("\n===== Queue 방식 결과 =====")
    print(f"주문 수              : {ORDERS}")
    print(f"소비자 수            : {len(CONSUMERS)}")
    print(f"실제 전송 트랜잭션 수 : {total_sends}  (= 주문 × 소비자)")
    if ORDERS:
        print(f"주문당 전송 배수      : {total_sends / ORDERS:.1f}배")
    print(f"전송 실패 건수        : {failed}")
    print(f"소요 시간            : {elapsed:.1f}초")
    if elapsed:
        print(f"전송 처리량          : {total_sends / elapsed:.0f} sends/s")

if __name__ == "__main__":
    main()
실행 결과:
Queue 팬아웃 결과
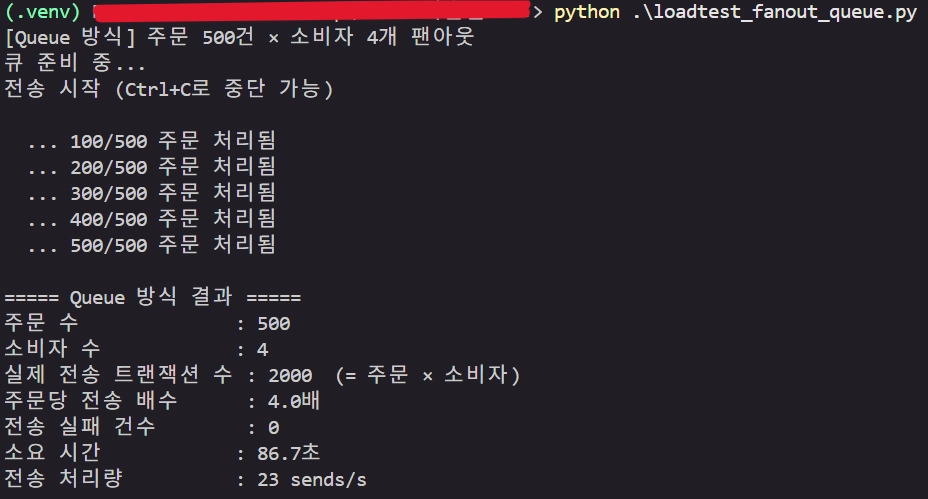
여기서 드러나는 구조적 부담이 세 가지입니다.
- 전송 트랜잭션이 소비자 수에 비례해 늘어남 — 주문 500건인데 전송은 2,000건(×4). 소비자가 늘수록 쓰기 비용이 그대로 배수로 늘어납니다.
- 팬아웃에서는 강한 결합 — 서비스마다 큐를 따로 두고 복제 전송해야 하므로, 생산자가 받는 서비스 목록(큐 이름)을 알고 있어야 합니다. 목록을 설정 파일로 빼면 부담이 줄지만, 전송이 소비자 수만큼 늘어나는 건 그대로입니다.
- 확장 시 생산자 수정 — 서비스를 하나 추가하려면 생산자의 전송 대상도 늘려야 합니다.
Service Bus 토픽 방식 — 토픽에 한 번만 발행하면 브로커가 각 구독으로 복제본을 전달합니다.(loadtest_fanout_servicebus.py)
import os
import time
import threading
import atexit
from concurrent.futures import ThreadPoolExecutor, as_completed
from azure.servicebus import ServiceBusClient, ServiceBusMessage

CONN = os.environ["AZURE_SERVICEBUS_CONNECTION_STRING"]
TOPIC = "order-events"
SUBSCRIPTIONS = ["inventory", "notify", "settlement", "analytics"]
ORDERS = 500
WORKERS = 32

_local = threading.local()
_all_clients = []
_all_clients_lock = threading.Lock()


def get_sender():
    if not hasattr(_local, "sender"):
        client = ServiceBusClient.from_connection_string(CONN)
        sender = client.get_topic_sender(topic_name=TOPIC)
        _local.client = client
        _local.sender = sender
        with _all_clients_lock:
            _all_clients.append((client, sender))
    return _local.sender

def _cleanup():
    for client, sender in _all_clients:
        try:
            sender.close()
        except Exception:
            pass
        try:
            client.close()
        except Exception:
            pass

atexit.register(_cleanup)

_progress = {"done": 0}
_lock = threading.Lock()

def publish_order(i: int):
    order = f"order-{i:06d}"
    get_sender().send_messages(ServiceBusMessage(order))
    with _lock:
        _progress["done"] += 1
        if _progress["done"] % 100 == 0:
            print(f"  ... {_progress['done']}/{ORDERS} 주문 발행됨")
    return 1

def verify_fanout():
    print("\n[검증] 각 구독이 독립적으로 메시지를 받았는지 확인")
    with ServiceBusClient.from_connection_string(CONN) as client:
        for sub in SUBSCRIPTIONS:
            receiver = client.get_subscription_receiver(
                topic_name=TOPIC, subscription_name=sub, max_wait_time=5
            )
            with receiver:
                msgs = receiver.peek_messages(max_message_count=3)
                print(f"  - {sub:10s} 구독 대기 메시지(peek) 예시: "
                      f"{[str(m) for m in msgs][:3]}")

def main():
    print(f"[Service Bus 방식] 주문 {ORDERS}건 → 토픽 1회 발행, 구독 {len(SUBSCRIPTIONS)}개 수신")
    print("발행 시작 (Ctrl+C로 중단 가능)\n")

    start = time.time()
    total_publishes = 0
    failed = 0
    try:
        with ThreadPoolExecutor(max_workers=WORKERS) as ex:
            futures = [ex.submit(publish_order, i) for i in range(ORDERS)]
            for f in as_completed(futures):
                try:
                    total_publishes += f.result()
                except Exception as e:
                    failed += 1
                    if failed <= 5:
                        print(f"  [발행 실패] {type(e).__name__}: {e}")
    except KeyboardInterrupt:
        print("\n중단됨. 현재까지 집계로 출력합니다.")

    elapsed = time.time() - start

    print("\n===== Service Bus 방식 결과 =====")
    print(f"주문 수              : {ORDERS}")
    print(f"구독 수              : {len(SUBSCRIPTIONS)}")
    print(f"실제 발행 트랜잭션 수 : {total_publishes}  (= 주문 수, 구독 수와 무관)")
    if ORDERS:
        print(f"주문당 발행 배수      : {total_publishes / ORDERS:.1f}배")
    print(f"발행 실패 건수        : {failed}")
    print(f"소요 시간            : {elapsed:.1f}초")
    if elapsed:
        print(f"발행 처리량          : {total_publishes / elapsed:.0f} publishes/s")

    verify_fanout()

if __name__ == "__main__":
    main()
실행 결과:
Service Bus 팬아웃 결과
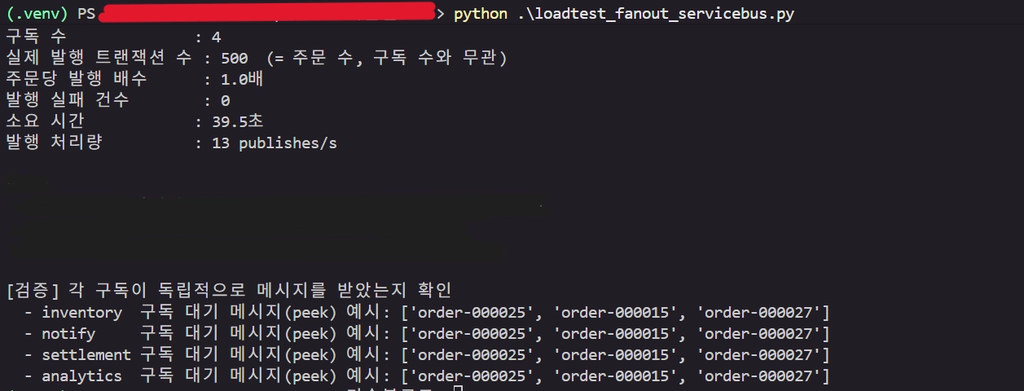
같은 조건 비교 (주문 500건, 소비자/구독 4개):
| Queue Storage | Service Bus 토픽 | |
|---|---|---|
| 필요한 쓰기 트랜잭션 | 2,000건 (×4) | 500건 (×1) |
| 생산자가 소비자를 아는가 (팬아웃 시) | 알아야 함 (강결합) | 몰라도 됨 (분리) |
| 소비자 추가 비용 (팬아웃 시) | 생산자의 전송 대상 추가 | 구독만 추가 |
| 쓰기 트랜잭션 비용 | 소비자 수에 비례 증가 | 일정 |
결론: 팬아웃은 Queue Storage로도 할 수는 있지만, 소비자가 늘수록 전송 비용이 배수로 증가하고 생산자-소비자가 강하게 묶입니다. 소비자 4개면 쓰기가 4배, 10개면 10배입니다. 반대로 받는 쪽이 하나의 서비스라면 Queue Storage로 충분하고, 한 메시지를 여러 서비스가 각자 받아야 하는 순간이 Service Bus 토픽으로 넘어가야 할 때입니다.
참고: Service Bus 토픽은 구독이 있어야 메시지가 보관됩니다. 구독이 하나도 없으면 발행된 메시지는 그냥 사라지므로, 구독을 먼저 만든 뒤 발행해야 합니다. Queue Storage(넣으면 무조건 쌓임)와 다른 점입니다.
5-2. 키가 아닌 속성으로 조회하기 — Table Storage와 Cosmos DB 비교
Table Storage에서 신경 써야 할 또 하나는 쿼리입니다. PartitionKey/RowKey로 조회하면 빠르지만, 그 외 속성으로 필터하면 테이블 전체를 훑습니다. 데이터가 쌓일수록 선형으로 느려집니다.
여기서도 Queue→Service Bus와 똑같은 비교 구도가 나옵니다. Table→Cosmos DB입니다. 둘이 같은 SDK(azure-data-tables)를 사용하며, 코드는 그대로, 연결 문자열만 바꾸면 됩니다.
# 같은 코드, 연결 문자열만 다르다
storage = TableServiceClient.from_connection_string(STORAGE_CONN)   # Table Storage
cosmos  = TableServiceClient.from_connection_string(COSMOS_CONN)    # Cosmos DB for Table
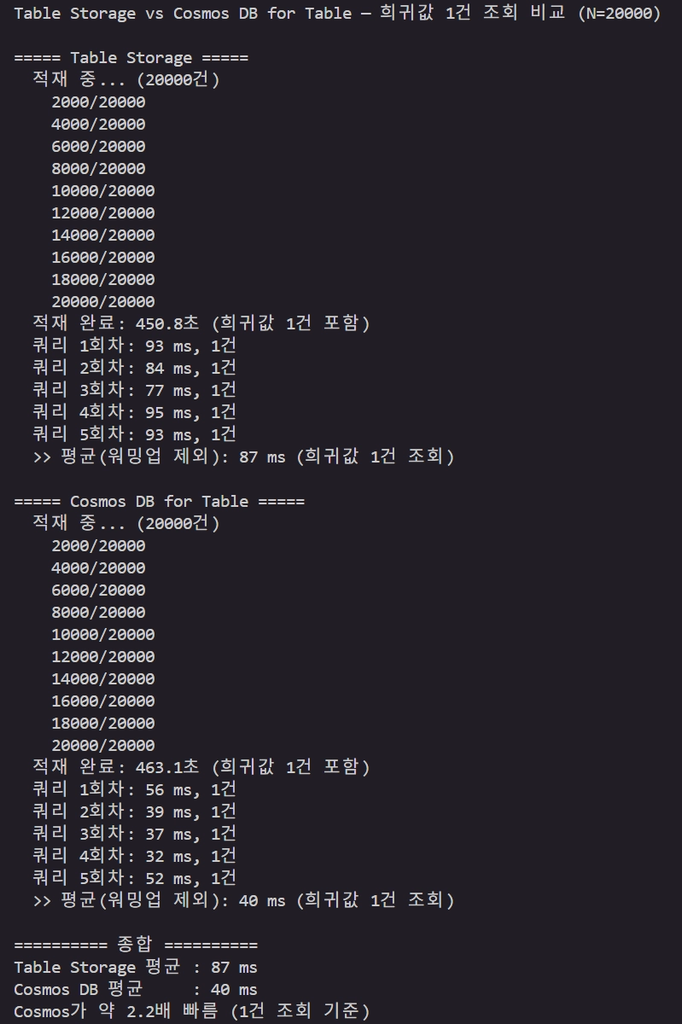
양쪽에 동일한 주문 2만 건을 넣고, 그중 딱 1건에만 심어둔 희귀값을 키가 아닌 속성으로 조회해 응답 시간을 비교합니다. 결과가 1건뿐이라 네트워크 전송 시간은 양쪽이 같고, 순수하게 “2만 건 중 그 1건을 찾는 시간”만 드러납니다. (loadtest_table_vs_cosmos.py)
import os
import time
import uuid
import random
from azure.data.tables import TableServiceClient
from azure.core.exceptions import HttpResponseError

STORAGE_CONN = os.environ["AZURE_STORAGE_CONNECTION_STRING"]
COSMOS_CONN = os.environ["AZURE_COSMOS_TABLE_CONNECTION_STRING"]

TABLE_NAME = "OrderCompare"
N = 20000
CATEGORIES = ["food", "book", "toy", "cloth", "tech"]
RARE_TAG = "NEEDLE"       # 2만 건 중 딱 1건에만 심는 희귀값
QUERY_ROUNDS = 5

def get_table(conn):
    svc = TableServiceClient.from_connection_string(conn)
    try:
        svc.delete_table(TABLE_NAME)
    except Exception:
        pass
    for _ in range(30):
        try:
            return svc.create_table_if_not_exists(TABLE_NAME)
        except HttpResponseError as e:
            if "TableBeingDeleted" in str(e):
                time.sleep(2)
                continue
            raise
    raise RuntimeError("테이블 삭제 대기 시간 초과")

def seed(table, n):
    print(f"  적재 중... ({n}건)")
    t0 = time.time()
    needle_at = random.randint(0, n - 1)    # 이 인덱스 1건만 희귀값
    for i in range(n):
        entity = {
            "PartitionKey": f"orders-{i % 100}",
            "RowKey": str(uuid.uuid4()),
            "Category": random.choice(CATEGORIES),
            "Amount": random.randint(1000, 50000),
            "RareTag": RARE_TAG if i == needle_at else "none",
        }
        table.upsert_entity(entity)
        if (i + 1) % 2000 == 0:
            print(f"    {i + 1}/{n}")
    print(f"  적재 완료: {time.time() - t0:.1f}초 (희귀값 1건 포함)")

def query_needle(table):
    t0 = time.time()
    results = list(table.query_entities(f"RareTag eq '{RARE_TAG}'"))
    dt = time.time() - t0
    return dt, len(results)

def run(name, conn):
    print(f"\n===== {name} =====")
    table = get_table(conn)
    seed(table, N)
    times = []
    count = 0
    for r in range(QUERY_ROUNDS):
        dt, count = query_needle(table)
        times.append(dt)
        print(f"  쿼리 {r + 1}회차: {dt * 1000:.0f} ms, {count}건")
    stable = times[1:] if len(times) > 1 else times
    avg = sum(stable) / len(stable)
    print(f"  >> 평균(워밍업 제외): {avg * 1000:.0f} ms (희귀값 1건 조회)")
    return avg

def main():
    print(f"Table Storage vs Cosmos DB for Table — 희귀값 1건 조회 비교 (N={N})")
    storage_avg = run("Table Storage", STORAGE_CONN)
    cosmos_avg = run("Cosmos DB for Table", COSMOS_CONN)

    print("\n========== 종합 ==========")
    print(f"Table Storage 평균 : {storage_avg * 1000:.0f} ms")
    print(f"Cosmos DB 평균     : {cosmos_avg * 1000:.0f} ms")
    if cosmos_avg > 0:
        print(f"Cosmos가 약 {storage_avg / cosmos_avg:.1f}배 빠름 (1건 조회 기준)")

if __name__ == "__main__":
    main()
실행 결과(2만 건 중 1건 조회, 로컬에서 측정):
Table vs Cosmos 희귀값 1건 조회 비교
왜 이런 차이가 나나:
| Table Storage | Cosmos DB for Table | |
|---|---|---|
| 인덱싱 | PartitionKey/RowKey만 | 전 속성 자동 인덱싱 |
| 키가 아닌 속성으로 조회 | 전체 스캔 (데이터↑ → 느려짐) | 인덱스 사용 (일정하게 빠름) |
| 지연 SLA | 공식 SLA 없음 (일반적으로 수십 ms 수준) | 읽기 10ms 미만, 쓰기 15ms 미만 |
| 비용 | 아주 저렴 | 비쌈(RU 예약/서버리스) |
핵심은 데이터가 많아질수록 격차가 벌어진다는 점입니다. Table의 전체 스캔은 건수에 비례해 느려지지만, Cosmos는 인덱스 덕분에 거의 일정합니다. 그리고 코드를 거의 안 바꾸고 갈아탈 수 있다는 게 Table→Cosmos 승급의 큰 장점입니다.
왜 이렇게 빠를까? 둘 다 같은 스키마리스 NoSQL처럼 보이지만, 내부 인덱싱 구조가 다릅니다.
- Table Storage는 PartitionKey/RowKey 두 개만 인덱싱합니다. 그래서 RareTag 같은 일반 속성으로 필터하면 전체 엔터티를 하나씩 훑어야 합니다(전체 스캔). 데이터가 많아질수록 선형으로 느려집니다.
- Cosmos DB는 모든 속성을 자동 인덱싱합니다. 어떤 속성으로 쿼리해도 인덱스로 바로 찾아가므로 데이터가 많아도 거의 일정하게 빠릅니다.
색인 없는 책을 처음부터 넘겨 찾는 것(Table) vs 책 뒤 색인을 보고 바로 펴는 것(Cosmos)의 차이입니다. 여기에 Cosmos는 전용 DB 엔진(SSD 기반, p99 한 자릿수 ms SLA)과 예약 처리량(RU)으로 성능을 보장한다는 점도 더해집니다. 물론 그 대가로 Table Storage보다 훨씬 비쌉니다.
그래서 어디에 쓰나 — 실무 사용처
| Table Storage | Cosmos DB for Table | |
|---|---|---|
| 한줄 성격 | 싸게 많이 쌓고 ID(키)로 꺼내는 보조 데이터 | 유연한 쿼리·저지연·글로벌이 필요한 핵심 데이터 |
| 대표 사용처 | IoT/센서 로그, 감사 로그, 사용자 설정·프로필, 세션 상태, 기능 플래그, 앱의 상태/메타데이터 | 전자상거래 상품 카탈로그(다속성 검색), 글로벌 서비스 사용자 데이터, 실시간 개인화·추천, 게임 리더보드, 대규모 실시간 재고 |
| 조회 방식 | PartitionKey/RowKey 중심 | 아무 속성으로나 유연하게 |
| 지연·범위 | 느슨, 다중 지역 분산 없음 | p99 한 자릿수 ms, 다중 지역 분산 있음 |
| 비용 | 아주 저렴 | 비쌈 |
선택 기준은 간단합니다. 조회를 키(ID)로 설계할 수 있으면 Table로 싸게 가고, 키가 아닌 속성으로 자주 검색하거나 전 세계 저지연이 필요하면 Cosmos로 올립니다.
참고로 Table은 쓰기 성능도 키 설계에 좌우됩니다. 같은 PartitionKey에 쓰기가 몰리면 그 파티션(파티션당 약 2,000 엔터티/초)이 병목이 되는 ‘핫 파티션’ 현상이 생깁니다. 다만 이 효과는 초당 수천 건 규모를 한 파티션에 몰아야 나타나므로, 로컬 머신에서 부하를 주면 네트워크 왕복이 먼저 병목이 되어 재현하기 어렵습니다. PartitionKey를 적절히 분산하는 설계 원칙만 기억하면 됩니다.
6. 비용 — 얼마나 절감되나 (규모로 환산)
Table/Queue의 가장 큰 매력은 비용입니다. 둘 다 종량제라 “안 쓰면 거의 0원, 쓴 만큼만 극소액”입니다. 과금은 두 축으로만 이루어집니다.
- 저장 용량: 대략 $0.045~0.075/GB/월 (중복 옵션에 따라 다름)
- 트랜잭션: 모든 API 호출 1건 = 트랜잭션 1건, 보통 1만 건당 센트 단위
반면 승급 대상인 Service Bus와 Cosmos DB는 과금 성격 자체가 다릅니다.
- Service Bus (Standard): 트래픽이 적어도 시간당 기본요금이 발생 (월 최소 비용 존재)
- Cosmos DB: 처리량(RU/s)을 예약하거나 서버리스(쓴 만큼)로 과금 — 성능·인덱싱 보장 대가로 Table Storage보다 훨씬 비쌈. (앞의 5-2 비교 데모도 서버리스 계정으로 수행)
시나리오 — 하루 10만 주문 커머스 (활성 고객 수만 명)
가정을 잡아봅니다.
- 하루 10만 주문 (월 약 300만 주문)
- 주문당 Queue 작업 3건(put/get/delete) → 월 약 900만 Queue 트랜잭션
- 주문당 Table 작업 insert 1 + 상태 조회 2 → 월 약 900만 Table 트랜잭션
- 저장 데이터: 주문 상태 테이블 수 GB 수준
아래 금액은 개념 비교용 근사치입니다. 리전(koreacentral)·중복 옵션·실제 트래픽에 따라 달라지므로, 정확한 값은 Azure 가격 계산기로 산정이 필요하므로 참고 부탁드립니다.
| 항목 | Queue + Table Storage | Service Bus + Cosmos DB |
|---|---|---|
| 메시징 기본요금 | 없음 (트랜잭션당 과금) | Service Bus Standard 시간당 기본요금 (월 고정비) |
| 데이터 저장/처리 | GB·트랜잭션 단가 (매우 저렴) | Cosmos RU 예약 또는 서버리스 (수 배~수십 배) |
| 월 비용 체감 | 월 수 달러 ~ 수십 달러 | 월 수십 ~ 수백 달러(처리량 예약 규모에 따라) |
| 프라이빗 연결 | 스토리지 계정에서 프라이빗 연결 구성 가능 | Service Bus는 프라이빗 엔드포인트 구성 시 Premium 계층 필수 |
이 규모에서 핵심은 트래픽이 두 서비스의 확장성 목표(단일 큐·파티션 2,000/초, 계정 20,000/초)에 한참 못 미친다는 점입니다. 하루 10만 주문은 평균 초당 1~2건, 피크를 10배로 잡아도 초당 수십 건이라, Queue/Table이 여유롭게 감당합니다. 즉 성능이 충분한데도 Service Bus/Cosmos를 쓰면, 쓰지 않아도 될 고정비·예약비를 더 내는 셈입니다.
그래서 절감 포인트
- 성능이 충분한 구간(대부분의 중소·중견 서비스)에서는 기본요금·예약비가 없는 Table/Queue가 더 저렴합니다.
- 승급은 “처리량이 모자라서”가 아니라, Pub/Sub·FIFO(Service Bus)나 유연한 쿼리·글로벌 저지연(Cosmos)이 꼭 필요할 때 그 기능값으로 지불하는 것입니다.
- 결론: 기능이 필요 없는데 비싼 서비스를 기본값으로 쓰지 말 것. 필요한 순간에만 승급하면 비용을 크게 아낄 수 있습니다.
7. 한눈에 요약 & 의사결정 가이드
| Queue Storage | Table Storage | |
|---|---|---|
| 역할 | 비동기 메시지 버퍼 | 저렴한 키-값 저장소 |
| 데이터 단위 | 메시지(≤64KB) | 엔터티(PartitionKey+RowKey) |
| 대표 용도 | 작업 큐, 컴포넌트 분리 | 상태/메타데이터 저장, 대량 조회 |
| 한 단계 위 서비스 | Service Bus | Cosmos DB for Table |
간단한 결정 트리
- 컴포넌트를 비동기로 연결하거나 작업을 버퍼링하고 싶다 → Queue (순서·토픽·트랜잭션이 필요하면 Service Bus)
- 싸고 단순한 키-값을 저장·조회하고 싶다 → Table (저지연·글로벌·유연한 쿼리가 필요하면 Cosmos DB for Table)
둘 다 아주 저렴하고 바로 시작할 수 있다는 게 매력입니다. 거창한 메시징 브로커나 데이터베이스를 세우기 전에, 스토리지 계정 안에 이미 들어 있는 이 두 조연으로 충분히 많은 걸 만들 수 있습니다.
8. 마치며
“스토리지 계정 = Blob”이라는 인식에서 한 발 나와 보면, 같은 계정 안에 Queue와 Table이라는 가볍고 저렴한 도구가 숨어 있습니다. 작은 비동기 파이프라인, 상태 저장, 메타데이터 관리 같은 일이라면 이 둘만으로도 꽤 멀리 갈 수 있습니다.
승급이 필요한 순간은 보통 처리량이 모자라서가 아닙니다. 앞의 측정에서 봤듯이, Queue는 팬아웃(Pub/Sub)처럼 기능이 필요할 때 Service Bus로, Table은 키가 아닌 속성으로 자주 검색해야 할 때 Cosmos DB for Table로 넘어가게 됩니다. 그리고 비용 면에서도, 성능이 충분한 구간에서는 기본요금·예약비가 없는 Table/Queue가 더 저렴합니다.
실습에 쓴 리소스는 과금을 피하기 위해 정리합니다.
az group delete -n rg-tablequeue-demo --yes --no-wait참고 자료
- Azure Queue Storage client library for Python (Microsoft Learn)
- Azure Tables client library for Python (Microsoft Learn)
- Compare Azure Storage queues and Service Bus queues (Microsoft Learn)
- Azure Table storage vs Azure Cosmos DB for Table (Microsoft Learn)
- Scalability and performance targets for Queue Storage (Microsoft Learn)
- Scalability and performance targets for Table storage (Microsoft Learn)
- Azure Queues 가격 · Azure Tables 가격