
3줄 요약
- 복잡한 문서를 VLM에게 통째로 맡기면 틀리기보다 빠뜨리고, 빠뜨린 글자는 아무런 흔적을 남기지 않습니다.
- 글자를 찾는 일은 OCR에게, 고치는 일은 VLM에게 나눠 맡기면 작은 모델로도 큰 모델 못지않은 결과를 얻을 수 있습니다.
- 모델을 바꾸기 전에 입력 데이터의 품질과 단계별 모델 선택부터 점검하는 것이 먼저입니다.
들어가며
최근에 일본 건설 도면의 글자를 텍스트 데이터로 바꾸는 실험을 해 보게 되었습니다. 건설 도면 한 장에는 방 이름과 면적, 치수, 그리고 현장에서 색 펜으로 적은 메모까지 선 사이사이에 빽빽하게 들어 있어서, 사람이 봐도 한눈에 읽기 쉽지 않은 문서입니다.
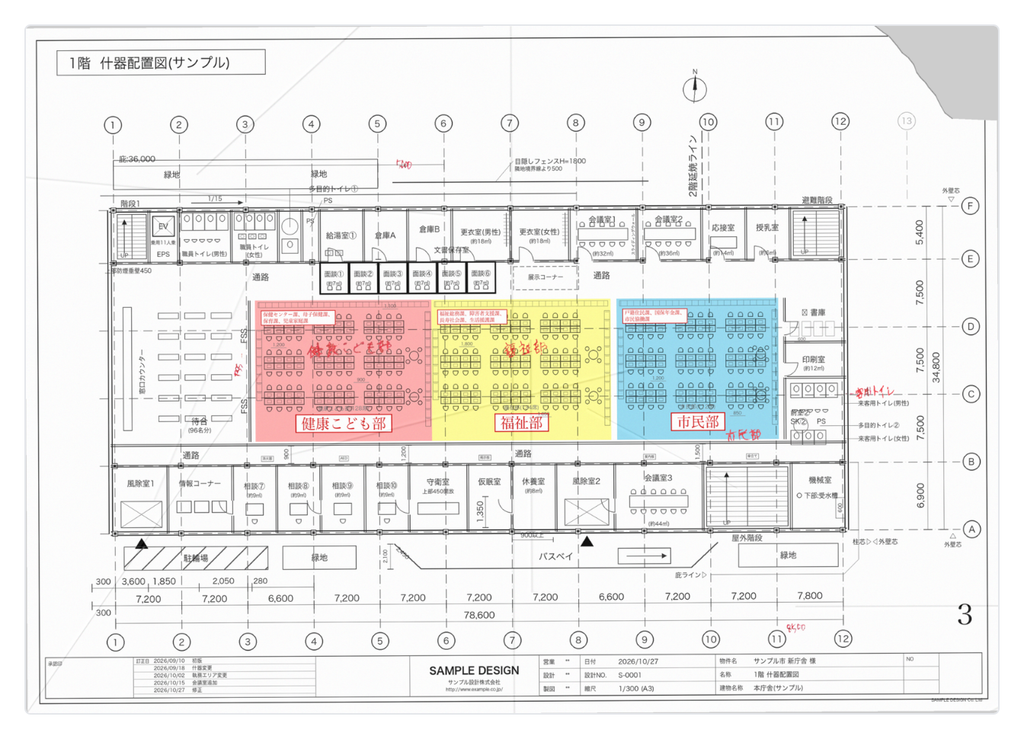
원본보다 선명하고 일부 내용이 다르지만, 본문의 실험 결과는 모두 원본 도면으로 측정한 값입니다.
처음에는 모델 성능만으로도 충분히 풀릴 거라고 기대했습니다. 시험 삼아 사업자등록증 등의 문서를 VLM에게 읽혀 봤더니, Claude 모델 중 가장 작은 Haiku도 주요 항목 24개 중 23개를 맞혔기 때문입니다.
그런데 같은 방식으로 도면을 넣자 결과가 완전히 달라졌습니다. Sonnet은 방 이름 59개 중 절반이 넘는 이름을 답에 아예 적지 않았는데, 잘못 읽은 것이 아니라 읽어야 할 글자를 통째로 빠뜨린 것이었습니다.
이 글은 그 빠뜨림 문제를 풀기 위해 OCR 모델과 VLM을 함께 쓰는 파이프라인을 만든 과정을 정리한 기록입니다. 먼저 OCR과 VLM을 각각 따로 써 보면서 어떤 한계가 있는지 확인하고, 두 모델을 합친 파이프라인의 구조를 살펴봅니다. 이어서 만들며 배운 세 가지를 정리하고, 마지막으로 아직 남은 숙제를 이야기하며 마무리하겠습니다.
1. OCR과 VLM은 무엇이 다른가
1-1. OCR이란
OCR(Optical Character Recognition)은 이미지 속에 있는 글자를 컴퓨터가 다룰 수 있는 텍스트로 바꿔 주는 기술입니다. 휴대폰 갤러리에서 영수증이나 와이파이 비밀번호 사진 속 글자를 꾹 눌러 복사해 본 적이 있다면, 이미 휴대폰에 내장되어 있는 OCR 기능을 써 보신 셈입니다.
OCR은 내부적으로 두 단계를 거칩니다. 먼저 텍스트 탐지 단계에서 이미지 안에서 글자가 있는 자리를 찾아 좌표 상자(bounding box)를 만들고, 이어서 텍스트 인식 단계에서 그 상자 안의 글자를 읽어 텍스트로 바꿉니다. 그래서 OCR의 결과물에는 글자뿐 아니라 그 글자가 어디에 있었는지를 알려 주는 위치 정보가 함께 담기는데, 이 위치 정보가 뒤에서 파이프라인을 만들 때 중요한 역할을 합니다.
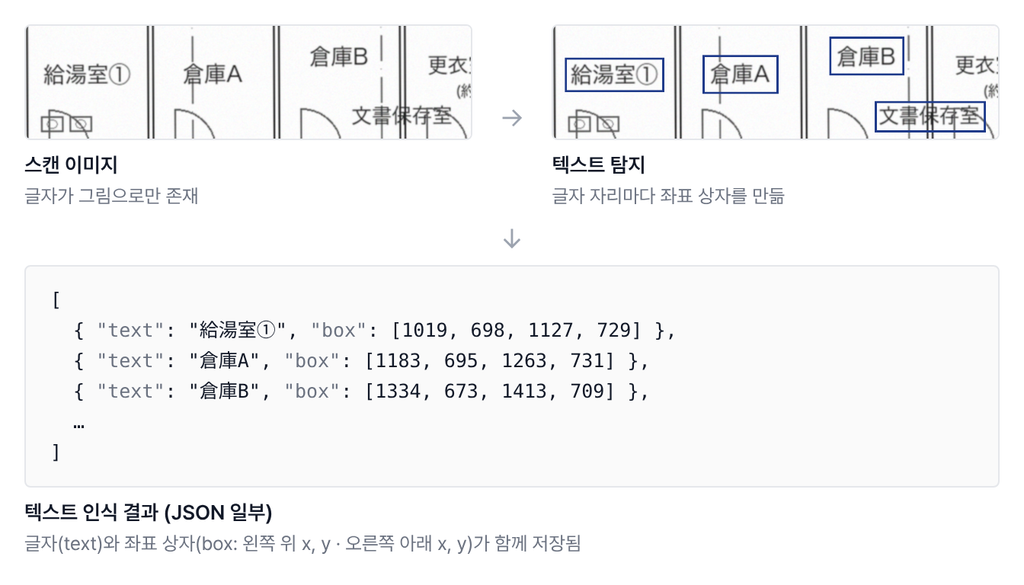
주의: 드래그해서 글자가 선택되는 PDF는 OCR 대상이 아닙니다. 이런 파일에는 이미 텍스트 데이터가 들어 있어서 그대로 꺼내 쓰면 되고, OCR이 필요한 것은 스캔본처럼 글자가 그림으로만 존재하는 파일입니다.
1-2. OCR 구현 방식
OCR을 구현하는 방법은 OCR 전용 서비스나 모델을 쓰는 방식, VLM에게 이미지를 직접 읽히는 방식, 그리고 두 가지를 함께 쓰는 하이브리드 방식으로 나눌 수 있습니다. 각 방식의 특징을 정리하면 다음과 같습니다.
| 방식 | 예 | 강점 | 약점 |
|---|---|---|---|
| OCR 서비스 · 모델 | Amazon Textract, PP-OCRv6 | 같은 입력에 같은 답, 위치 제공 | 지원 언어가 한정적, 학습 밖 글자에 약함 |
| VLM 단독 | Bedrock의 Claude, GPT | 문맥 이해, 손글씨, 여러 언어 | 위치 없음, 빠뜨림, 매번 다른 답 |
| 하이브리드 | 이 글의 파이프라인 | 빠뜨림이 적고 위치 유지 | 단계가 늘고 VLM 비용이 듦 |
여기서 VLM(Vision Language Model)은 이미지를 함께 이해할 수 있는 언어 모델을 말하며, 이 글에서는 Claude 모델을 중심으로 다룹니다. 표에서 보듯 OCR은 위치를 정확히 알려 주는 대신 처음 보는 글자에 약하고, VLM은 문맥을 이해하는 대신 위치 정보가 없고 글자를 빠뜨리기도 합니다.
정리하자면, OCR은 글자의 자리를 찾는 데, VLM은 글자의 뜻을 읽는 데 강합니다.
2. 따로 써 보니: OCR과 VLM의 한계
2-1. OCR 서비스는 정확하지만 지원 언어가 제한적
먼저 AWS의 OCR 서비스인 Amazon Textract로 월마트 영수증 스캔본을 읽혀 봤습니다. 35개 항목 중 34개를 맞혔는데, 틀린 1개도 숫자 0과 알파벳 O를 헷갈린 경우로 Textract 스스로도 신뢰도를 낮게 매긴 항목이었고, 5번을 돌려도 5번 모두 같은 답이 나올 만큼 결과가 안정적이었습니다.
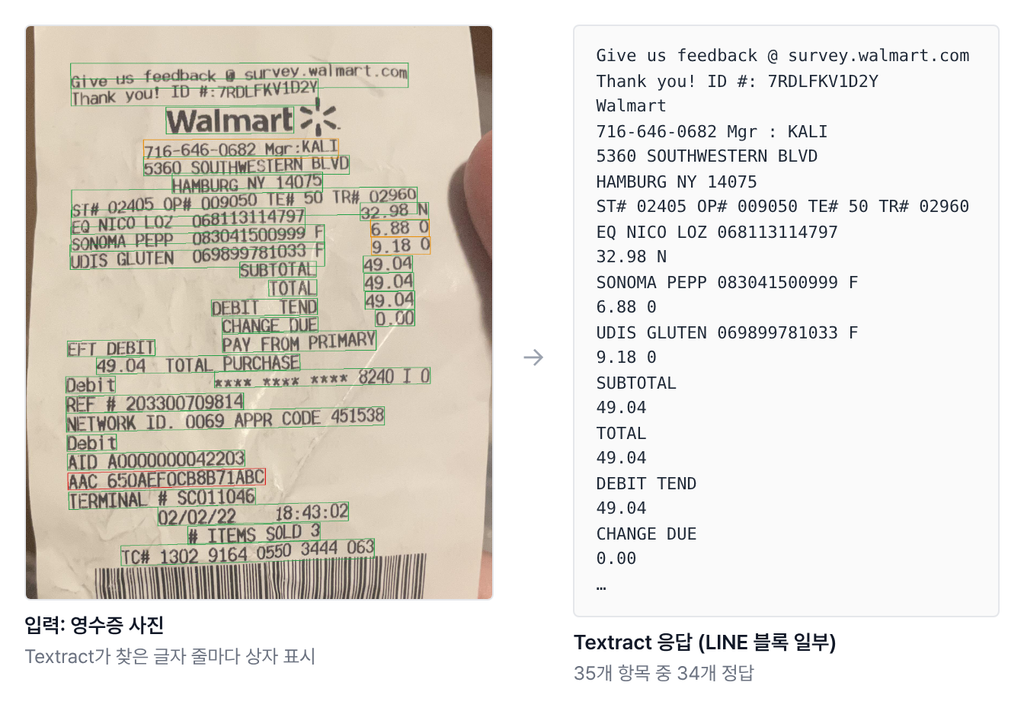
다만 Textract는 영어, 독일어, 프랑스어, 스페인어, 이탈리아어, 포르투갈어까지 6개 언어만 지원하기 때문에, 한국어나 일본어로 된 문서에는 쓸 수 없다는 한계가 있습니다.
2-2. 오픈소스 OCR 중 가장 좋은 결과도 86%에 머물렀습니다
그래서 다국어를 지원하는 오픈소스 OCR 모델들을 비교해 봤습니다. 대부분의 기업이 비용을 줄이고 싶어 한다는 점을 고려해 무료로 쓸 수 있는 모델을 중심으로 골랐고, 이전 PoC에서 만든 평가용 도면 1장의 정답 79항목(글자 52개 · 치수 27개)을 기준으로 각 모델의 성능을 검증했습니다. 이 글의 실험 도면과는 다른 도면입니다.
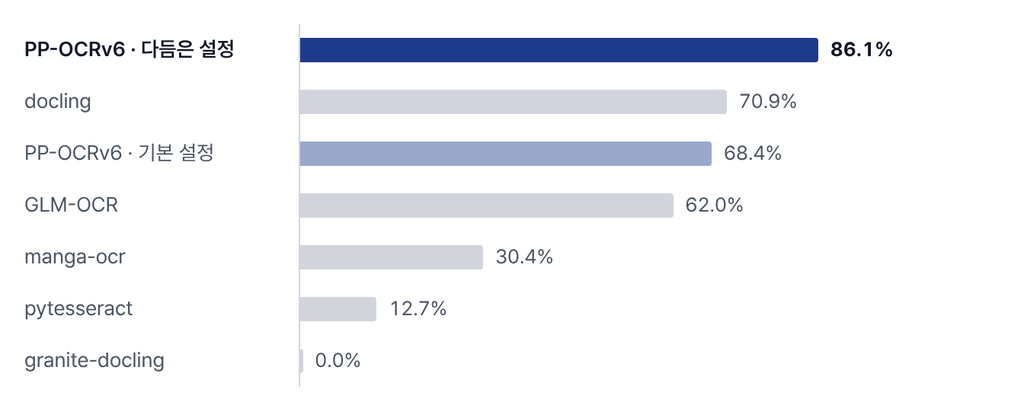
상업적으로 쓸 수 있는 모델 중 가장 높은 점수를 낸 것은 PaddleOCR의 경량 모델인 PP-OCRv6였습니다. Apache 2.0 라이선스로 공개되어 있고 노트북 CPU에서도 돌아가는 가벼운 모델인데, 기본 설정에서는 68.4%였지만 설정을 다듬어 86.1%까지 끌어올릴 수 있었습니다.
하지만 86%라는 정확도로는 실무에 그대로 투입하기 어려웠고, 틀린 사례를 살펴보니 크게 세 가지 유형이 있었습니다.
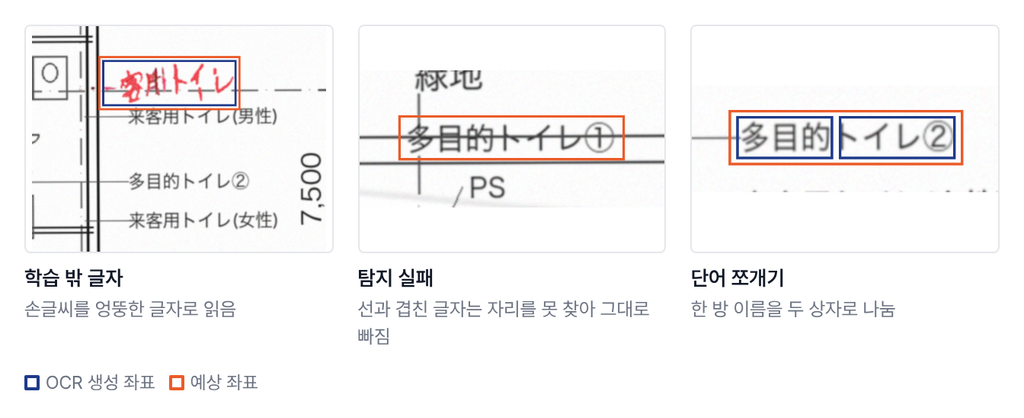
- 학습 범위 밖의 글자: 손글씨처럼 모델이 학습하지 못한 모양의 글자는 다른 글자로 읽어 버렸습니다. 예를 들어 손글씨 “客用トイレ”를 “用ト化”로 읽었습니다.
- 탐지 단계의 실패: 선과 겹친 글자는 아예 자리를 찾지 못해서, 읽어 보기도 전에 그대로 놓쳤습니다.
- 단어 쪼개기: 하나의 방 이름을 두 조각으로 나눠 인식하는 바람에 뜻이 통하지 않는 글자가 만들어졌습니다.
이런 한계를 보면서, 복잡한 문서에서는 OCR만으로는 부족하고 그림과 문맥을 함께 보는 단계가 필요하다고 판단했습니다.
2-3. 정형화된 문서라면 작은 VLM으로도 충분합니다
다음으로 VLM에게 직접 문서를 읽혀 봤습니다. 사업자등록증처럼 칸과 항목이 정해진 문서는 별도의 파이프라인 없이 VLM 하나만으로도 충분히 정확하게 읽을 수 있었습니다.
| 모델 | 주요 항목 (/24) | 틀린 글자 비율 | 틀린 곳 | 장당 비용 |
|---|---|---|---|---|
| Haiku 5.5 | 23 | 1.8% | 기계장비 → 기계창비 (불확실 표시) | $0.001 |
| Sonnet 5.5 | 23 | 0.4% | 건조룸 → 건소롬 (불확실 표시) | $0.011 |
| Opus 5.5 | 24 | 0.0% | 없음 | $0.038 |
흥미로운 점은 Haiku와 Sonnet 모두 틀린 곳에 스스로 ‘확실하지 않음’이라는 표시를 남겼다는 것입니다. 덕분에 사람은 문서 전체를 다시 볼 필요 없이, 표시된 곳만 확인하면 됩니다.
2-4. 하지만 도면에서는 VLM이 틀리기보다 빠뜨렸습니다
그런데 같은 VLM에 도면을 넣자 전체 94항목 중 63.8~69.1%만 맞혔습니다. 특히 면적 표기는 20개 중 1~4개만 답에 적었을 정도로 결과가 좋지 않았습니다.
틀린 내용을 하나씩 나눠 보니 원인이 보이기 시작했습니다. 방 이름 59개를 기준으로 세 모델을 각각 5번씩 돌려, 잘못 읽은 이름과 아예 적지 않은 이름을 따로 세어 봤습니다.
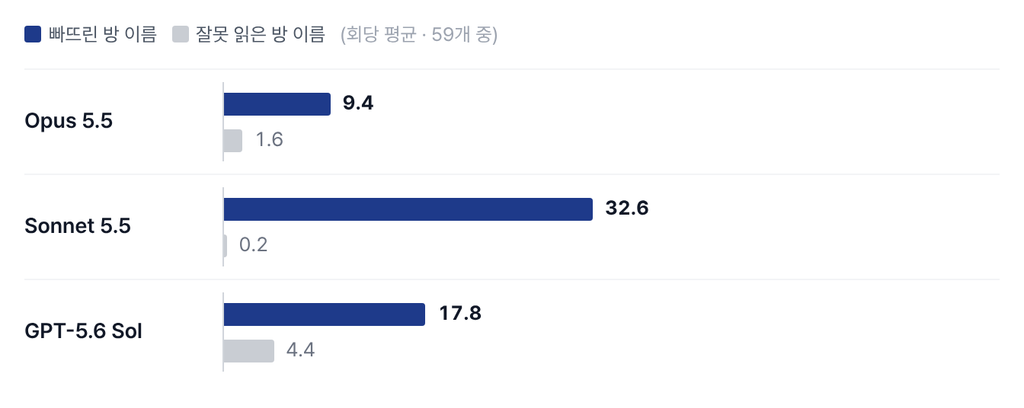
결과는 세 모델 모두 같은 방향을 가리켰습니다. 잘못 읽은 이름보다 빠뜨린 이름이 훨씬 많았고, Sonnet의 경우 회당 32.6개, 즉 절반이 넘는 방 이름을 빠뜨렸습니다.
빠뜨림이 잘못 읽은 글자보다 곤란한 이유는 흔적이 남지 않기 때문입니다. 잘못 읽은 글자에는 ‘확신 낮음(low)’ 표시라도 붙어 있어서 나중에 찾아 고칠 수 있지만, 빠뜨린 글자는 처음부터 답에 없으니 무엇이 빠졌는지조차 추적하기 어렵습니다.
2-5. 답이 잘린 것이 아니라, 모델이 스스로 끝낸 것이었습니다
처음에는 출력 한도에 걸려서 답이 중간에 잘린 것이라고 생각했습니다. 그런데 실행 기록을 확인해 보니 사정이 달랐습니다. Sonnet은 다섯 번 모두 50~63개 항목만 적고 답을 마쳤는데, 같은 도면에서 Opus가 172~207개 항목을 적은 것과 비교하면 차이가 큽니다.
출력도 1,515~1,965토큰으로 한도인 32,000토큰의 6%도 쓰지 않았고, 종료 사유는 다섯 번 모두 end_turn이었습니다. 모델이 스스로 다 적었다고 판단하고 멈춘 것입니다. 다시 말해 “보이는 글자를 모두 적어라”라고 지시하더라도, 실제로 어디까지 적을지는 모델이 스스로 정해 버린다는 뜻입니다.
정리하면 VLM 단독은 틀리기보다 빠뜨리는 쪽이 문제이고, 틀린 글자는 표시라도 남지만 빠뜨린 글자는 아무런 흔적을 남기지 않습니다.
3. 파이프라인 구조
핵심: OCR이 먼저 글자의 자리를 찾고, VLM은 그 결과를 검토해 고치는 구조입니다. 손글씨만은 OCR을 거치지 않고 VLM이 바로 읽습니다.
파이프라인은 모두 20개 단계로 이루어져 있지만, 하나씩 따라가면 오히려 흐름이 잘 보이지 않습니다. 그래서 아래 그림처럼 OCR, 두 갈래의 VLM 검토, 병합, 사람의 검수라는 4단계로 묶어서 살펴보겠습니다.
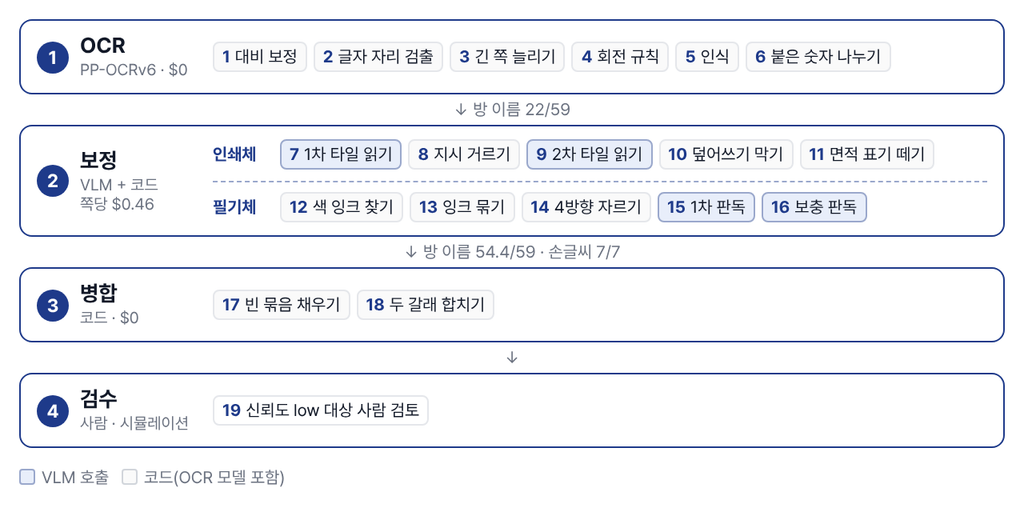
가장 먼저 OCR 단계에서는 PP-OCRv6가 도면에서 글자 자리 286개를 찾아 읽습니다. 별도의 비용 없이 수행 가능한데, 이때 OCR이 만든 좌표 상자를 코드 규칙으로 바로잡는 작업도 함께 합니다(자세한 내용은 5장에서 다룹니다). 다만 이 단계만으로 맞힌 방 이름은 59개 중 22개에 불과합니다.
다음 단계에서는 도면을 두 갈래로 나눠 동시에 처리합니다. 인쇄체 갈래에서는 Sonnet 5.5가 도면을 타일로 나눠 OCR 결과를 두 번 검토하는데, 이 과정을 거치며 방 이름이 22개에서 51.6개, 다시 54.4개로 늘어납니다. 필기체 갈래에서는 색 펜으로 쓴 잉크만 따로 떼어 낸 뒤 Opus 5.5가 손글씨만 읽는데, 손글씨 7줄을 5회 모두 정확히 읽어 냈습니다.
두 갈래의 결과는 코드로 합치기 때문에 이 단계에는 추가 비용이 들지 않습니다. 마지막으로 VLM이 스스로 자신 없다고 표시한 곳을 사람이 확인하면서 파이프라인이 끝납니다. 이렇게 해서 얻은 최종 결과는 방 이름 54.4/59, 손글씨 7/7이고, VLM 비용은 두 갈래를 합쳐 쪽당 $0.46입니다.
다만 이 파이프라인은 건설 도면이라는 문서에 맞춰 고른 조합이라서, 문서가 바뀌면 켜고 끌 단계와 쓸 모델도 함께 바뀌어야 합니다.
4. 만들며 배운 세 가지
핵심: 모델을 바꾸기 전에 먼저 확인할 것이 세 가지 있습니다. 한 모델에게 너무 많은 일을 맡기지 않았는지, 입력 데이터가 충분히 좋은지, 그리고 단계마다 맞는 모델을 골랐는지입니다.
4-1. 각자 잘하는 일을 맡깁니다: OCR이 찾고, VLM이 고칩니다
앞에서 본 것처럼 OCR은 단어를 쪼개 인식하더라도 글자가 있는 자리만큼은 빠짐없이 찾아내고, VLM은 그 자리에 있는 글자를 보고 쪼개진 조각을 붙이거나 뜻에 맞게 고치는 일을 잘합니다. 두 모델의 강점이 정확히 반대쪽에 있는 셈입니다.
그래서 VLM에게 처음부터 모든 글자를 받아 적게 하는 대신, OCR이 찾은 글자와 위치를 함께 건네주고 그중 틀리거나 놓친 것만 답하게 했습니다. 아래 표는 같은 도면을 VLM 단독으로 읽혔을 때와 이 하이브리드 구성으로 읽혔을 때를 비교한 결과입니다.
| 모델 | 방 이름 정답률 (/59) | 빠뜨린 방 이름 (회당) | 쪽당 비용 (하이브리드) |
|---|---|---|---|
| Opus 5.5 | 81.0% → 92.9% (47.8 → 54.8개) | 9.4 → 1.6 (−83%) | $0.77 |
| Sonnet 5.5 | 44.4% → 92.2% (26.2 → 54.4개) | 32.6 → 2 (−94%) | $0.39 |
| GPT-5.6 Sol | 62.4% → 70.0% (36.8 → 41.3개) | 17.8 → 5.7 (−68%) | $1.14 |
표에서 화살표 왼쪽이 VLM 단독, 오른쪽이 하이브리드의 결과입니다. 세 모델 모두 빠뜨린 방 이름이 68~94% 줄었는데, 특히 Sonnet은 정답률이 44.4%에서 92.2%로 두 배 넘게 오르면서 Opus와 거의 같은 수준이 되었습니다.
한 모델에게 글자를 찾는 일과 읽는 일을 모두 맡기면 빠뜨림이 생깁니다. 찾는 일은 OCR에게, 고치는 일은 VLM에게 나눠 맡기는 것이 핵심입니다.
4-2. 좋은 입력이 좋은 결과를 만듭니다
흔히 쓰는 Garbage In, Garbage Out이라는 말을 뒤집으면, 좋은 입력이 들어가야 좋은 결과가 나온다는 뜻이 됩니다. 이번 파이프라인에서 입력을 다듬기 위해 한 일은 크게 세 가지였습니다.
① 텍스트 좌표 보정
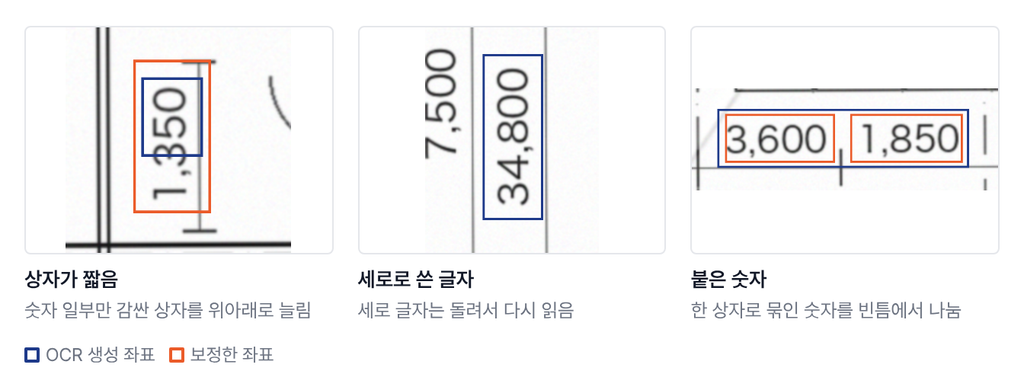
첫 번째는 OCR이 만든 좌표 상자를 VLM에 넘기기 전에 코드로 바로잡는 일이었습니다. 상자가 너무 좁게 잡히거나, 세로로 쓴 글자를 가로로 읽거나, 붙어 있는 숫자를 하나로 묶는 경우가 있었는데, 이런 문제는 VLM 없이 코드 규칙만으로도 충분히 고칠 수 있었습니다. 이전 측정(79항목)에서는 이 좌표 보정만으로 맞힌 항목이 54개에서 68개로 늘었고, 구체적인 사례는 다음과 같습니다.
| 문제 | 원인 | 해결 |
|---|---|---|
| 상자가 짧아 숫자 앞자리가 잘림 (1500 → 500) | 검출 상자가 세로로 너무 빠듯함 | 세로로 긴 상자는 위아래를 늘림 (286개 중 42개) |
| 세로로 쓴 치수를 잘못 읽음 (8,680 → 50) | 모든 상자를 가로(0°)로만 읽음 | 0°와 270°로 모두 읽고 점수가 높은 쪽을 고름 (105개) |
| 다른 수치가 한 상자로 묶임 (4,000 · 1,945) | 붙어 있는 글자를 한 상자로 검출 | 숫자 상자는 빈틈에서 나눔 (3개) |
② 한도 안 크기의 타일로 나누기
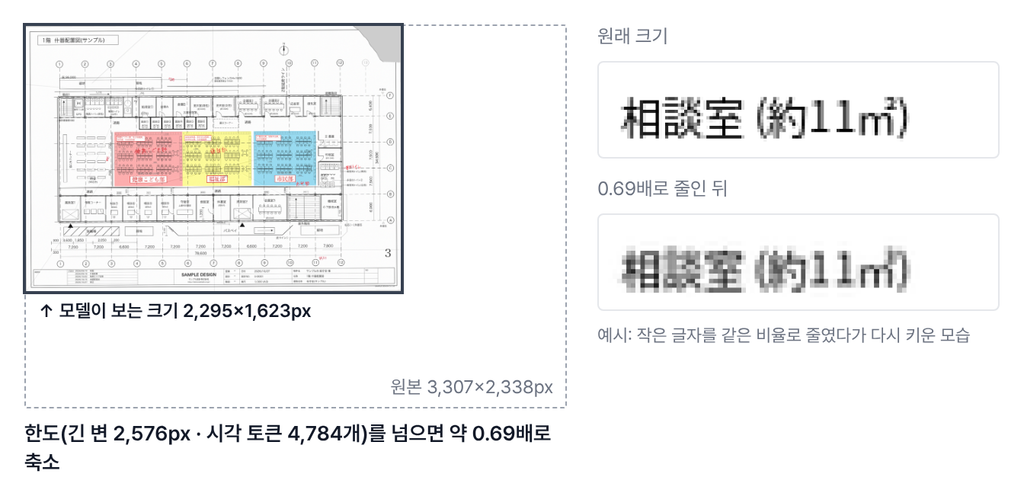
두 번째는 도면을 모델이 받아들일 수 있는 크기로 나눠 보내는 일이었습니다. Claude는 이미지의 긴 변이 2,576px을 넘거나 시각 토큰이 4,784개를 넘으면, 이미지를 스스로 줄여서 봅니다(Claude 4.7 이후 모델 기준). 여기서 시각 토큰은 이미지를 28×28px 크기의 조각으로 나눴을 때의 조각 개수로, 다음과 같이 계산합니다.
\text{시각 토큰} = \lceil \text{가로}/28 \rceil \times \lceil \text{세로}/28 \rceil이 도면의 원본은 3,307×2,338px이라 시각 토큰이 9,996개로 한도의 두 배쯤 됩니다. 그래서 통째로 보내면 모델은 가로·세로를 약 0.69배로 줄인 2,295×1,623px 크기의 그림을 보게 되는데, 공식 문서에서도 이렇게 축소하면 글자가 덜 읽힐 수 있다고 안내하고 있습니다.
그래서 도면을 가로 6개, 세로 5개, 모두 30개의 타일로 나눴습니다. 타일 하나는 평균 607×522px, 시각 토큰 약 414개라 한도 안에 들어가기 때문에, 원래 해상도 그대로 모델에게 전달됩니다. 이렇게 나눈 타일마다 그 타일에 해당하는 OCR 글자와 위치를 함께 보내고, 모델에게는 틀리거나 놓친 것만 답하도록 했습니다. 그 결과 타일 하나에 대한 답은 평균 145토큰으로 짧아졌습니다. 호출 수를 줄이려고 타일 여러 개를 한 번에 묶어 보내 보기도 했지만 오히려 정확도가 떨어졌기 때문에, 호출 수보다 답의 길이를 줄이는 쪽을 택했습니다.
한 가지 더 신경 쓴 부분은 타일 경계입니다. 경계에 걸친 글자는 양쪽 타일 어디에서도 온전하게 보이지 않기 때문에, 타일을 반 타일씩 밀어서 한 번 더 읽게 했습니다. 이렇게 두 번 검토한 결과 방 이름은 OCR만 썼을 때의 22개에서 1차 검토 뒤 51.6개, 2차 검토 뒤 54.4개로 늘었고, 2차 검토에서는 타일 경계에 걸려 있던 이름을 8건 더 맞혔습니다(5회 합계).
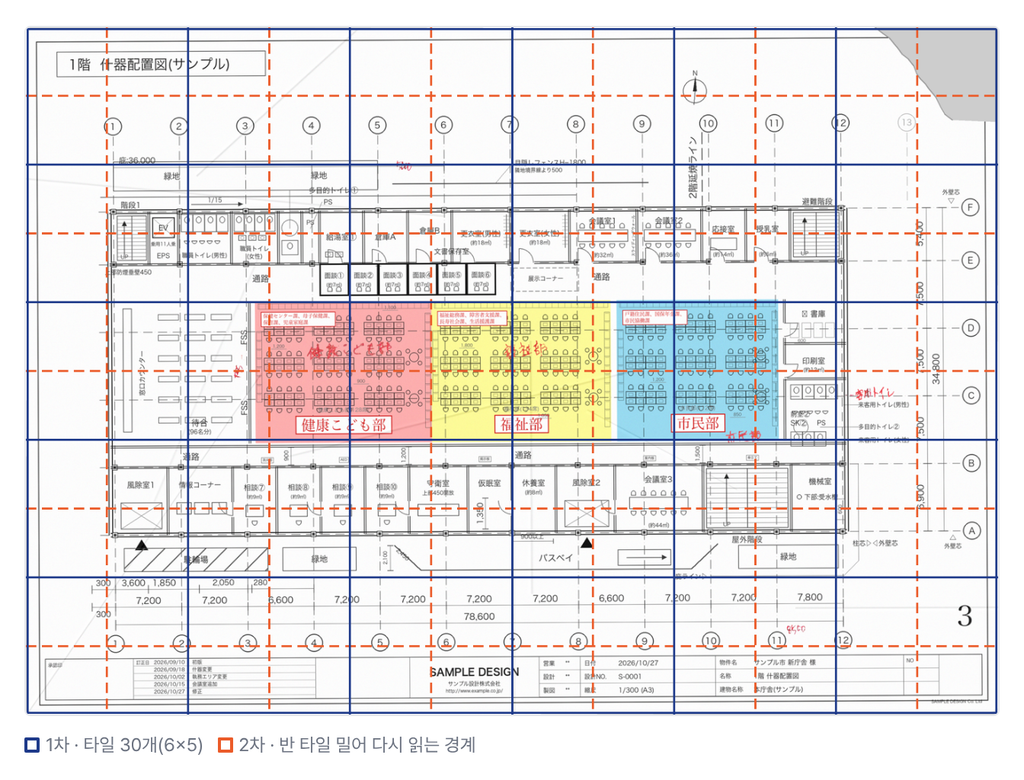
한 번 잘린 글자도 두 번째에는 타일 안에 온전하게 들어옵니다.
주의: 점수가 오른 데에는 OCR 결과를 함께 준 효과도 섞여 있어서, 이를 해상도 덕분이라고만 보기는 어렵습니다. 실제로 이 도면은 스캔 화질 자체가 거칠어서, 0.69배로 줄여도 눈에 띄는 차이가 크지 않았습니다.
③ 잉크 색으로 손글씨 분리하기
세 번째는 손글씨를 도면에서 따로 떼어 내는 일이었습니다. 건설 도면은 선과 글자가 빽빽해서 현장에서는 메모를 할 때 색이 있는 펜을 쓰는 관행이 있는데, 이 점을 활용했습니다. 글자 모양으로 손글씨를 알아보는 것이 아니라 펜 색으로 구분하는 방식이라서, 검은 펜으로 쓴 손글씨는 이 방법으로 떼어 낼 수 없습니다. 먼저 빨강·파랑·초록 잉크만 남기고(코드로 처리해 비용은 $0입니다), 이어진 잉크 덩어리를 묶음 8개로 나눈 다음, 묶음마다 4방향으로 돌려 VLM이 손글씨만 읽도록 했습니다.
그 결과 OCR이 “用ト化”로 잘못 읽었던 손글씨를 VLM은 “客用トイレ”로 바르게 읽었고, Opus는 손글씨 7개를 5회 모두 정확히 맞혔습니다.
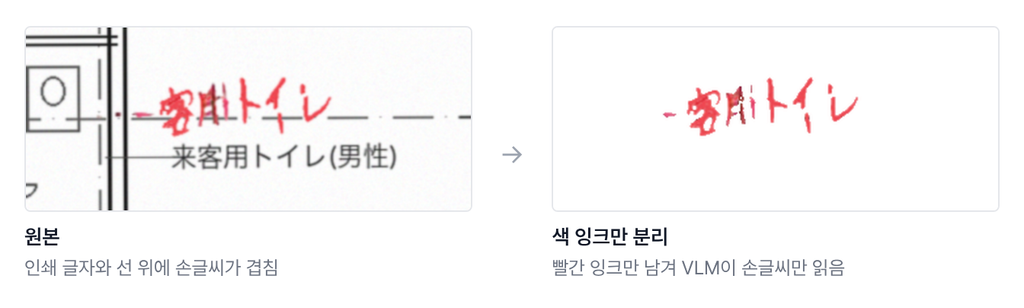
실험에서는 OCR이 “用ト化”로 읽은 손글씨를 VLM이 “客用トイレ”로 바르게 읽었습니다.
입력을 다듬는 일은 대부분 코드로 처리할 수 있어서 비용이 거의 들지 않는데, 그 효과는 모델을 바꾸는 것보다 오히려 컸습니다.
4-3. 프론티어 모델이 늘 답은 아닙니다
마지막으로 모델 선택입니다. 인쇄체 갈래를 Sonnet과 Opus로 똑같은 조건에서 돌려 봤는데, effort(모델이 답하기 전에 생각하는 양)도 둘 다 low로 맞췄습니다.
| 항목 | Sonnet 5.5 | Opus 5.5 | 차이 |
|---|---|---|---|
| 방 이름 (/59) | 54.4 | 54.8 | 거의 같음 |
| 출력 토큰 | 8,715 | 8,063 | 거의 같음 |
| 시간 (쪽당) | 21초 | 31초 | 1.5배 |
| 비용 (쪽당) | $0.32 | $0.64 | 2배 |
결과를 보면 방 이름은 평균 0.4개 차이로 사실상 같았고, 출력 토큰도 8천 개 안팎으로 비슷했습니다. 즉 Opus가 Sonnet보다 더 많이 생각한 것도 아닌데, 시간은 1.5배, 비용은 2배가 더 들었습니다.
그 이유는 두 가지입니다. 하나는 Opus가 더 큰 모델이라 토큰 하나를 만드는 데 계산이 더 필요하다는 점으로, 실제로 타일 하나를 처리하는 데 Sonnet은 1.8초, Opus는 2.9초가 걸렸습니다. 다른 하나는 단가 자체가 두 배라는 점입니다. 100만 토큰당 입력은 Sonnet $2, Opus $4이고, 출력은 각각 $10과 $20입니다.
반대로 손글씨에서는 결과가 달랐습니다. Opus는 손글씨 7개를 모두 맞혔지만 Sonnet은 6개에 그쳤습니다. 그래서 인쇄체는 Sonnet에게, 손글씨는 Opus에게 맡겼고, 이렇게 갈래마다 모델을 고르자 쪽당 VLM 비용이 Opus만 쓸 때의 $0.77에서 $0.46으로 줄었습니다(계산값).
큰 모델이 늘 더 나은 결과를 내는 것은 아니므로, 단계마다 정확도와 속도, 비용을 직접 재 보고 모델을 고르는 것이 중요합니다.
5. 아직 남은 숙제
핵심: 파이프라인을 완성했다고 해서 빠뜨림과 흔들림이 완전히 사라지지는 않으며, 마지막 확인은 여전히 사람의 몫으로 남아 있습니다.
먼저 아무도 읽지 못하는 자리가 있습니다. 스캔 해상도가 낮아서 사람이 봐도 알아보기 어려운 글자가 있고, 그래서 최종 결과에서도 방 이름 59개 중 4~5개는 여전히 남습니다.
또 돌릴 때마다 답이 조금씩 달라집니다. 같은 입력으로 다섯 번을 돌렸는데도 맞힌 방 이름이 55, 53, 53, 55, 56개로 매번 달랐고, 이번 구성에서는 무작위성을 조절하는 설정도 쓸 수 없었습니다.
마지막으로 VLM이 low로 표시한 곳은 결국 사람이 확인해야 합니다. 다만 이 표시를 믿을 수 있는 정도는 모델마다 달랐습니다. Sonnet은 틀린 11건 중 9건에 low를 붙였지만 GPT-5.6 Sol은 틀린 36건에 하나도 붙이지 않았기 때문에, 어느 모델의 표시를 기준으로 삼을지도 먼저 재 보아야 합니다. 같은 모델끼리 답을 대조하는 것도 한계가 있었습니다. Sonnet은 5회 모두 MWC를 WWC로 읽어서, 두 번 돌려 맞춰 봐도 ‘일치’로 그대로 통과했습니다. 반면 다른 모델과 답을 대조하면 방 이름이 57.8개까지 오르고 사람이 볼 자리도 36.3곳으로 줄지만, 두 모델을 모두 돌려야 해서 VLM 비용이 쪽당 $1.16으로 세 배 가까이 듭니다.
마치며
도면을 읽는 파이프라인을 만들며 얻은 결론은 세 가지입니다.
첫째, 문서의 종류가 OCR의 난이도를 정합니다. 정형화된 문서는 작은 VLM 하나로도 충분했지만, 도면처럼 복잡한 문서는 OCR과 VLM을 함께 써야 했습니다.
둘째, 기본은 바뀌지 않습니다. 좋은 입력을 준비하고, 단계마다 모델을 재서 고르고, 답을 짧게 받는 원칙은 새 모델이 나와도 그대로일 것입니다.
셋째, 사람의 역할은 남습니다. VLM은 매번 조금씩 다른 답을 내므로, 확신이 낮은 곳은 결국 사람이 확인해야 합니다.
이 글의 수치는 모델이 바뀌면 다시 재야 하지만, 역할을 나누고 입력을 다듬고 직접 재서 고르는 순서는 크게 바뀌지 않을 것입니다.
참고 자료
- 이미지 한도와 시각 토큰: Vision – Claude Docs
- OCR 서비스 지원 언어: Amazon Textract FAQ
- OCR 모델: PaddlePaddle/PaddleOCR (GitHub)