
한눈에 보기
골프 커머스 고객사 온라인몰에 붙는 AI 피팅 서비스를 103일(2026-02-09 ~ 2026-05-22) 동안 구축해 운영에 올렸습니다. 회원이 키·몸무게를 넣으면 스크린 골프 경기 데이터나 8문항 설문을 바탕으로 스윙을 분석하고, 드라이버·아이언·골프공을 추천하는 서비스입니다.
이 글은 그 과정에서 내린 결정과, 운영에 올리고 나서야 알게 된 지점들을 정리한 기록입니다.
| 항목 | 값 |
| 기간 | 2026-02-09 ~ 2026-05-22 (103일) |
| AgentCore Runtime | 2개 (피팅 coordinator · 골프공 recommender) |
| 에이전트 | 피팅 Coordinator 1 + Sub-agent 15 · 골프공 Coordinator 1 + Sub-agent 3 |
| 도구 | MCP Gateway 4개 → Lambda 4개 (python3.11 · 512MB · timeout 30초) |
| ECS Fargate (운영) | 서비스 5개 · 태스크 10개 |
| DB 프롬프트 | 13건 (tool 호출 끔 9 · 켬 4) |
| 코드 (인계 시점) | AgentCore Python 5,846행 · BFF Python 2,516행 · 프론트 JS/JSX 9,090행 |
화면 한 번을 따라가 보면
화면은 5단계이고, 경기 데이터가 있는 회원과 없는 회원(또는 게스트)으로 두 갈래가 나뉩니다. 어느 갈래든 추천 순위와 점수는 코드가 정하고, LLM은 그 결과를 설명합니다.
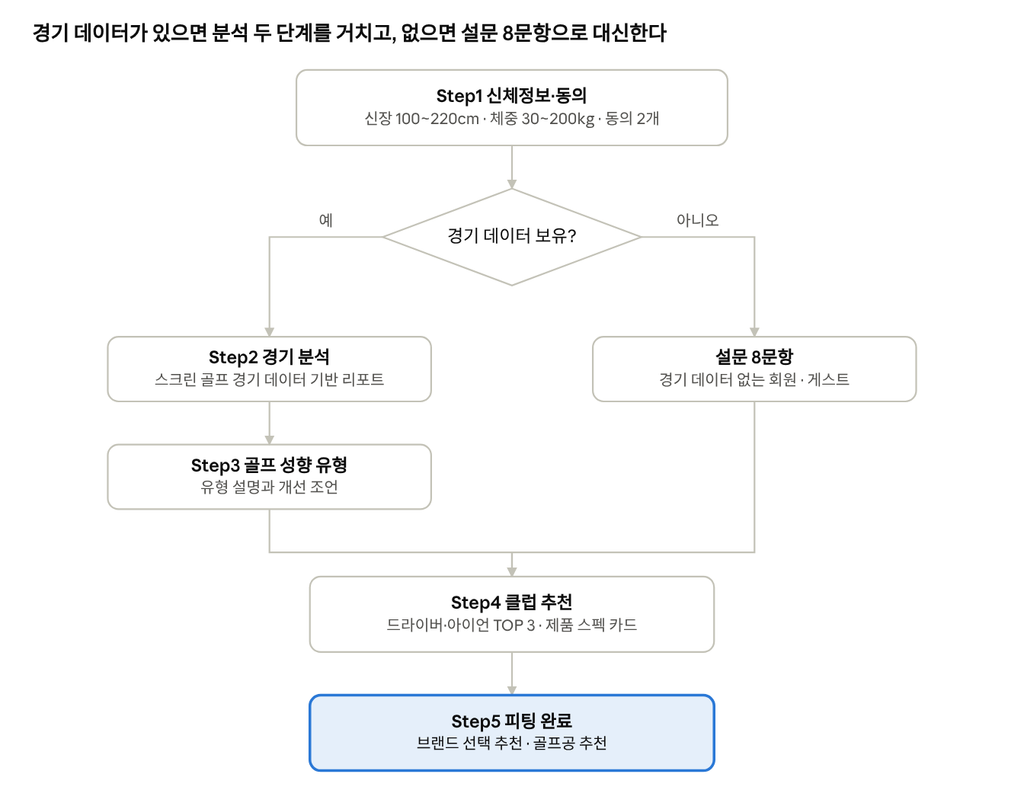
[ 화면 흐름 · 경기 데이터 유무로 갈리는 5단계 ]
경기 데이터가 있는 회원은 분석 두 단계를 거치고, 없는 회원과 게스트는 설문 8문항으로 대신합니다. 두 갈래는 Step4에서 다시 만납니다.
| 화면 결과 | 숫자·순위를 정하는 곳 | LLM이 하는 일 |
| Step2 경기 분석 | 고객사 경기 데이터 API 응답 | 경기 분석 리포트 (tool 호출 끔) |
| Step3 골프 성향 유형 | 경기 데이터의 성향 유형 코드 | 유형 설명과 개선 조언 (tool 호출 끔) |
| Step4 드라이버·아이언 TOP 3 | 고객사 피팅 API (TOP_1~3) | 추천 근거 (tool 호출 켬) |
| Step4 제품 스펙 카드 | DB 클럽 마스터 | 요약 모드 설명 (tool 호출 끔) |
| Step5 브랜드 선택 추천 | BFF 매칭 엔진 (club_matching.py) | 3~4문장 설명 (tool 호출 끔) |
| Step5 골프공 추천 | golfball Lambda 점수표 | 플레이 스타일 분석 500자 이내 |
1.고객사가 원한 것, 그리고 넘지 못한 선
고객사에는 이미 스크린 골프 경기 데이터와 클럽 피팅 엔진이 있었습니다. 이번 프로젝트의 몫은 그 데이터를 바탕으로 분석·추천 문장을 만들어 온라인몰 화면에 붙이는 일이었습니다.
| 요구 | 결과 |
| 경기 데이터 기반 스윙·경기 분석 | ✅ 화면 Step2(경기 분석) · Step3(골프 성향 유형) |
| 경기 데이터가 없는 회원·게스트 | ✅ 8문항 설문으로 대체 (성별·나이·스코어·드라이버 비거리·7번 아이언 비거리·탄도·구질 9방향·착지 7구역) |
| 드라이버·아이언 추천 TOP 3 | ✅ 고객사 기존 피팅 API 결과를 그대로 사용 |
| 브랜드를 고른 뒤 다시 추천 | ✅ BFF 안의 매칭 엔진 |
| 골프공 추천 | ✅ 별도 AgentCore Runtime, 고객사 엑셀 점수표 이식 |
| 제품 스펙·리뷰 요약·재고·가격 | ✅ product Gateway를 쓰는 Sub-agent |
| 검색결과·상품상세의 AI 피팅 안내 | ✅ 별도 ECS 서비스. 로그인·피팅 보유·검색어 종류로 7가지 타입 분류 |
| 사용 횟수 제한 | ✅ 회원당 월 10회, 세션당 브랜드 추천 5회(조정 가능) |
바꿀 수 없던 전제
- 로그인은 쇼핑몰 것을 그대로: 별도 가입 없이 쇼핑몰 JWT를 받아 통합 회원번호를 고객번호로 씁니다. 이 번호는 Coordinator 시스템 프롬프트에 세션마다 바인딩되고, 다른 회원 번호로는 조회하지 않습니다.
- 피팅 엔진은 다시 만들지 않는다: 경기 데이터 조회와 클럽 TOP 3는 고객사 사내 API를 호출합니다. 우리가 정하는 건 그 결과를 어떻게 설명하느냐입니다.
2.서비스는 이렇게 쌓았다
요청 한 건은 ECS의 BFF를 거쳐 피팅 AgentCore Runtime으로 들어갑니다. Coordinator가 Sub-agent를 고르고, Sub-agent는 MCP Gateway를 통해 Lambda를 부릅니다. 골프공 질문만 A2A로 별도 Runtime에 넘깁니다. 전부 서울 리전 VPC 안에 있습니다.
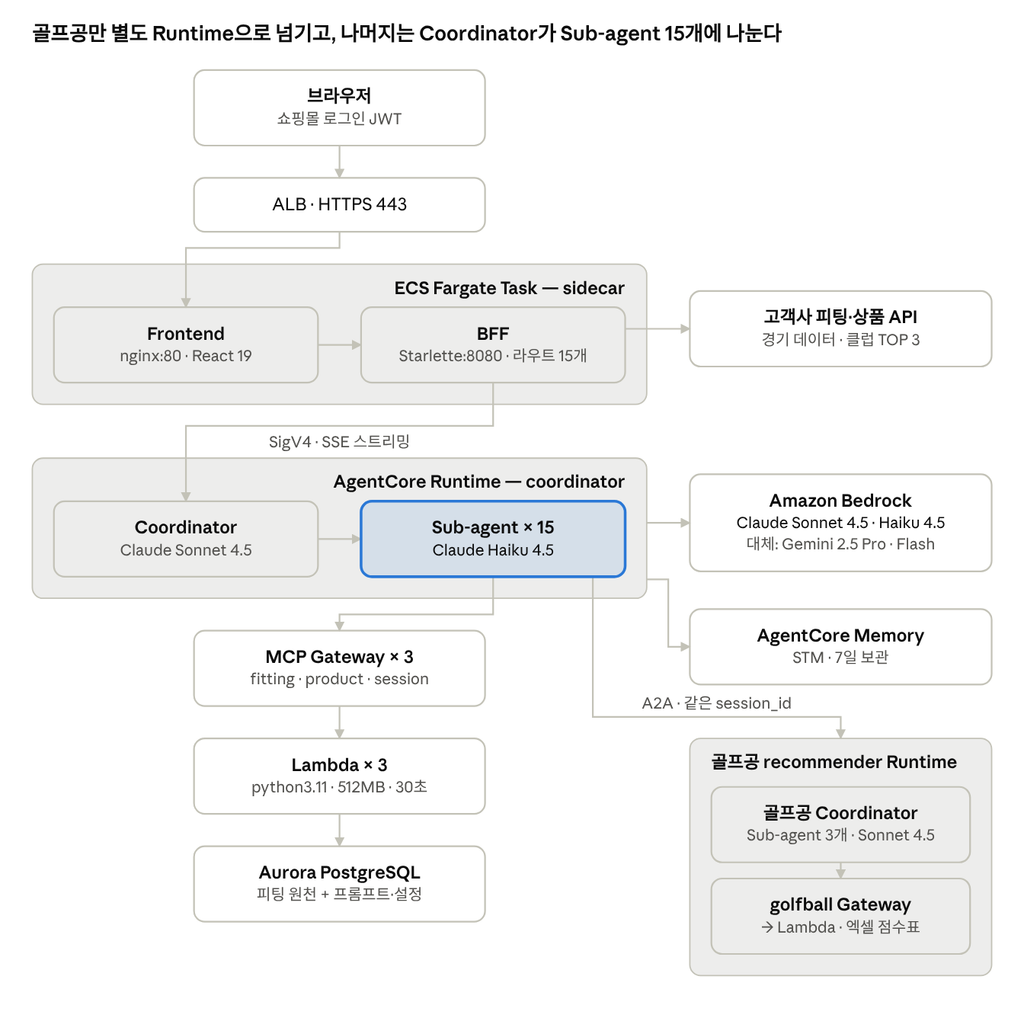
[ 전체 구성도 · ECS → AgentCore Runtime 2개 → Gateway → Lambda → Aurora ]
BFF는 고객사 API를 직접 부르고, 골프공 질문만 Sub-agent가 A2A로 별도 Runtime에 넘깁니다.
| 계층 | 구성 | 하는 일 |
| Frontend | React 19 + Vite 6, nginx:80 | 화면 5단계, API 리버스 프록시 |
| BFF | Starlette:8080 (같은 ECS Task의 sidecar), 라우트 15개 | JWT 검증, 프롬프트 템플릿 치환, 사용 횟수 차감, 고객사 피팅 API 호출, 브랜드 매칭 엔진 |
| Agent | Strands Agents on AgentCore Runtime (Python 3.10, VPC 모드) | Coordinator(Claude Sonnet 4.5) → Sub-agent 15개(Claude Haiku 4.5) |
| Tool | MCP Gateway 3개(fitting · product · session) → Lambda 3개 | 피팅·상품·세션 데이터 조회 |
| 골프공 | recommender Runtime + golfball Gateway → Lambda | 골프공 Coordinator + Sub-agent 3개, A2A로 호출 |
| Memory | AgentCore Memory STM, 7일 보관 | 세션 대화 맥락. 골프공 Runtime과 session_id 공유 |
| DB | Aurora PostgreSQL 17.7, db.r8g.large | 피팅 원천 테이블 8개 + 프롬프트·모델 설정·사용량·대화 기록 |
| 별도 서비스 | ECS 서비스: 상품검색 · 골프공 API · Admin FE/BE | 검색결과 AI 피팅 안내, 골프공 API, 운영 관리 화면 |
정해두고 지킨 규칙 네 가지
① 숫자와 순위는 코드가, LLM은 문장만: 클럽 TOP 3, 브랜드 매칭, 골프공 점수는 전부 결정적 계산입니다. LLM은 그 결과를 받아 “왜 이 고객에게 맞는지”를 씁니다. 아래 “추천 숫자는 코드가 정한다”에서 자세히 다룹니다.
② Coordinator는 직접 답하지 않는다: Coordinator 프롬프트의 최우선 규칙은 “Sub-agent 호출 전에는 한 글자도 출력하지 않는다”입니다. Sub-agent 응답은 요약하거나 덧붙이지 않고 원문 그대로 내보냅니다. “분석하겠습니다” 같은 도입 멘트가 화면에 먼저 찍히는 걸 막으려고 넣었습니다.
③ 프론트와 BFF는 한 Task의 sidecar: ALB는 nginx 80만 보고, BFF는 localhost:8080으로만 붙습니다. 배포 단위는 Task Definition revision 하나입니다.
④ 운영이 바꿀 값은 DB에: 화면 단계별 프롬프트는 ai_prompt, 에이전트별 모델은 ai_agent_model_config, LLM 프로바이더(Bedrock/Gemini)는 ai_model_config에 둡니다. 프롬프트는 BFF와 AgentCore 양쪽에서 5분 캐시라, DB만 고치면 재배포 없이 반영됩니다.
3.추천 숫자는 코드가 정한다
클럽 TOP 3는 고객사 API가 주고, 브랜드 매칭과 골프공 추천은 기존 기준표를 옮겨 둔 계산식이 정합니다. LLM에게 순위를 묻는 곳은 없습니다.
브랜드 매칭: 더하지 않고 순서로 줄 세운다
브랜드를 고른 뒤의 추천은 BFF 안의 매칭 엔진이 맡습니다. 헤드스피드(m/s)로 최적 론치각과 드라이버 CPM을 찾는 기준표가 코드 상수로 들어 있고, 고객 값을 이 기준표에 대어 요인별 점수를 냅니다.
점수를 더하지 않고 정렬 키로 이어 붙인 게 핵심입니다. 요인별 점수를 3자리 숫자로 만들어 우선순위 순서대로 붙이고, 문자열 내림차순으로 정렬합니다.
이렇게 하면 성별·연령 적합도가 한 단계라도 높은 제품은, 뒤 요인 점수가 아무리 높은 제품보다 항상 앞에 섭니다. 뒤 요인은 앞 요인이 모두 같을 때만 순서를 가리고, 마지막 5자리는 원본 행 순서로 동점을 끊습니다. 제품 데이터는 정합성을 위해 캐시 없이 매 요청 DB에서 읽습니다.
골프공: 엑셀 수식을 옮기고 엑셀 결과와 대조했다
골프공 추천 기준은 고객사가 엑셀로 관리하던 볼 데이터 시트였습니다.
추천은 세 단계입니다.
- 필터: 커버 소재(우레탄 / 아이오노머)로 먼저 거르고, 가격대(우레탄 50,000원, 아이오노머 20,000원 기준)와 색상(화이트 / 컬러)으로 좁힙니다.
- 점수: 퍼포먼스·스핀·탄도·피스·컴프레션 답변마다 제품 속성과 대어 점수를 더하고, 브랜드·색상 가산점을 붙입니다.
- 정렬: 총점 내림차순, 동점이면 최신 출시연도. 브랜드를 고르지 않았으면 같은 브랜드는 한 개만 남깁니다.
퍼포먼스 질문 하나만 봐도 같은 답이라도 커버 소재에 따라 점수표가 다릅니다. 엑셀 수식에서 그대로 옮긴 값입니다.
| 답변 | 우레탄 (드라이버 스핀 Low / Mid / High) | 아이오노머 (Low / Mid / High) |
| 비거리 | 20 / 10 / 2 | 30 / 10 / 5 |
| 방향성 | 10 / 20 / 2 | 10 / 5 / 30 |
| 밸런스 | 10 / 25 / 10 | 10 / 30 / 10 |
옮긴 뒤에는 답변 조합별로 DB 결과와 엑셀 기대 결과를 함께 출력하는 시뮬레이션 스크립트로 대조했습니다. 대조 기준은 원본 엑셀의 수식과 매칭 로그 시트입니다.
추천 뒤 이어지는 질문(“A 모델이랑 B 모델 차이가 뭐야”)은 Q&A 지식베이스 100건(JSON)과 점수 추천 tool을 함께 씁니다. 질문을 데이터 직접 비교 / 데이터 + 해석 / 일반 지식 세 가지로 먼저 나누고, DB에 없는 모델은 추정하지 말고 “현재 데이터에서 확인이 어렵습니다”라고 답하게 했습니다.
에이전트 16개와 프롬프트 두 층
Coordinator 1개가 Sub-agent 15개를 tool로 들고 있는 Agents-as-Tools 구조입니다. Sub-agent는 @tool 데코레이터로 등록되고, Coordinator는 각 tool의 docstring을 보고 고릅니다.
| Gateway | Sub-agent (Claude Haiku 4.5) | 동시 호출 |
| fitting | 피팅·스윙 분석 · 드라이버 추천 · 아이언 추천 · 경기 분석 · 골프 성향 유형 · 제품 사양 · 종합 클럽 추천 | 드라이버 + 아이언, 사양 + 리뷰 |
| product | 리뷰 요약 | 리뷰 + 사양 |
| fitting + product | 브랜드 추천 · 재고 · 가격 · 프로모션 | 재고 + 가격, 가격 + 프로모션 |
| session | 일반 골프 질문 | — |
| 없음 | 위젯·차트 데이터 변환 | — |
| A2A | 골프공 추천 → recommender Runtime | — |
화면에서 나가는 호출은 고르지 않고 지정한다
채팅 입력은 Coordinator가 의도를 보고 고르지만, 화면 단계에서 자동으로 나가는 호출은 고를 필요가 없습니다. 프론트가 형태로 보내면 Coordinator는 의도 분석 없이 해당 Sub-agent를 바로 부릅니다. 이런 키가 10개이고, JSON 내용은 사용자에게 노출하지 않습니다.
프롬프트를 코드와 DB로 나눈 이유
| 층 | 저장 위치 | 담는 것 | 바꾸는 방법 |
| 시스템 프롬프트 | 코드 (agents/*.py) | 역할 · 보안 · tool 호출 순서 · 단위 정책 | AgentCore 재배포 |
| DB 프롬프트 | ai_prompt 테이블, 13건 | 입력 데이터 구조 · 출력 형식 · 변수 | DB UPDATE, 5분 캐시 후 반영 |
DB 프롬프트의 constraints(JSONB)는 BFF와 AgentCore가 읽어 템플릿 앞에 지시문을 붙입니다. 예를 들어 {“max_sentences”: 4, “tool_call”: false}는 [4문장 이내] [tool 호출 금지, 주어진 데이터만으로 답변]이 됩니다.
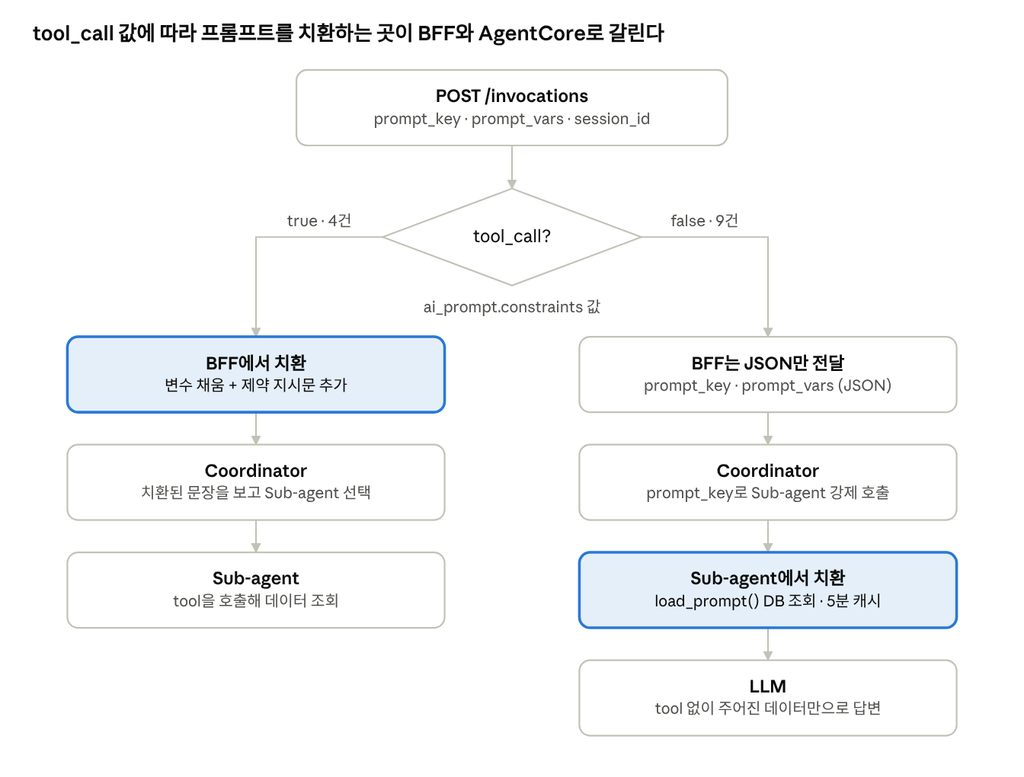
[ 프롬프트 치환 흐름 · tool_call 값에 따라 두 갈래 ]
true는 BFF가 문장을 완성해 넘기고, false는 AgentCore의 Sub-agent가 DB에서 직접 읽어 채웁니다.
tool_call: false는 BFF가 카드 API 결과를 변수로 직접 넣는 경우에 씁니다. 화면 카드와 설명 문장이 같은 데이터를 보게 하려는 장치이고, Sub-agent 프롬프트에는 “[tool 호출 금지] 접두어를 받으면 모든 tool을 멈추고 주어진 데이터만으로 답한다”는 탈출구를 넣었습니다.
골프공은 Runtime을 따로 뒀다
골프공 추천은 메인 Coordinator 안에 넣지 않고 별도 AgentCore Runtime(recommender)으로 뺐습니다. 메인 쪽 ball_recommendation_agent는 자체 LLM 처리 없이 invoke_remote_runtime으로 recommender를 부르기만 합니다.
- 세션 공유: Coordinator의 session_id를 A2A 호출에 그대로 넘겨서 두 Runtime이 같은 STM을 씁니다.
- 도메인 제약: 골프공 Coordinator는 골프공 질문만 받고, 클럽·피팅 질문은 정해진 문구로 거절합니다.
- 프롬프트 캐싱: 골프공 쪽 프롬프트는 DB를 쓰지 않고 코드에 두는 대신 cachePoint로 Bedrock 프롬프트 캐싱을 걸었습니다.
모델은 DB 값 하나로 바꾼다
기본은 Coordinator에 Claude Sonnet 4.5, Sub-agent에 Claude Haiku 4.5입니다. ai_agent_model_config 테이블에서 에이전트별로 Sonnet 4.6, Opus 4.5/4.6, Gemini 2.5 Pro/Flash로 바꿀 수 있고, 첫 요청에 DB 설정을 전체 동기화한 뒤에는 변경이 감지될 때만 다시 읽습니다. Coordinator 인스턴스는 {session_id}:{provider} 키로 최대 100개까지 LRU 캐시합니다.
4.운영에 올리고 부딪힌 것들
운영 문서에 남긴 장애 유형은 대부분 모델이 아니라 배포 설정에서 나왔습니다. 그중 가장 위험한 건 에러 없이 “정상처럼” 뜨는 경우였습니다.
| 증상 | 원인 | 해결 |
| 채팅은 되는데 클럽 추천·피팅 데이터가 Mock이거나 비어 있음 | Gateway URL 환경변수 3개 중 하나라도 빠지면 AgentCore가 tools=[]로 기동 | 배포 스크립트가 필수 환경변수 14개와 __FILL_ME__ 자리표시자를 검사해 배포 차단 |
| Lambda에 tool을 추가했는데 Agent가 못 씀 | Lambda 재배포만으로는 Gateway toolSchema가 갱신되지 않음 | update-gateway-target으로 스키마 재등록. 배포 순서 고정 (아래) |
| 배포 직후 전체 서비스 장애 | agentcore deploy 후 Runtime ARN이 바뀔 수 있고, BFF는 옛 ARN을 부름 | 배포 후 –status로 ARN 확인, 바뀌면 프론트 env 갱신 후 재배포 |
| 수동 설정 변경 후 환경변수 전부 사라짐 | update-agent-runtime에 –environment-variables를 빼면 기존 값이 전부 삭제됨 | 배포 스크립트가 lifecycle 설정(idle 1800초 · 최대 28800초)과 함께 환경변수 전체를 재적용 |
| 첫 호출에서 424 Runtime initialization time exceeded | cold start 중 OTEL 초기화 | ADOT 자동 계측 비활성화 + BFF가 이 오류일 때만 5초 간격 최대 5회 재시도 |
| 로컬 개발에서 첫 invoke 뒤 멈춤 | Gateway URL을 넣으면 MCP 세션이 시작됨 | 로컬은 Gateway URL을 주석 처리하고 mock fallback 사용 |
| 골프공 Gateway 호출이 간헐적으로 실패 | MCP client 세션 만료, cold start 시 Gateway 미준비 | client TTL 30분 재생성, 실패 시 client 리셋 후 다음 호출에서 지연 초기화 |
배포 순서를 문서 맨 위에 박았다
신규 tool이 들어가는 배포는 순서가 하나라도 어긋나면 tools=[]로 뜹니다. 인계 문서 포털 첫 화면의 “필수 주의사항” 첫 줄이 이 순서입니다.
- Lambda 배포
- Gateway schema 등록 (update-gateway-target)
- AgentCore Runtime 배포 → ARN 변경 여부 확인
- BFF + 프론트 배포 (운영은 VITE_TEMP_LOGIN=false 확인)
배포 직후에는 CloudWatch에서 MCPClient 초기화 로그를 확인하는 걸 체크리스트로 넣었습니다. AgentCore에는 이전 버전 자동 롤백이 없어서, 롤백은 이전 커밋의 backend/src/를 체크아웃해 다시 배포하는 방식입니다.
같은 점수 로직이 두 벌 있었다
골프공 점수 로직은 golfball_tools/golfball_tools.py에 먼저 만들고, Lambda(lambda/golfball/lambda_handler.py)로 이식했습니다. 이식한 파일 머리에도 그렇게 적혀 있습니다.
2026-05-19 커밋에서 “브랜드 미선택 시 추천 4개 → 3개”를 고쳤는데, 수정은 golfball_tools.py 쪽에만 들어갔습니다. 인계 시점 Lambda 코드에는 브랜드 중복 제거 루프가 여전히 4개에서 멈춥니다. 같은 규칙을 두 곳에 두면 한쪽만 고쳐지는 일이 생깁니다.
DB 커넥션은 계산해서 정했다
| 위치 | 드라이버 | min / max | 근거 |
| BFF | asyncpg | 2 / 12 | 운영 최대 20 Task × 4 workers = 80 프로세스. 기동 시 160, 피크 960 연결 (Aurora max_connections 1,802의 53%) |
| AgentCore | asyncpg | 1 / 3 | microVM 1개 안에서 tool은 순차 호출이라 동시 점유 최대 1. max 3은 재시도 여유 |
| Lambda | psycopg2 | 1 / 1 | warm 인스턴스당 연결 1개 유지 |
운영 리소스 (인계 시점)
| 항목 | 값 |
| AgentCore Runtime | coordinator · recommender, 둘 다 ACTIVE |
| MCP Gateway → Lambda | 4개 (fitting · product · session · golfball) |
| ECS Fargate | 서비스 5개 · 태스크 10개 (프론트+BFF 2048 CPU / 4096 MiB × 2) |
| Aurora PostgreSQL | 17.7, db.r8g.large, Multi-AZ 아님 |
| 배포 후 정상 기준 | Runtime ACTIVE, warmup 로그 warmup_agent_ok 15건 · skip 0건 |
103일 동안 있었던 일
| 날짜 | 일어난 일 |
| 2025-11-11 | PoC v1.0.0. Supervisor + 4개 에이전트, 로컬 PostgreSQL, Streamlit |
| 2025-11-17 | PoC v1.1.0. React 프론트 추가 |
| 2026-02-09 | 구축 착수 |
| 2026-03-13 | 골프공 데이터 V3. 통일 상품명·색상 가산점·출시연도 컬럼 추가 |
| 2026-04-12 | 브랜드 설문 프롬프트 tool_call true → false |
| 2026-04-28 | 운영 AgentCore Runtime Role에 DB 시크릿 접근 권한 추가 |
| 2026-05-04 | 배포 절차·로그 진단 문서 작성 |
| 2026-05-08 | 골프공·상품검색 Backend 인수인계 문서 작성 |
| 2026-05-19 | 골프공 Backend ECS 배포 수정 (응답 필드명, 추천 개수 4 → 3) |
| 2026-05-22 | 구축 종료 |
잘한 결정
- 고객사 기준을 다시 만들지 않았다: 클럽 TOP 3는 고객사 피팅 API를 그대로 쓰고, 브랜드 매칭과 골프공 점수는 기존 기준표·엑셀 수식을 코드로 옮겼습니다. 추천 결과에 대한 설명 책임이 고객사 기준에 남습니다.
- 엑셀과 대조하는 시뮬레이션을 만들었다: 수식을 옮긴 뒤 답변 조합별로 엑셀 기대 결과와 DB 결과를 같이 찍어봤습니다. 엑셀이 세 버전으로 바뀌는 동안 테이블 교체 스크립트로 따라갔습니다.
- tool 호출을 줄였다: 화면 단계 프롬프트 13개 중 9개를 tool_call: false로 두고 BFF가 데이터를 넣었습니다. 카드와 설명이 같은 데이터를 봅니다.
- 운영 값을 DB로 뺐다: 프롬프트는 5분 캐시 후 반영, 모델은 에이전트별로 재배포 없이 바꿉니다.
- 배포 스크립트가 사람 실수를 막는다: 필수 환경변수 14개 검증, 자리표시자 차단, 환경변수 재적용을 스크립트에 넣었습니다.
아쉬운 결정
- 측정을 남기지 않았다: 응답 지연과 추천 적합도를 회차별로 재서 남겼어야 했습니다. “인계 시점 상태”에 응답 지연과 적합도 숫자를 넣지 못한 이유입니다.
- 같은 로직이 두 벌: 골프공 점수가 golfball_tools.py와 Lambda 두 곳에 있어서, 추천 개수 수정이 한쪽에만 들어갔습니다.
- 프롬프트 관리가 두 방식: 메인 피팅은 DB 프롬프트(버전 컬럼, 5분 캐시), 골프공은 코드 하드코딩(재배포 필요)입니다. 운영자가 두 방식을 따로 알아야 합니다.
처음부터 다시 만든다면
| 처음에 한 것 | 다시 한다면 |
| 점수 로직을 tool 모듈에 만들고 Lambda로 복사 | 처음부터 Lambda 한 곳에만 두고 로컬은 같은 함수를 import |
| 프롬프트를 시스템별로 다른 방식으로 관리 | 골프공도 ai_prompt 테이블로 통일 |
| 배포 후 확인은 로그를 눈으로 | tools=[], ARN 변경, warmup 실패를 배포 스크립트가 직접 검사하고 실패 처리 |
| 품질 확인 기록을 따로 남기지 않음 | 화면 단계별 고정 시나리오 세트로 지연·적합도를 회차마다 기록 |
| Sub-agent를 기능 단위로 15개 | 화면에서 실제로 호출되는 단위부터 만들고 채팅 전용은 뒤로 |
인계하며 남긴 숙제
- Aurora Multi-AZ 전환 검토 (인계 시점 단일 인스턴스)
5.사용 도구
| 영역 | 사용한 것 |
| Frontend | React 19 · Vite 6 · Tailwind CSS · nginx |
| BFF | Python · Starlette · asyncpg · httpx · boto3 |
| Agent | Strands Agents · Amazon Bedrock AgentCore Runtime (direct_code_deploy, Python 3.10, VPC) / Gateway(MCP) / Memory(STM) |
| Tool | AWS Lambda (python3.11) × 4 |
| LLM | Claude Sonnet 4.5 (Coordinator) · Claude Haiku 4.5 (Sub-agent) · 대체 Gemini 2.5 Pro / Flash · 상품검색 Claude 3 Haiku |
| 데이터 | Aurora PostgreSQL 17.7 · S3 · Secrets Manager |
| 관측 | CloudWatch Logs · CloudTrail |
| 개발 도구 | Kiro (spec: requirements · design · tasks) · Claude Code · Playwright MCP |
MegazoneCloud 소속 AI Architect 2명이 투입되어 고객사 AI Fitting 구축 프로젝트를 수행하며 작성한 내용입니다.