
0. 먼저 결론부터
국내 대형 서점 온라인몰에 붙는 AI 도서 추천 챗봇을 109일 동안 만들고 지난주 인수인계를 마쳤습니다. 회원이 큐레이터를 고르고 “기분이 꿀꿀할 때 읽기 좋은 책”처럼 물으면, 715,073권(2026-10-12 기준) 중에서 6권을 골라 추천 이유와 함께 보여주는 서비스입니다.
이 글은 그 과정에서 내린 결정과, 문서만 읽어서는 알 수 없었던 지점들을 정리한 기록입니다. 결론부터 적습니다.
✅ RAG는 Bedrock Knowledge Base 대신 직접 구현했다. Cohere Embed v4 + OpenSearch 하이브리드
✅ LLM은 질문 분류와 문장 생성만 맡긴다. 검색과 순위는 코드가 정한다
⚠️ 품질을 올린 건 모델 교체가 아니라 “검색에 무엇을 넣느냐”였다
⚠️ 지연을 가장 많이 줄인 건 검색이 아니라 적합성 판정 병렬화였다 (QA 평균 50초 → 36초)
| 항목 | 값 |
|---|---|
| 기간 | 2026-06-29 ~ 2026-10-16 (109일) |
| 투입 | AI Architect 2명 (챗봇 본체 1 · RAG·배치·Admin 1) |
| 커밋 | 챗봇 레포 217건 · RAG/Admin 레포 733건 |
| 색인 도서 | 715,073권 (2026-10-12 기준 · 1권 = 문서 1개 = 벡터 1개) |
| 구성 | AgentCore Runtime 1 · Gateway 1 · Memory 1 · Lambda Tool 6 · ECS Fargate |
| 배포 횟수 | AgentCore Runtime 버전 118 · ECS 태스크 정의 PRD rev 71 / QA rev 98 |
목 차
- 배경 — 고객사가 원한 것
- 전체 아키텍처
- RAG — Bedrock KB를 버린 이유
- PoC에서 본선으로 — 파이프라인이 세 번 뒤집혔다
- 추천 파이프라인 상세
- 막혔던 지점들
- 결과
- 회고
- 부록 — 기술 스택과 참고 자료
1. 배경 — 고객사가 원한 것
요구사항은 한 줄로 줄이면 “검색창이 못 알아듣는 질문에 책으로 답해달라”였습니다. 제목·저자 키워드 검색은 이미 잘 되고 있었고, 비어 있던 건 기분·상황·취향처럼 말로 풀어야 하는 질문이었습니다.
처음 받은 요구사항 정의서에는 기능이 더 많았습니다. 데이터를 실제로 열어보고 하나씩 지워나갔습니다.
| 요구 | 예시 질문 | 결과 |
|---|---|---|
| 본문 이해 기반 검색 | “여자 주인공이 타임슬립하는 소설” | ✅ 소개·목차 기반 RAG로 구현 (본문 전체는 미확보) |
| 감정·상황 기반 추천 | “기분이 꿀꿀할 때 읽기 좋은 책” | ✅ 감정 태그가 없어 LLM 자동 태깅으로 대체 |
| 연쇄·연관 추천 | “사피엔스 읽고 재밌었는데 비슷한 거” | ✅ 참조 도서의 저장 벡터로 k-NN |
| 통계·트렌드 추천 | “이번 주 베스트셀러”, “30대 여성이 많이 산 책” | ✅ RAG가 아니라 DB 정형 조회로 라우팅 |
| 무관한 대화 차단 | “안녕?” | ✅ 기본 허용 + 차단 규칙, LLM 호출 전 판정 |
| 추천 이유·요약 2~3문장 | — | ✅ |
| 후속 질문 2~3개 제안 | — | ✅ 실제로 답이 나오는 질문만 노출 |
| 다시 추천받기 | — | ✅ 같은 세션에서 이미 본 책 제외 |
| 리뷰 요약 | — | ❌ 제외 확정 (평균 평점만 노출) |
| 난이도별 단계 추천 · 외부 검색 연동 · CS 응대 | — | ❌ 범위 제외 |
처음부터 걸려 있던 제약
이 제약들이 이후 거의 모든 설계 결정을 갈랐습니다.
- 데이터 국외 전송 승인: 쓰고 싶은 임베딩 모델이 서울 리전에 없었습니다. 정보보호 승인을 받기 전까지 RAG 구성을 확정할 수 없었습니다.
- 운영 DB는 고객사 계정, 읽기 전용: Aurora MySQL은 고객사 계정에 있고 DDL 권한이 없습니다. 374만 행짜리 테이블에 인덱스 하나 추가할 수 없다는 뜻입니다.
- 기존 로그인 그대로: 별도 회원가입 없이 쇼핑몰 로그인 쿠키를 받아 회원 토큰 검증 API로 확인합니다. 이 API는 실패해도 HTTP 200을 돌려줘서 응답 body로만 판정해야 했습니다.
- 도서 관련 질문만, 비용은 최소로: 무관한 질문은 LLM을 부르기 전에 막아야 했습니다.
타임라인
| 날짜 | 일어난 일 |
|---|---|
| 06-29 | 착수. 요구사항 정리, 데이터 갭 분석 |
| 07-20 | 챗봇 레포 스캐폴딩. Tool 이중 구조(dual-use) 설계 |
| 07-27~28 | 임베딩 벤치마크. Titan v2 대비 Cohere 3~4배 우세 확인, Bedrock KB 포기 결정 |
| 08-04 | 데이터 국외 전송 승인. RAG 구성 확정 |
| 08-05~06 | 707,050권 초기 색인 완료 (495M 토큰, UTC 이틀에 걸쳐 완주) |
| 08-06 | Curator Agent + Lambda Tool 5종 첫 실데이터 파이프라인 |
| 08-11 | RAG를 “후보 확장”에서 “후보 전체 집합”으로 승격. 파이프라인 재배열 |
| 08-13 | AgentCore Runtime·Gateway 운영 배포 |
| 08-24~25 | 재랭킹에 RAG 관련도 반영, BM25 입력 분리 |
| 09-03 | AgentCore Runtime OTel 계측 |
| 09-19 | 140건 × 20회 전수 실측. 보고 원칙 재정의 |
| 10-12 | 추천 진행 단계 실시간 안내 |
| 10-16 | 인수인계 |
2. 전체 아키텍처
요청 한 건은 ECS의 BFF를 거쳐 AgentCore Runtime으로 들어가고, Runtime 안의 Agent가 Gateway를 통해 Lambda Tool 6개를 순서대로 부릅니다. 전부 서울 리전 VPC 안에 있습니다.
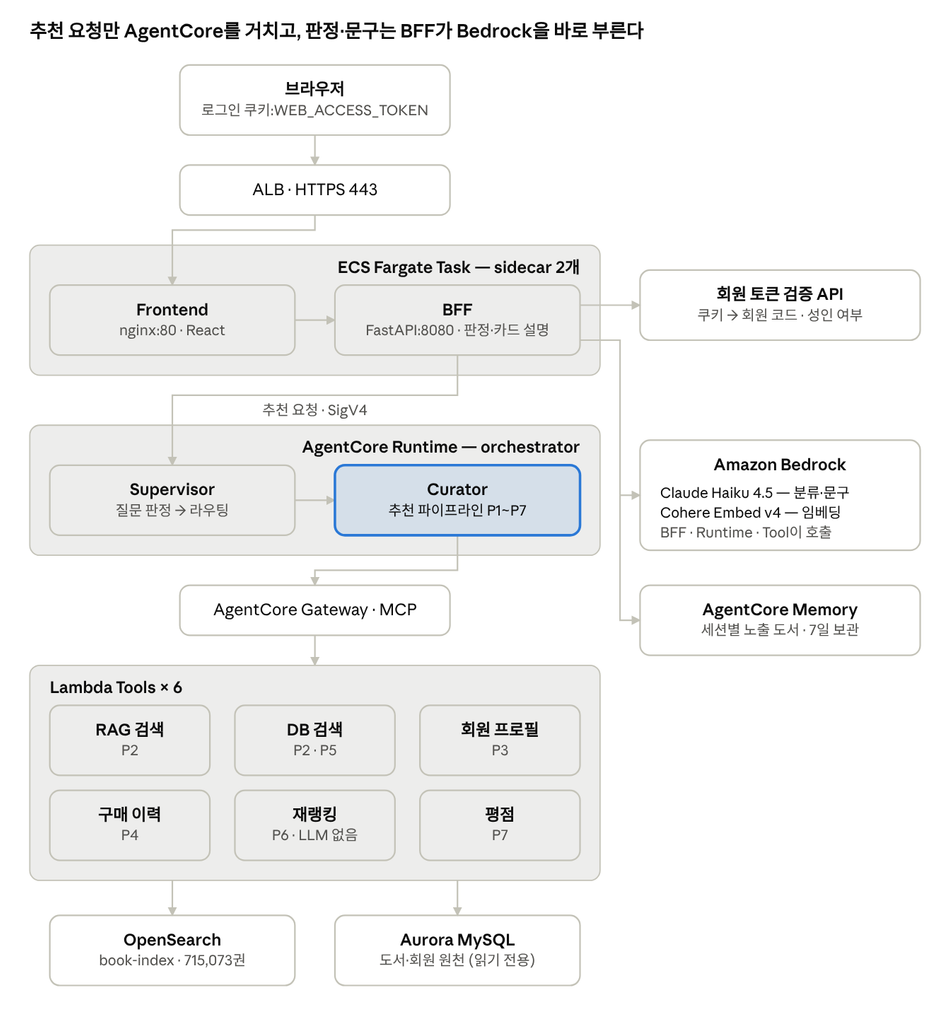
전체 구성도 · ECS → AgentCore Runtime → Gateway → Lambda 6종
오른쪽 세 박스는 BFF가 직접 부릅니다. Runtime은 Tool을 여러 번 부르는 추천 경로에만 씁니다.
| 계층 | 구성 | 하는 일 |
|---|---|---|
| Frontend | React + Vite + Tailwind, nginx:80 | 화면 3단계(큐레이터 선택 → 질문 → 답변), /api/* 리버스 프록시 |
| BFF | FastAPI:8080 (같은 ECS Task의 sidecar) | SSO 토큰 검증, 가드레일, 호출 한도, 카드 설명·적합성 판정 |
| Agent | Strands Agents on AgentCore Runtime | Supervisor(질문 판정) → Curator(추천 파이프라인) |
| Tool | Lambda 6종, AgentCore Gateway(MCP) 등록 | 검색·회원·재랭킹·평점 |
| Memory | AgentCore Memory (STM, 7일) | 세션별 노출 도서 기록 → 다시 추천 시 제외 |
| 검색 | OpenSearch managed (r7g.large × 1, 서울 VPC) | book-index 하이브리드 검색 (BM25 nori + k-NN) |
| 정형 데이터 | Aurora MySQL (고객사 계정, 읽기) | 도서·판매·베스트셀러·회원·리뷰 원천 |
| LLM | Bedrock Claude Haiku 4.5 (분류·문구) · Cohere Embed v4 (임베딩) | 모델 ID는 전부 DB 설정값 |
설계하면서 지킨 원칙 네 가지
① LLM은 분류와 문장만, 검색과 순위는 코드가: 추천 결과가 매번 달라지면 QA도 디버깅도 불가능합니다. 재랭킹(P6)은 LLM을 쓰지 않는 결정적 계산이고, LLM은 질문 분류·도입 문구·카드 설명·적합성 판정에만 들어갑니다.
② 프론트와 백엔드는 한 Task의 sidecar: ALB는 nginx 80 포트만 보고, FastAPI는 localhost:8080으로만 접근합니다. 브라우저 입장에서 Origin이 하나라 CORS가 필요 없고, 배포 단위는 Task Definition revision 하나입니다. SSE를 위해 nginx에 proxy_buffering off를 걸었습니다.
③ Tool은 순수 함수 + 얇은 Lambda 핸들러: search_books_kb(query) -> dict 같은 순수 함수를 두고 lambda_handler는 그걸 감싸기만 합니다. 로컬에서는 Agent가 함수를 직접 import하고, 배포 환경에서는 Gateway를 거쳐 Lambda를 부릅니다. 전환은 환경변수(AGENTCORE_GATEWAY_URL) 유무 하나로 결정되고, 비즈니스 로직은 100% 같은 코드입니다.
# tools/search_books_kb/lambda_handler.py
def search_books_kb(query: dict) -> dict:     # 로컬·Lambda 공용 순수 함수
    ...

def lambda_handler(event, context):           # Lambda 진입점은 얇게
    return search_books_kb(event)
④ 운영이 바꿀 값은 DB에: 모델 ID, temperature, 결과 수, top_k, 프롬프트, 가드레일 규칙, 큐레이터 가중치를 CHATBOT_CONFIG·PROMPT_CONFIG 등 chatbot 스키마에 두고 Admin 화면에서 고칩니다. 프롬프트는 버전으로 관리해서 query_classify 프롬프트 하나만 v57까지 갔습니다. 다만 프롬프트 인젝션 방어 문구는 DB에 두지 않고 코드가 항상 덧붙입니다.
판정은 왜 Runtime이 아니라 BFF에서 하나
가드레일 판정, 도입 문구, 후속 질문 생성은 Tool도 Memory도 필요 없는 단발 호출입니다. 이걸 Runtime까지 보내면 왕복만 늘어서, BFF가 Bedrock을 직접 부르도록 두었습니다. Runtime은 Tool을 여러 번 부르는 추천 파이프라인에만 씁니다.
3. RAG — Bedrock KB를 버린 이유
RAG는 Bedrock Knowledge Base로 시작했다가 임베딩 벤치마크 결과를 보고 직접 구현으로 바꿨습니다. RAG 색인 배치·감정 태깅·Admin은 함께 투입된 동료 AA가 PoC 레포에서 맡았고, 아래 내용은 그 레포의 의사결정 문서와 벤치 결과를 바탕으로 정리했습니다.
3-1. 임베딩부터 쟀다 — Titan v2 vs Cohere
코퍼스 1,781권(주제별 350권 × 5 + 정답 도서 31권)에 실제 예상 질의 9개를 넣고, 기획자가 검수한 정답셋 28건으로 비교했습니다. 차원은 둘 다 1024입니다.
| 모델 | Recall@5 | MRR@5 | nDCG@5 | Recall@10 |
|---|---|---|---|---|
| Titan Text Embeddings v2 (서울) | 0.056 | 0.111 | 0.055 | 0.111 |
| Cohere Embed Multilingual v3 (도쿄) | 0.189 | 0.426 | 0.222 | 0.300 |
| 배수 | 3.4× | 3.8× | 4.0× | 2.7× |
숫자보다 결과 목록이 더 설득력 있었습니다. “스트레스 해소에 좋은 책”에 Titan은 독서치료·ADHD 인지행동치료 책을 올렸습니다. “치료·치유”라는 글자에 끌린 겁니다. Cohere는 1위에 위로 에세이를 올렸습니다. 감정·상황 기반 추천이 핵심 요구사항인데 Titan으로는 그 요구 자체가 성립하지 않는다고 판단했습니다.
절대값이 낮은 건 질의 9개짜리 벤치라서입니다. 모델 간 상대 비교로만 썼고 서비스 품질 기준선으로는 인용하지 않았습니다.
3-2. 그런데 KB로는 Cohere를 쓸 수 없었다
Cohere를 고르는 순간 Bedrock KB의 제약에 걸렸습니다.
- KB가 지원하는 임베딩 모델은 Titan G1·Titan v2·Cohere English v3·Cohere Multilingual v3 넷뿐이고, Cohere Embed v4는 KB 미지원입니다.
- cohere.embed-multilingual-v3는 KB 기준으로 서울 미지원, 도쿄 지원입니다.
- KB의 벡터 스토어와 S3는 KB와 같은 리전이어야 합니다.
즉 KB로 Cohere를 쓰면 KB·OpenSearch·S3가 통째로 도쿄로 갑니다. 벡터만이 아니라 도서 원문 청크까지 국외에 저장됩니다. 여기에 하나 더 있었습니다. KB에서 OpenSearch managed 클러스터를 쓰려면 도메인이 퍼블릭 액세스여야 하고, VPC 안 도메인은 지원하지 않습니다.
| 안 | 구현 | 모델 | 벡터·원문 저장 | 국외 승인 범위 | 추가 공수 |
|---|---|---|---|---|---|
| A | KB | Titan v2 | 서울 | 불필요 | 기준 |
| B | KB | Cohere v3 | 도쿄 | 저장 포함 | 기준 |
| C | 직접 구현 | Cohere v4 | 서울 | 전송만 (저장 없음) | 임베딩·색인·검색 직접 구현 |
C안을 택했습니다. 직접 구현하면 리전 동일성 제약이 사라집니다. 임베딩 API만 global 추론 프로파일로 부르고, OpenSearch·S3·Aurora는 전부 서울 VPC에 둡니다. 승인 요청의 성격이 “국외 저장”에서 “국외 전송(처리 후 미보관)”으로 줄어들었고, 8월 4일 승인이 났습니다.
처음 승인 요청 메일 초안에 “임베딩 결과와 원본은 서울에 저장, 도쿄는 연산만 경유”라고 썼다가 고쳤습니다. 이 문장은 KB 구성에서는 사실이 아니고 직접 구현에서만 성립합니다. 아키텍처를 확정하기 전에 쓴 승인 문구는 한 번 더 의심해야 합니다.
Cohere v3와 v4는 같은 정답셋으로 다시 쟀는데 우열을 가리지 못했습니다. v4가 Recall@5(0.250 vs 0.189)는 높고 MRR@5(0.352 vs 0.426)는 낮았습니다. 다만 “사피엔스 비슷한 거”에서 v3는 정답이 10위, v4는 3위였습니다. 뒤에 재랭킹이 붙는 구조라 상위 1건보다 회수율이 중요하고, 연관 추천이 요구사항에 있어서 v4를 택했습니다.
3-3. 벡터 스토어 — AOSS 대신 managed 단일 노드
| 구성 | 월 비용 (서울, AWS Price List API 2026-07-28) |
|---|---|
| OpenSearch Serverless 이중화 (4 OCU) | $855.6 |
| Managed r7g.large × 2 (Multi-AZ) | $326.3 |
| Managed r7g.large × 1 (단일 AZ, 채택) | $170.1 |
이 워크로드에 AOSS 최소 4 OCU는 과잉이었습니다. 단일 노드로 시작하되 S3 스냅샷 자동 백업을 필수로 켰습니다. 노드를 잃으면 전량을 다시 임베딩해야 하기 때문입니다. 단일 AZ → Multi-AZ 전환은 blue/green으로 처리되니 재색인이 필요 없습니다.
r7g.large는 RAM 16GiB 중 k-NN 서킷브레이커 기본값으로 그래프 예산이 4GiB(오프힙 8GiB × 서킷브레이커 50%)이고, 위 계산값 3.06GB는 그 예산의 77%입니다. 여유가 크지 않아서 FAQ 같은 인덱스를 더 올리기 전에는 r7g.xlarge를 다시 검토해야 합니다.
3-4. 인덱스 설계 — 1권 = 문서 1개, 청킹 없음
평균 문서 길이가 1,698자라 청킹하지 않았습니다. 도서 1권이 문서 1개, 벡터 1개이고 _id는 상품 코드입니다. 임베딩 원문은 순서를 고정해 조립합니다.
제목: {상품명}
저자: {저자명}
키워드: {키워드}
감정·상황: {태그1}, {태그2}, ...
소개: {책 소개}
목차: {목차}
감정 태그는 원천에 없었습니다. 소개·목차·키워드를 Claude Haiku 4.5에 넣어 태그·적합도·한 문장 정의를 한 번에 뽑는 배치를 따로 돌렸고, 결과는 548,504권에 붙었습니다. 원천 책 소개의 96%에 HTML 마크업이 섞여 있어서 태깅과 임베딩이 같은 정제 모듈을 쓰도록 묶었습니다.
3-5. 색인 배치 운영
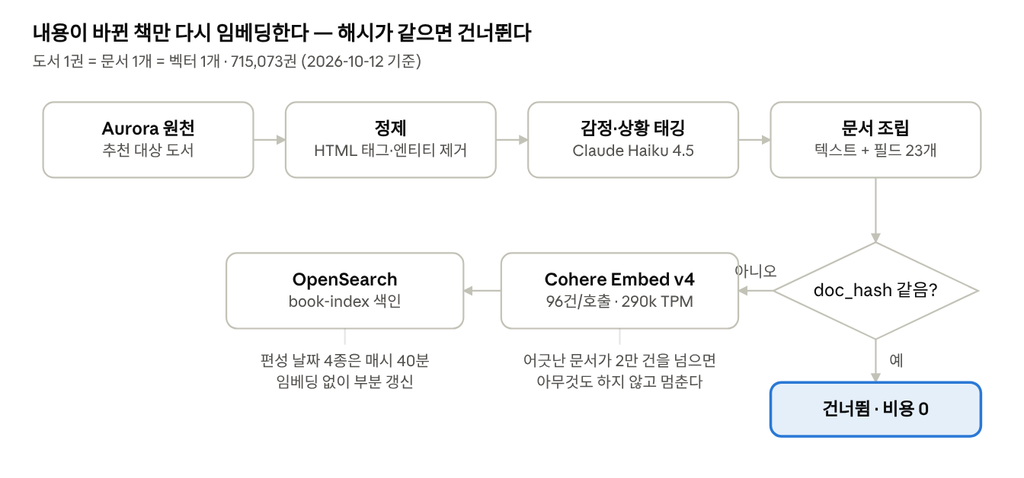
색인 배치 흐름 · 원천 → 태깅 → 조립 → 해시 비교 → 임베딩 → 색인
네 가지 실행 모드는 모두 이 흐름을 타고, 차이는 어떤 도서를 대상으로 삼느냐입니다. 편성 날짜만 바뀜 때는 임베딩을 건너뛰고 필드만 고칩니다.
| 모드 | 주기 | 하는 일 | 임베딩 |
|---|---|---|---|
| incremental | 작업 후 대기·재실행 (하루 206회, 08-18 실측) | 신규·수정 도서 큐를 훑어 바뀐 것만 재임베딩, 판매 중지는 삭제 | ✅ |
| reconcile | 매시 정각 | Aurora 추천 대상 ↔ 인덱스의 ID 집합 비교. 고아 문서 삭제, 누락분 색인 | 누락분만 |
| initial | 매일 04:20 | 전량을 조립해 doc_hash가 어긋난 것만 재임베딩 (낡음 보정) | 어긋난 것만 |
| curation | 매시 40분 | 베스트셀러·MD 추천 등 편성 날짜 4종만 부분 갱신 | ❌ |
전량 재임베딩은 495M 토큰이고, 일일 토큰 캡(432M)을 넘어 UTC 이틀에 걸칩니다. 그래서 비용 사고를 막는 장치를 먼저 만들었습니다. 문서 내용 해시(doc_hash)가 같으면 임베딩을 건너뛰고, 조립 로직을 잘못 고쳐 해시가 한꺼번에 어긋나면 –stale-limit 20000이 아무것도 하지 않고 종료코드 2로 멈춥니다. 종료코드 2는 “상한을 올려 다시 돌려라”가 아니라 “왜 이렇게 많이 바뀌었는지 먼저 밝혀라”라는 신호로 정했습니다.
3-6. 문서와 실측이 달랐던 것들
| 항목 | 처음 믿은 값 | 실측 | 무엇이 틀렸나 |
|---|---|---|---|
| 쿼터 확인 | Service Quotas API 조회값 | 버스트 30건으로 직접 확인 | API가 계정 적용값이 아니라 AWS 기본값을 돌려줬다 |
| 서울 RPM | 20 (“신규 계정 감액”으로 해석) | 서울 20 · 도쿄 2,000 | 콘솔이 서울 값을 보고 있었다. 이후 서울도 2,000으로 상향 |
| 문서당 토큰 | 227 (역산) | 700 (1.41자/토큰, 하루 누적 584,000건) | 작은 표본 역산. 96건 표본 1,117 · 하루 누적 700으로 편차가 컸다 |
| 전량 토큰 | 158.9M | 495M | 일일 캡 432M의 115% → UTC 이틀에 걸침 |
| 초기 적재 | 9시간 (추정) | UTC 이틀 (8/5 하루에만 407.7M 토큰) | TPM 300,000이 정확히 집행됐다 |
| 페이서 | 목표 270,000 TPM | 실제 1.2M TPM 밀어붙임 | 토큰 추정이 틀려 페이싱이 무력화, 시도의 38%가 스로틀 |
4. PoC에서 본선으로 — 파이프라인이 세 번 뒤집혔다
첫 파이프라인은 8월 6일에 실데이터로 돌았습니다. 로컬 기준 응답 1.1~1.4초, 본인 구매 84권과 추천 결과의 교집합 0건, 큐레이터 가중치 곱셈이 소수점까지 일치했습니다. 기능은 전부 맞았습니다. 문제는 추천이 질문과 별 상관이 없었다는 점입니다.
| 시점 | 후보를 어디서 만들었나 | 무엇이 문제였나 | 바꾼 것 |
|---|---|---|---|
| 08-06 v1 | 구매 이력·DB 조회로 후보 생성 | RAG가 없어서 “위로가 되는 책”을 이해하지 못함 | RAG를 P4.5에 “후보 확장”으로 끼워 넣음 |
| 08-10 v2 | DB 후보 + RAG 후보 병합 | RAG 후보가 인기 점수(판매량·베스트셀러 등)에 밀려 최종 6권에 하나도 안 남음 | RAG를 P2로 올려 후보 전체 집합으로 |
| 08-11 v3 | RAG가 만든 집합 안에서만 추리고 정렬 | “이번 주 베스트셀러”처럼 답이 DB에 정확히 있는 질문까지 RAG가 받음 | 질문 분류(query_classify)로 DB 경로 분리 |
| 08-13 v4 | 질문 유형에 따라 RAG 또는 DB가 집합 생성 | — | 이후는 이 구조 위에서 튜닝 |
v3의 규칙 — “P2에서 만든 후보가 전부다”
v2에서 배운 건 “섞으면 진다”였습니다. 의미 검색 후보와 인기 후보를 한 풀에 넣으면, 인기 점수가 큰 쪽이 항상 이깁니다. 그래서 규칙을 하나 박았습니다. P2가 만든 집합이 후보의 전부이고, P3 이후는 그 안에서 추리거나 정렬만 하며 새 책을 추가하지 않는다.
이 규칙을 넣으면서 일부러 깨뜨리는 관점의 적대적 리뷰에서 결함 두 개가 나왔습니다.
- 본인 구매 도서를 나중에 빼면 슬롯이 비었습니다. RAG가 20권을 가져왔는데 그중 5권이 이미 산 책이면 15권으로 시작합니다. 구매 도서를 RAG 호출 전에 사전 필터로 넘기도록 바꿨습니다.
- RAG 장애를 조용히 삼키고 있었습니다. v2에서는 RAG가 실패하면 DB 후보만으로 계속 가는 폴백이 있었는데, v3에서는 RAG가 후보의 전부라 그 폴백이 “빈 결과”가 됩니다. 장애가 “추천할 책이 없어요”로 위장되는 겁니다. 예외를 그대로 전파해 502(일시 오류 안내)로 보이게 했습니다. 빈 결과는 질문 누락과 정상적인 0건 검색일 때만 냅니다.
v4 — RAG로 갈 질문과 DB로 갈 질문을 나눈다
“3개월 판매량 많은 책”, “올해 신간”, “이번 주 베스트셀러”는 의미 검색이 아니라 정렬 문제입니다. RAG로 보내면 “베스트셀러”라는 단어가 들어간 책이 나옵니다.
P2 직전에 Haiku 4.5로 질문을 한 번 분류합니다. 출력은 한 줄입니다.
출력 형식:  라벨[,라벨2] | 작가명또는도서명 | BM25핵심어

"베스트셀러 중 평점 높은 책"            → 라벨 bestseller,rating
"경제 책 중에 입문자용 쉬운 걸로"        → BM25 핵심어 "경제 입문"
"혼자인 밤에 읽기 좋은 에세이 추천해줘"  → BM25 핵심어 "혼자인 밤 에세이"
"미움받을 용기 읽고 싶어"               → BM25 핵심어 "미움받을 용기" (제목은 그대로 보존)
라벨이 붙으면 search_books_db가 Aurora에서 정확한 값으로 집합을 만들고, 없으면 search_books_kb가 RAG로 만듭니다. 소스만 바뀌고 P3 이후는 같습니다. 라벨은 판매량·신간·베스트셀러·이벤트·오늘의 책·평점·작가·성인·화제의 신간·MD 추천 등이고 최대 2개까지 조합합니다. 이 프롬프트는 DB에 있어서 운영 중에 고칠 수 있고, 실제로 가장 많이 고친 프롬프트가 됐습니다(v57).
같은 호출에서 BM25 핵심어도 함께 뽑습니다. 이게 나중에 큰 차이를 만들었는데, 6장에서 다룹니다.
5. 추천 파이프라인 상세
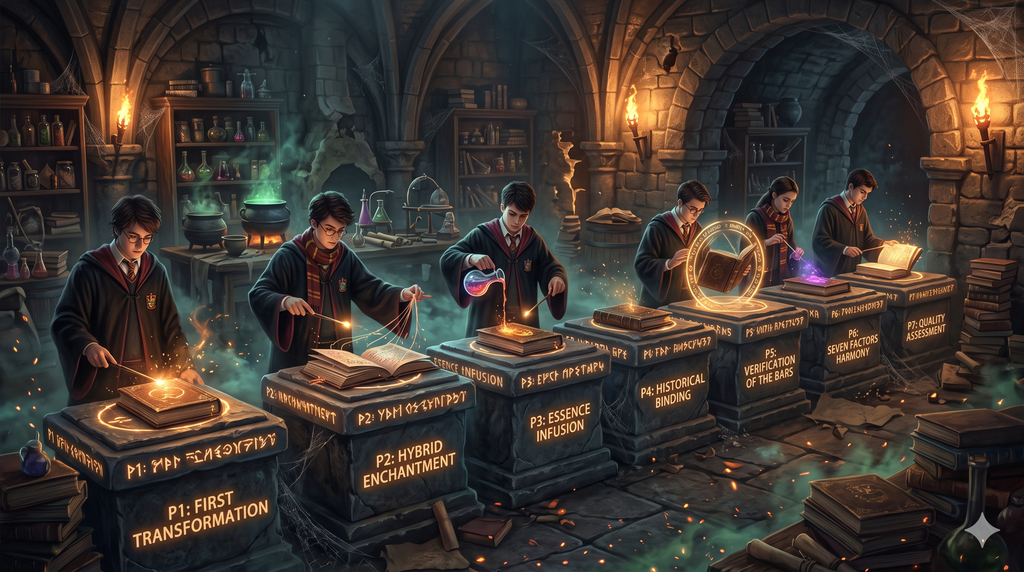
질문 하나는 가드레일 → 질문 분류 → 두 갈래 중 하나 → 카드 설명·적합성 판정을 거쳐 6권이 됩니다. “어떤 책이 좋을지” 고르는 질문은 회원 정보로 개인화 재랭킹을 하고, 베스트셀러·신간처럼 순서 자체가 답인 질문은 DB가 정한 순서를 그대로 씁니다.
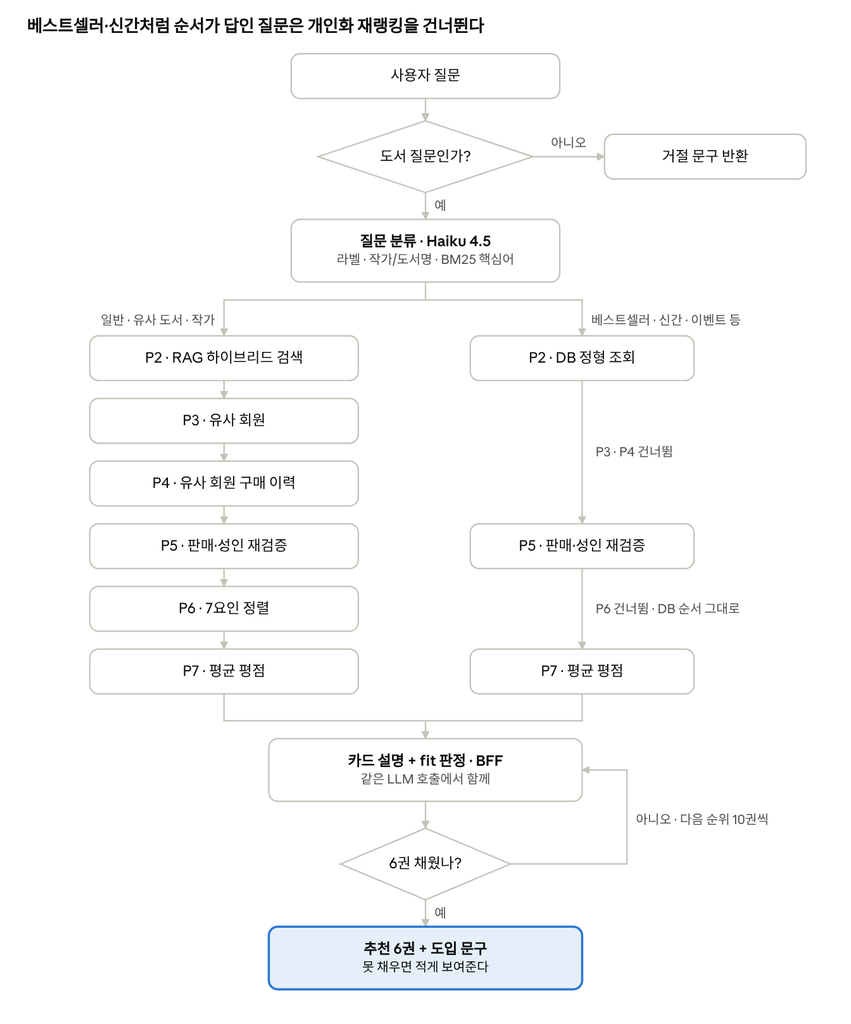
추천 파이프라인 · 가드레일 → 분류 → 두 갈래 → 적합성 판정 → 6권
오른쪽 갈래는 DB가 정한 순서가 곳 답이라 개인화 단계(P3·P4·P6)를 건너뛰고, 두 갈래는 적합성 판정에서 다시 만납니다.
| 단계 | 실행 위치 | 하는 일 | LLM |
|---|---|---|---|
| 가드레일 | BFF | 빈 질문 → 금지 패턴 → 허용 예시 정확 일치 → LLM 분류 순. 앞에서 걸리면 LLM을 안 부른다 | Haiku 4.5 |
| P1 | BFF | 선택한 큐레이터의 대분류별 가중치 로드 | — |
| 질문 분류 | Runtime | 라벨 · 작가/도서명 · BM25 핵심어 · 카테고리 · 기간 표현 | Haiku 4.5 |
| P2 | Lambda | 후보 전체 집합 생성. RAG 하이브리드 또는 DB 정형 조회 | — |
| P3 | Lambda | 성별 또는 출생연도가 같은 유사 회원 (최대 200명) | — |
| P4 | Lambda | 유사 회원 주문 (최대 500건) → 후보와의 공동 구매 수 | — |
| P5 | Lambda | 판매 가능·성인 여부 SQL 재검증. 색인 지연 방어선 | — |
| P6 | Lambda | 7요인 정렬 (일반 경로만) | — |
| P7 | Lambda | 평균 평점 (노출 중인 리뷰만, 없으면 0.0) | — |
| 카드 설명 · 적합성 | BFF | 추천 이유 2~3문장 + fit: true/false를 한 호출에 | Haiku 4.5 |
재랭킹은 네 번 바뀌었다
7요인은 3개월 판매량·출간일·베스트셀러·이벤트·오늘의 책·MD 추천·화제의 신간입니다. 비중은 DB의 RECO_TYPE_WEIGHT가 %로 정합니다. 이 %를 어떻게 해석하느냐가 계속 문제였습니다.
| 시점 | 방식 | 왜 바꿨나 |
|---|---|---|
| 08-06 | 요인별 이진 플래그 × 가중치% 합산 × 큐레이터 배수 | — |
| 08-24 | 위 점수 × RAG 관련도 배수 | 24질의 × 6권 = 144권의 RAG 순위 평균이 10.5. top_k=20 균등분포 기댓값과 정확히 같았다. 관련도가 점수에 전혀 안 들어가 있었다 |
| 09-04 | 구간 배분: 가중치%를 “노출 순서에서 차지하는 비율”로 해석 | w_sales_3m=45는 “유효하면 45점”이 아니라 “노출의 45%를 판매량 순으로”라는 뜻이라는 기획 쪽 지적 |
| 09-21 | 구간을 노출 수(6권) 단위로 순환 배분 + 최대잔여법 | 구간 크기를 전체 후보 198권 기준으로 잡아 판매량 구간이 99칸. 50:15:15가 실제로는 100:0:0으로 동작 |
08-24 버전의 관련도 배수는 이랬습니다. 1위는 ×1.95, 꼴찌는 ×1.00이고, 7요인이 전부 무효인 후보가 0점으로 배수를 무력화하지 않게 바닥값 0.01을 뒀습니다.
9월부터는 역할을 나눴습니다. 큐레이터 가중치는 “무엇을 뽑을지”라서 P2 검색 단계로 옮기고, 7요인은 “뽑힌 것 안에서 어떻게 줄 세울지”만 맡깁니다. 정형 경로(베스트셀러·신간 등)에는 재랭킹을 아예 적용하지 않습니다. 베스트셀러 순위를 판매량 가중치로 다시 섞으면 답이 틀려지기 때문입니다.
최종 순서는 제목 완전 일치 → 유사 회원이 산 책 → 나머지입니다.
카드 설명과 적합성 판정을 한 호출에
하이브리드 검색의 RRF 융합은 점수가 아니라 순위 기반(Σ 1/(60+순위))이라, BM25나 벡터 한쪽에서만 중위권에 잡힌 무관한 책이 비슷한 점수를 받을 수 있습니다. 그래서 마지막에 LLM이 한 번 더 봅니다. 카드 설명을 만드는 같은 호출에서 “이 책이 질문에 맞는가”를 fit으로 함께 출력하게 해서 추가 호출 비용을 없앴습니다.
{"desc": "(추천 이유 + 책 소개 2~3문장)", "fit": false}fit:false는 버리고 그만큼 다음 순위에서 채웁니다. 처음엔 드롭만 하고 채우지 않았더니 6권이 5권, 3권으로 줄어서, 파이프라인이 재랭킹된 후보 전체를 넘기고 BFF가 필요한 만큼만 소배치로 추가 판정하도록 바꿨습니다. 지금은 1라운드에 6권, 모자라면 2~4라운드(각 10권)를 병렬로 판정하고 시간 상한을 둡니다. 다 써도 못 채우면 억지로 채우지 않고 적게 보여줍니다.
다시 추천받기와 진행 안내
추천 결과는 BFF가 백그라운드로 AgentCore Memory에 {질문, 도서}로 기록합니다. “다른 책으로 다시 추천해줘”를 누르면 같은 세션·같은 질문에서 이미 보여준 책을 Memory에서 읽어 제외 목록에 합칩니다. 별도 DB 테이블 없이 7일 TTL의 STM 하나로 해결했습니다.
대기 화면은 원래 3초마다 고정 문구 세 개가 돌았습니다. 응답 시간이 3.2초~29.9초로 9배 넘게 벌어지니, 짧으면 스쳐 지나가고 길면 마지막 문구에서 20초 넘게 멈춰 있었습니다. 10월에 Runtime 진행 이벤트를 SSE로 중계해서 “총 185권을 찾았어요”처럼 실제 단계를 보여주도록 바꿨습니다.
6. 막혔던 지점들
가장 오래 걸린 문제들은 대부분 “코드는 의도대로 도는데 결과가 틀린” 종류였습니다. 에러가 안 나니 로그를 하나씩 대조하기 전까지 보이지 않았습니다.
| 증상 | 원인 | 해결 |
|---|---|---|
| “경제 책 입문자용”에 필라테스 책이 3위 | BM25에 발화 원문을 그대로 넣어 “자용”·”줘” 같은 조각이 희귀도(IDF)로 순위를 지배 | BM25에는 분류기가 뽑은 핵심어만, 벡터에는 원문 그대로 |
| 큐레이터를 바꿔도 6권이 같음 | top_k=20이 너무 작아 큐레이터 가중치가 움직일 여지가 없음 | top_k 20 → 60 |
| “성인 도서 추천해줘”가 0건 | OpenSearch 필터에 제외(must_not)만 있고 포함(must)이 없었다 | require_adult 파라미터 추가. 비성인 회원이면 must+must_not 충돌로 자연히 0건 |
| “평점 높은 책”이 출간일 순으로 나옴 | “평점” 단독 질문을 최근 1년 신간으로 좁혔는데, 신간은 리뷰가 없어 전부 0.0 동률 | 베스트셀러 ∪ 3개월 판매량으로 좁힌 뒤 평점 정렬 |
| 베스트셀러가 꼴찌부터 나옴 | user_rank를 “높을수록 상위”로 가정해 DESC 정렬. 실제는 1위가 최상위 | ASC로 정정. 값 분포(0~910)를 조회해 보기 전까지 아무도 몰랐다 |
| 회원 프로필 조회 500 | birth_year가 VARCHAR로 와서 산술 연산 TypeError | 정수 캐스팅 실패 시 연령 조건 생략 |
| Gateway 배포 실패 | Tool 스키마의 JSON Schema oneOf를 Gateway가 거부 | 스키마 단순화 |
| Gateway 스키마 깨짐 | 스키마 설명에 넣은 한글 예시 문자열이 재직렬화 과정에서 깨짐 | 예시 문자열 제거 |
| 동시 요청 시 토큰 재발급 충돌 | 두 요청이 동시에 refresh token 재발급을 시도하는 레이스 | 재발급 단일화 |
BM25에 무엇을 넣느냐가 품질을 갈랐다
이 문제는 _explain으로 점수 분해를 떠보고 나서야 원인이 보였습니다. 그 전에 시도한 세 가지는 전부 실측으로 무효였습니다.
- nori decompound_mode 변경 — “자용”은 사전 기본 분절이라 모드와 무관했습니다.
- minimum_should_match — 잡음 많은 문서를 오히려 통과시켰습니다.
- 융합 방식을 hybrid-normalized로 교체 — RRF 자체는 정상이었습니다. 문제는 BM25 입력이었습니다.
해결은 분석기가 아니라 입력 쪽이었습니다. 질문 분류 호출(이미 있던 호출)이 BM25 핵심어도 같이 뽑게 하고, search_books_kb가 bm25_query_text를 따로 받아 match 절에만 씁니다. 벡터는 문맥이 필요하니 원문을 그대로 둡니다. 추가 LLM 호출 비용은 0입니다.
여기서 한 번 더 걸렸습니다. 9월에 카테고리 동의어 확장을 넣으면서 확장 단어가 BM25 입력뿐 아니라 벡터 입력에도 섞여 들어갔습니다. 배포 후 카테고리 매칭 결과만 로그로 보고 “이상 없음”이라고 판단했는데, 바로 옆 필드인 임베딩 입력을 안 본 겁니다. 그 뒤로 검증할 때는 벡터 입력·BM25 입력·Tool 파라미터·SQL을 전부 로그로 대조하는 걸 규칙으로 만들었습니다.
374만 행 테이블과 DDL 권한 없음
주간 베스트셀러 테이블은 주마다 스냅샷이 쌓이는 구조라 374만 행, 고유 도서 21만 권(도서당 평균 17.7행)이었습니다. 설계할 때는 “작은 큐레이션 테이블이겠지”라고 가정했다가 재작업했습니다.
GROUP BY + MAX(user_rank)도, PRODUCT JOIN 후 정렬도 8초 타임아웃이 났습니다. 운영 DB라 인덱스를 추가할 수 없었습니다. 결국 SQL에서는 JOIN과 판매 가능 필터를 빼고 기존 인덱스만 타서 넉넉히 오버페치(최대 2,000행)한 뒤, 메타데이터는 PK 배치 조회로 붙이고 필터는 애플리케이션에서 걸었습니다. 0.1~1.2초로 내려왔습니다. 등록일 정렬도 인덱스가 없어서 오버페치 풀 안에서만 Python 안정 정렬을 합니다. 전역 정렬이 아니라는 한계는 문서에 명시해 뒀습니다.
추론 모델은 maxTokens 16에서 빈 응답을 낸다
모델 교체 벤치에서 GPT-5.6 3종을 분류 지점에 넣어봤습니다. 분류는 라벨 하나만 내면 되니 maxTokens=16으로 두고 있었는데, GPT-5.6은 추론 과정에 16토큰을 전부 써서 빈 응답을 냈습니다. 정확도가 Luna 10.4%, Terra 18.3%, Sol 5.2%였습니다. 모델 실력이 아니라 예산 문제입니다.
호출 규칙도 모델군마다 달랐습니다. openai.* 모델은 temperature를 보내면 거부하고, Claude 5 계열과 Opus 4.7/4.8도 temperature에서 400을 냈습니다. 그래서 모델군별 Converse 파라미터 분기를 만들었고, openai.*에는 temperature를 빼고 reasoning.effort=none을 붙입니다. A/B 비교 도구도 거부 → 재시도 왕복이 지연에 섞이고 있어서 운영과 같은 조건으로 맞췄습니다. 이 주제는 팀 블로그의 Bedrock GPT-5.6 서울 리전 CRIS 실측 가이드에 자세히 정리돼 있습니다.
“해결됐다”는 보고가 틀렸던 날
9월 18일, 제목이 질문과 완전히 일치하는 책을 맨 앞에 두는 기능을 넣었습니다. 코드 리뷰를 하고, search_books_kb Lambda를 단독 invoke해서 플래그가 붙는 걸 확인하고 “해결”로 보고했습니다.
실제로는 효과가 0이었습니다. P5에서 후보를 Aurora로 재조회하면서 그 플래그가 통째로 사라지고 있었습니다. 같은 날 다른 이슈들도 같은 패턴으로 “해결” 보고 후 고객 실사용에서 재현됐습니다. 다음 날 이슈 7개 × 20회, 140건을 전체 파이프라인으로 전수 실측했고 이슈별 통과율은 10/20에서 20/20까지 흩어져 있었습니다.
그 뒤로 보고 규칙을 바꿨습니다.
- “해결”은 전체 파이프라인 반복 실측을 통과했을 때만 쓴다. Lambda 단독 호출·프롬프트 단독 테스트·코드 리뷰는 중간 확인일 뿐이다.
- 통과율은 숫자로 쓴다. “대부분”, “거의” 대신 “20회 중 18회”.
- 실패는 분류해서 남긴다. 오분류 / 검색 0건 / 랭킹 미스 / 데이터 부재.
- LLM 판단에 의존하는 기능은 100% 보장이 안 된다는 걸 명시한다.
7. 결과
기능 회귀는 0까지 내렸지만, 추천 품질은 배포마다 위아래로 흔들렸습니다. 품질은 LLM 판정이 추천된 책 한 권마다 질문 적합성을 1~5점으로 매기는 방식으로 쟀습니다.
품질 — 고정 질의와 예상 질문이 반대로 움직였다
| 회차 | 고정 28질의 (168권) | 예상 질문 60건 | 고정 질의 2점 이하 |
|---|---|---|---|
| 09-03 | 3.88 | 3.87 | 16.0% |
| 09-07 | 3.64 | 3.89 | 22.6% |
| 09-08 | 3.82 | 3.73 | 16.7% |
09-08 회차에서 같은 배포본을 같은 날 쟀는데 두 세트가 반대 방향으로 움직였습니다. 고정 질의는 통계·트렌드·작가 질문이 많고, 예상 질문은 화면에서 실제로 클릭되는 문장입니다. 한쪽 세트만 보면 정반대 결론이 납니다. 그래서 품질 판정은 항상 두 세트를 같이 보고, 경로·점수·유형 세 축이 함께 움직였을 때만 “개선”이라고 부르기로 했습니다.
09-07 회차 기능 QA는 22 Pass / 0 Fail, 라우팅 8/8, 조합 질의 4/4였습니다. 결과 6권의 커버리지는 0.94~0.96, 저자·출판사·설명 누락은 0이었습니다.
지연 — 가장 크게 줄인 건 적합성 판정 병렬화였다
지연은 QA 회차마다 같은 질의 세트를 실제 서비스 경로로 호출해 쟀습니다. 고정 28질의와, 화면에 노출되는 예상 질문 60건(큐레이터 5종 × 12건) 두 세트입니다.
| 회차 | 고정 28질의 p50 / p95 / max | 예상 질문 60건 p50 / p95 / max |
|---|---|---|
| 09-03 | 14.5 / 20.9 / 51.7초 | 20.6 / 42.8 / 56.9초 |
| 09-07 | 14.4 / 21.8 / 24.4초 | 21.9 / 31.4 / 34.1초 |
| 09-08 | 16.1 / 25.2 / 28.3초 | 22.2 / 41.0 / 57.1초 |
09-07에 같은 부하를 두 번 쟀더니 고정 질의 p95가 34.4초와 21.8초로 갈렸습니다. 28질의 표본에서는 회차 간 몇 초 차이를 개선이나 악화로 읽을 수 없다는 뜻입니다. 화면에서 실제로 클릭되는 예상 질문은 고정 질의보다 p50이 6.1~7.5초 느렸습니다.
무거운 쪽은 Runtime 뒤에 붙인 카드 설명·적합성 판정이었습니다. 판정 LLM 호출 1회는 중앙값 5.9초(08-27~09-03, 147건)였고, 후보 풀은 182권까지 관측됐는데 판정 루프에 시간 상한이 없었습니다. ALB idle timeout은 60초입니다. 루프에 시간 상한을 넣고, 10월 12일에는 1라운드·2~4라운드·보충 판정을 동시에 시작하도록 바꿨습니다. QA 실측에서 순차 요청 평균이 50초에서 36초로, 3건 동시 요청은 53초에서 34초로 줄었고, 55초를 넘긴 요청은 40건 중 0건이었습니다.
진행 안내도 같은 날 고쳤습니다. 검색·정렬·읽기 단계 이벤트가 Runtime이 끝나는 17~20초에 한꺼번에 도착하던 것을 도착 즉시 중계하도록 바꿔, QA에서 8·10·12초에 각각 보이게 했습니다.
모델 — 11종을 재고 Haiku 4.5를 유지했다
분류 지점의 결정적 지표는 “범위 밖 질문을 막는 능력(경계 차단)”이었습니다. 2차 회차(141케이스, 경계 차단 분모 37) 기준입니다.
| 모델 | 분류 정확도 | 경계 차단 | 카드 설명 질의당 비용 | 판정 |
|---|---|---|---|---|
| Claude Haiku 4.5 | 75.2% | 25/37 (68%) | $0.023746 | ✅ 유지 |
| GPT-6 Luna (maxTokens 512) | 66.0% | 21/37 (57%) | $0.001683 | ⚠️ 보류 |
| Claude Sonnet 5 (effort low, maxTokens 512) | 66.7% | 21/37 (57%) | $0.049251 | ❌ |
GPT-6 Luna는 질의당 비용이 Haiku의 7.1%였지만 실제 런타임 값인 maxTokens=16에서는 141건 전부 빈 응답이었습니다. 경계 차단에서 Haiku를 넘은 모델이 없어서, 1차 회차의 GPT-5.6 3종·Gemma 3·Qwen3까지 합쳐 11종을 재고 전부 채택하지 않았습니다.
비용 — 조회·측정한 값
| 항목 | 값 | 근거 |
|---|---|---|
| OpenSearch r7g.large × 1 + gp3 100GB (단일 AZ) | 월 $170.1 | AWS Price List API, 서울, 2026-07-28 조회 |
| 707,050권 전량 임베딩 (Cohere Embed v4) | 495M 토큰 | 08-05~06 초기 적재 실측 (응답 헤더 · CloudWatch 지표) |
| 카드 설명 생성 (Haiku 4.5) | 질의당 $0.023746 | 09-28 LLM 벤치 실측 |
단가에 트래픽을 곱한 월 예상 비용은 트래픽 가정에 따라 달라지므로 이 글에는 넣지 않았습니다.
8. 회고
돌아보면 이 프로젝트에서 시간을 가장 많이 잡아먹은 건 기술 난이도가 아니라 확인하지 않은 가정이었습니다.
잘한 것
- 모델을 고르기 전에 쟀다: 임베딩 벤치를 먼저 돌린 덕에 KB를 버리는 결정을 착수 29일 만인 07-28에 내릴 수 있었습니다. 색인을 시작한 뒤였다면 전량 재임베딩이었습니다.
- KB 대신 직접 구현: 임베딩·색인·검색 코드를 직접 짜야 했지만 국외 저장을 피했고, VPC 안 OpenSearch를 유지했고, 벡터 스토어 비용을 월 $855.6에서 $170.1로 낮췄습니다.
- 운영 값을 DB로 뺐다: 프롬프트·모델·가중치·가드레일을 배포 없이 바꿀 수 있어서, 질문 분류 프롬프트가 v57까지 가는 동안 코드 배포 없이 DB 반영만으로 끝났습니다.
- Tool 이중 구조: 같은 순수 함수를 로컬에서 직접 import하고 운영에서는 Lambda로 부르니, 운영 이슈를 로컬에서 같은 코드로 재현할 수 있었습니다.
- 비용 사고 방지 장치를 먼저 만들었다: doc_hash와 –stale-limit 덕에 조립 로직을 잘못 고쳐도 전량 재임베딩(495M 토큰, UTC 이틀)이 무인으로 시작되지 않습니다.
아쉬운 것
- 가정으로 설계한 곳마다 재작업했다.:베스트셀러 테이블이 작을 거라는 가정(실제 374만 행), “화제의 신간 = rec_type=1″이라는 가정(실제 값은 0과 2뿐), user_rank가 높을수록 상위라는 가정(반대). 전부 쿼리 한 번이면 확인할 수 있었습니다.
- 정답셋이 약했다: 첫 벤치의 정답셋은 정형 조회 질문(장르·평점·신간) 위주였습니다. 실제 인덱스로 v4를 다시 쟀을 때 Recall@5가 0.022로 나와 지표로 쓸 수 없었습니다. 의미 검색 질문만으로 정답셋을 다시 만들었어야 했습니다.
- 품질 지표를 늦게 만들었다: LLM 판정 기반 품질 측정이 8월 말에야 자리를 잡았습니다. 그 전의 “좋아졌다”는 판단은 몇 개 질문을 눈으로 본 결과였습니다.
- 요청 단위 총 소요 로그가 없다: Runtime 이후 구간을 요청 단위로 따로 잴 수 없었습니다. 처음부터 요청 ID별 구간 타이밍을 남겼어야 합니다.
AI 코딩 에이전트와 일하며 박은 원칙
개발은 Claude Code와 함께 했습니다. 에이전트도 사람과 똑같은 실수를 했습니다. 그럴듯한 가정으로 설계하고, 요청받은 필드만 확인하고 “이상 없음”이라고 보고하는 것. 그래서 프로젝트 가이드 파일(CLAUDE.md) 맨 위에 원칙 세 개를 날짜와 실측 사례를 붙여 박아 넣었습니다.
1. 추측 금지 — 테이블 규모·컬럼·API 동작은 실제로 조회·실행해서 확인한 뒤 근거로 삼는다
2. 검증 = 그 기능이 건드리는 모든 값을 로그로 대조 — 벡터 입력, BM25 입력, Tool 파라미터, SQL까지
3. “해결”은 전체 파이프라인 반복 실측 통과 시에만 — 통과율은 숫자로, 실패는 분류해서
원칙마다 “언제 무엇이 왜 틀렸는지” 실제 사례를 붙인 건, 규칙만 있으면 “이번 건은 예외”라고 해석할 여지가 남기 때문입니다. 사람 팀원에게 쓰는 가이드도 같다고 생각합니다.
다시 한다면
| 처음에 한 것 | 다시 한다면 |
|---|---|
| 기획 정의서 기준으로 데이터 설계 | 첫 주에 주요 테이블 행 수·값 분포·인덱스부터 조회 |
| 질문 9개로 임베딩 벤치 | 의미 검색 질문만으로 정답셋을 넉넉히, 정형 질문은 처음부터 분리 |
| 품질은 눈으로 확인 | 첫 파이프라인이 돌 때부터 LLM 판정 + 고정 질의 세트 회귀 |
| 지연은 구간별로 따로 측정 | 요청 ID별 구간 타이밍 로그를 첫 배포부터 |
| 대기 화면은 고정 문구 | 처음부터 진행 단계 스트리밍 전제로 SSE 설계 |
남은 숙제
- OpenSearch Multi-AZ 전환과 레플리카 1 (재색인 불필요)
- 다른 인덱스(FAQ 등)를 같은 노드에 올리기 전 r7g.xlarge 재검토 — 지금 그래프 메모리 77%
- 응답 지연 줄이기
9. 부록 — 기술 스택과 참고 자료
| 영역 | 사용한 것 |
|---|---|
| Frontend | React · Vite · Tailwind CSS · nginx |
| BFF | Python · FastAPI · uvicorn · SQLAlchemy |
| Agent | Strands Agents · Amazon Bedrock AgentCore Runtime / Gateway(MCP) / Memory(STM) |
| Tool | AWS Lambda (Python) × 6 |
| LLM | Claude Haiku 4.5 (분류·문구·적합성) · 폴백 Sonnet 4.5 / Sonnet 5 |
| 임베딩 | Cohere Embed v4 (global.cohere.embed-v4:0, 서울 엔드포인트) · 1024차원 |
| 검색 | Amazon OpenSearch Service managed · nori · HNSW(faiss) · 하이브리드 RRF |
| 배치 | ECS Fargate RunTask · Step Functions 루프 (증분 7분 · 대사 매시 · 낡음 보정 매일) |
| 데이터 | Aurora MySQL (원천 읽기 전용 + 챗봇 설정 스키마) · S3 · Secrets Manager |
| 관측 | CloudWatch Logs · AgentCore Runtime OTel(ADOT) · 요청 ID 상관관계 |
측정에 대해: 이 글의 수치는 프로젝트 중 직접 측정한 값이고, 측정일과 조건이 회차마다 다릅니다. 임베딩 벤치는 질의 9개 규모라 모델 간 상대 비교로만 읽어야 하고, 지연은 QA 회차마다 같은 질의 세트를 서비스 경로로 호출해 잰 값입니다. 가격은 측정 당시 서울 리전 공시 단가 기준입니다.
참고 자료
- Supported models and Regions for Amazon Bedrock knowledge bases
- Prerequisites for using a vector store for a knowledge base
- Cohere Embed v4 model card
- Amazon Bedrock AgentCore 개발자 가이드
- Strands Agents — Amazon Bedrock
- OpenSearch k-NN · Hybrid search 문서
- Prompt caching — Amazon Bedrock
- 드디어 AWS 서울리전에서 GPT-5.6을 호출할 수 있다, 다만 — Bedrock Cross Region Inference 실측 가이드 (MegazoneCloud TechBlog)
MegazoneCloud 소속 AI Architect로 고객사 AI 챗봇 구축 프로젝트를 수행하며 작성한 내용입니다.
RAG 색인 파이프라인·감정 태깅·Admin은 함께 투입된 동료 AA가 설계·구현했습니다.