
한 질문에 늘 같은 LLM이 답해야 할까? — TypeSafe.ai의 Jev로 만든 Strands의 요청별 모델 라우팅
들어가며
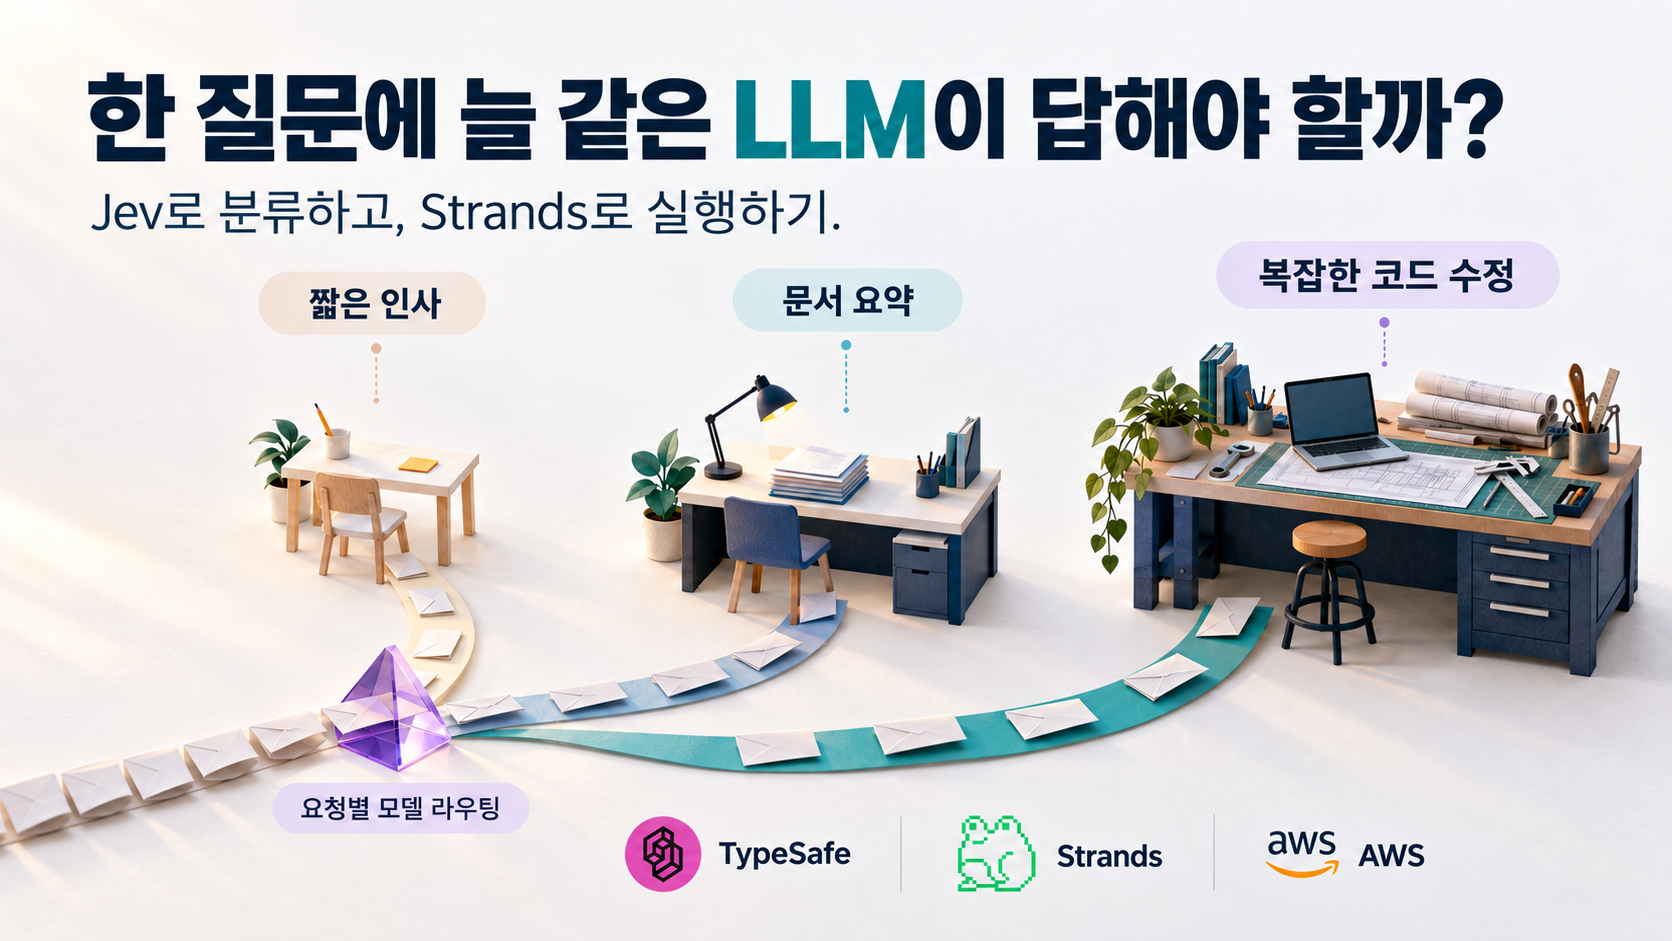
저를 포함한 많은 개발자가 Claude Code, Codex, Kiro, Antigravity 같은 AI 코딩 도구를 사용합니다. 어떤 도구와 모델을 고를지는 공개된 평가 자료, 동료의 후기, 직접 사용해 본 경험에 따라 달라집니다. 그 과정에는 한 가지 가설이 숨어 있습니다. 하려는 작업에 따라 적합한 LLM이 다를 수 있다는 것입니다.
모델이나 추론 강도를 달리 고르는 이유는 크게 두 가지입니다.
- 비용: 예산에 한도가 있으므로 모든 작업에 가장 비싼 모델을 쓸 수 없습니다.
- 시간: 빠른 응답이 중요한 작업에서는 더 가벼운 모델이나 낮은 추론 강도가 나을 수 있습니다.
실제 서비스는 코딩 도구보다 더 다양한 요청을 받습니다. “요청에 맞는 모델을 고르면 필요한 답의 수준을 유지하면서 비용과 시간을 줄일 수 있을까”라는 질문에 따라 LLM 라우팅을 조사했고, 미리 정한 선택지 중 하나를 판정하는 TypeSafe.ai의 모델 Jev를 Strands Agents에 연결해 요청마다 모델을 선택하는 코드를 만들었습니다. 앞부분은 LLM을 사용해 본 독자를 위한 개념 설명이고, 뒷부분은 Strands를 쓰는 개발자를 위한 실제 구현과 실행 기록입니다. Strands를 처음 접한다면 Agent는 모델을 사용해 요청과 도구 호출을 수행하는 객체라고 생각하면 됩니다.
라우팅은 언제, 무엇을 보고, 어떻게 고를까
LLM 라우팅은 여러 후보 중 이번 일을 처리할 모델을 선택하는 일입니다. 모델 라우팅 서베이에서는 세 가지 질문으로 라우팅 방법을 구분합니다.
| 축 | 질문 | 예 |
|---|---|---|
| 언제 | 어느 시점에 고르는가? | 설계 시 역할별 고정, 생성 전 요청별 선택, 생성 후 승격, 하위 작업마다 재선택 |
| 무엇을 보고 | 어떤 신호를 쓰는가? | 요청 내용, 모델의 기능·가격·가용성, 생성된 답, 이전 실행 결과 |
| 어떻게 | 선택을 어떻게 계산하는가? | 키워드·규칙, 임베딩 유사도, 별도 판정 모델, 학습된 라우터 |
언제: 첫 답 전인가, 답을 본 후인가
- 설계 시: 요약은 A, 코드 작성은 B처럼 역할별 모델을 미리 고정합니다.
- 생성 전: 이번 요청을 읽고 첫 답을 만들 모델을 고릅니다. 이번에는 이 방식을 구현했습니다.
- 생성 후: 첫 답을 검사하고 부족할 때 더 강한 모델에 다시 맡깁니다. 더 강한 모델에 다시 맡기는 요청에는 검사와 재생성 비용이 추가됩니다.
- 실행 중: 긴 작업을 나눈 뒤 하위 작업마다 담당 모델을 다시 고릅니다.
무엇을 보고: 결정 시점에 가진 정보
- 요청 자체: 사용자가 요구한 작업, 입력 형식, 도구 사용 여부와 컨텍스트 길이를 봅니다.
- 모델 정보: 후보 모델의 기능, 가격, 현재 접근 가능 여부를 봅니다.
- 실행 결과: 첫 답과 검증 결과, 앞 단계의 출력도 모델을 고르는 데 쓸 수 있습니다. 다만 이 정보는 답을 생성한 뒤나 다음 하위 작업을 고를 때 사용할 수 있고, 첫 답을 만들기 전에는 알 수 없습니다.
어떻게: 분류 라벨과 모델 연결은 별개
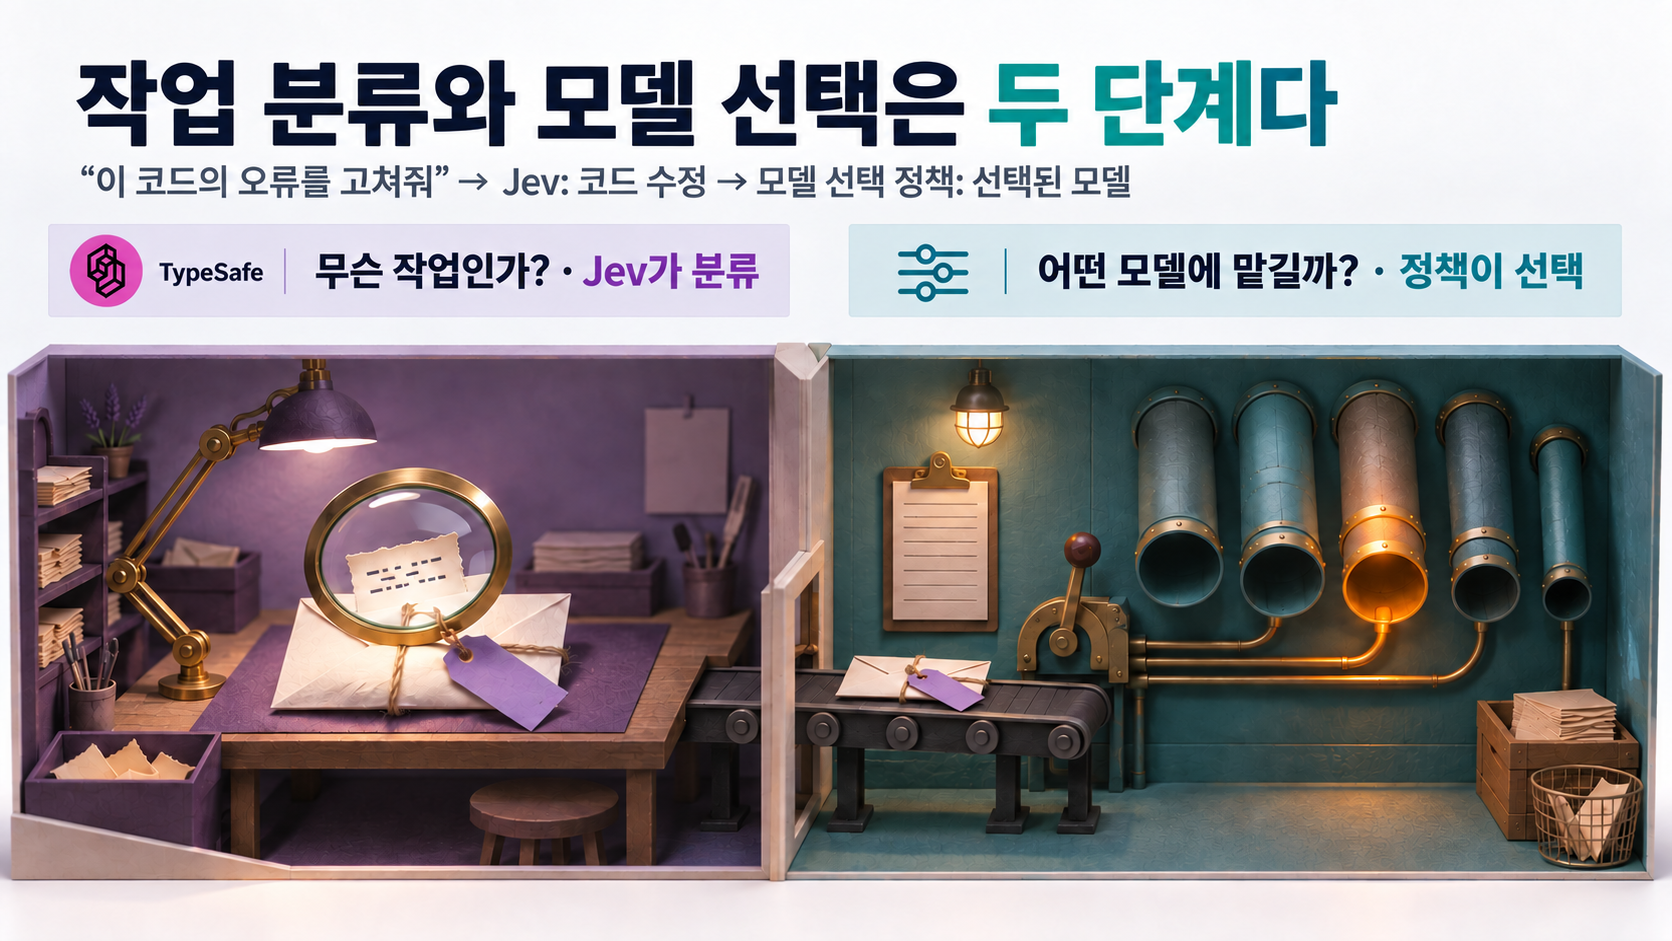
- 요청 분류: 키워드, 임베딩 유사도, 휴리스틱 점수 또는 Jev 같은 판정 모델로
task나tier라벨을 정합니다. 각 방법의 장단점은 아래에서 살펴봅니다. - 모델 매핑: 그 라벨에 맞는 모델 중 기능과 접근 조건을 만족하는 후보를 남기고, 순위나 비용 정책에 따라 실제로 사용할 모델을 고릅니다.
이번 구현은 Strands Agent의 첫 모델 호출 전에 Jev가 task를 판정하고, 적격 후보 중 모델 하나를 선택합니다.
기존 제품과 무엇이 다른가
읽기 전: 이 글의 Bedrock Runtime과 Bedrock Mantle은 모두 AWS의 모델 호출 경로입니다. Mantle은 OpenAI 호환 API를 제공합니다. 뒤의 표에서는 서울 리전의 Runtime 후보와 미국 동부 리전의 Mantle 후보를 구분합니다.
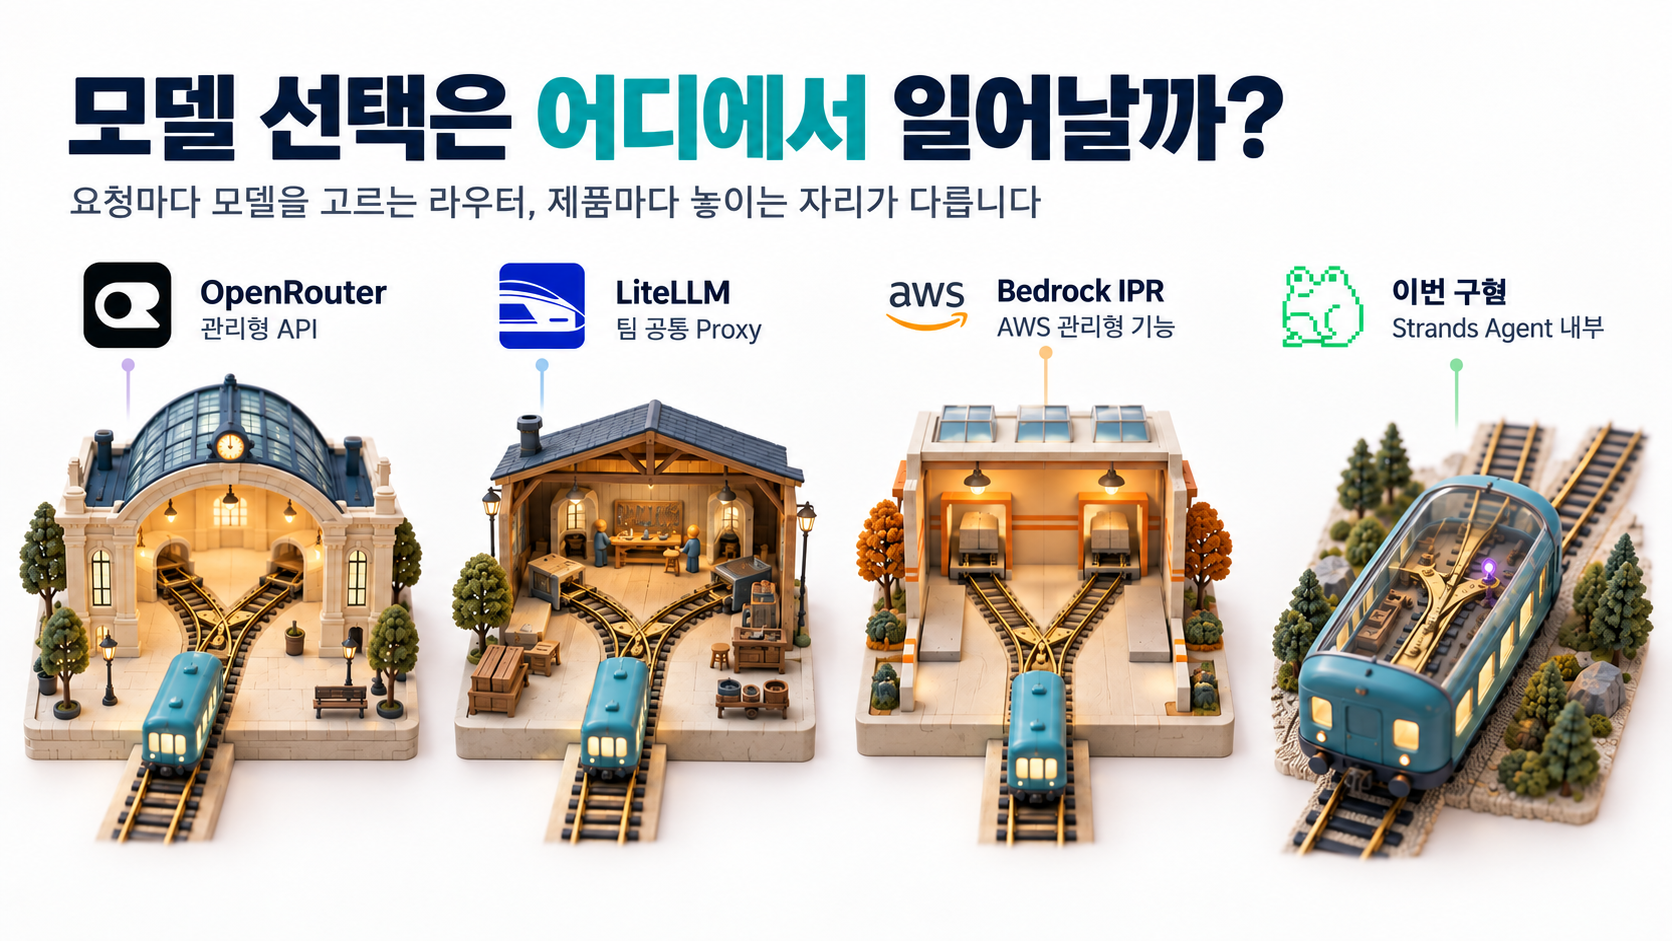
| 선택지 | 라우터 위치 | 선택 방식과 범위 | 어떤 경우에 맞는가 |
|---|---|---|---|
| OpenRouter Auto Router | 관리형 API | 작업 분류, 시장의 모델 지출 신호, 기능·비용 조건 등을 반영 | 관리형 API에서 여러 공급자의 모델을 선택하고 싶을 때 |
| LiteLLM Auto Router | 팀이 운영하는 Proxy | 설정한 후보·분류기·운영 정책으로 요청별 선택; Jev 분류기도 지원 | 팀 공통 Proxy에서 후보와 분류 정책을 함께 운영할 때 |
| Bedrock Intelligent Prompt Routing(IPR) | AWS 관리형 기능 | 같은 계열의 두 모델 사이에서 예상 응답 품질 차이로 선택 | 지원되는 같은 계열의 모델 두 개를 AWS 안에서 선택할 때 |
| 이번 구현 | Strands Agent의 ModelRouter |
Jev 판정과 현재 접근 가능한 Bedrock Runtime 또는 Mantle 후보를 연결 | Agent의 선택 조건과 기록을 애플리케이션 코드에서 다룰 때 |
OpenRouter: 모델 선택과 공급자 선택
openrouter/auto는 요청의 작업 유형을 분류한 뒤 집계 지출, 모델 기능과 비용 구간 등을 반영해 모델을 고릅니다. 이와 별개로 이미 정한 모델의 공급자를 처리량이나 가격 기준으로 정렬할 수도 있습니다. 어떤 모델을 쓸지 고르는 것과, 그 모델을 어느 공급자를 통해 호출할지 고르는 것은 서로 다른 단계입니다.
LiteLLM: 팀이 정한 분류와 배포본 정책
LiteLLM Auto Router에서는 예를 들어 요청을 난이도 tier로 분류하고 각 tier에 보낼 모델을 팀이 설정할 수 있습니다. Jev도 분류기로 선택할 수 있습니다. 별도의 Router는 같은 모델 이름으로 묶은 배포본을 부하·지연·비용 등의 기준으로 고릅니다. Proxy의 설정과 운영은 팀이 맡습니다.
Bedrock IPR: 같은 계열의 두 모델
Bedrock IPR은 같은 계열의 모델 두 개와 기본 모델, responseQualityDifference 기준을 설정하면 AWS가 요청별 예상 응답 품질을 비교해 선택합니다. AWS 문서에 따르면 영어 프롬프트에 최적화되어 있으며, 각 애플리케이션의 성능 데이터를 반영해 모델 선택을 조정하지는 않습니다. 이번 구현에서는 여러 계열의 모델을 함께 후보로 두었으므로, 모델을 고를 수 있는 범위가 다릅니다.
이번 구현은 OpenRouter의 29개 작업 유형별 7일 사용 점유율 순위를 사용했습니다. 순위에 나온 모델을 AWS 모델에 매핑하고, 현재 접근할 수 있으면서 요청에도 맞는 모델만 후보로 남겼습니다. 사용 점유율은 답변 품질 점수가 아닙니다.
Jev를 요청 분류에 쓰는 이유
‘어떻게 고를까’에 해당하는 요청 분류 방법에는 각각 다음과 같은 장점과 한계가 있습니다.
- 키워드: 빠르고 어떤 규칙이 적용됐는지 설명하기 쉽습니다. 하지만 정해 둔 표현과 다른 말로 요청하면 놓칠 수 있습니다. 그래서 동의어와 규칙을 관리해야 합니다.
- 임베딩: 문장 표현이 달라도 의미가 가까운 요청을 찾을 수 있습니다. 다만 임베딩 처리에도 시간과 비용이 들며, 비교할 문장·앵커와 판정 문턱을 직접 설계해야 합니다.
- 휴리스틱: 가장 대표적인 신호는 요청 길이입니다. 여기에 코드 블록 포함 여부나 디버깅·SQL 같은 작업 관련 표현을 더해 빠르게 판단할 수 있습니다. 실제 구현에서도 이들 신호에 가중치를 줍니다. 다만 같은 코드 블록도 설명 요청이나 오류 수정일 수 있으므로, 작업 영역마다 신호와 가중치를 정하고 유지해야 합니다.
- LLM 분류기: 요청의 문맥을 읽어 유연하게 판정할 수 있습니다. 다만 답을 생성할 모델을 호출하기 전에 분류 모델도 따로 호출해야 하므로, 비용과 지연이 추가됩니다. 출력 형식 오류에도 대비해야 합니다.
반면 TypeSafe의 Jev는 미리 정의한 선택지 중 하나와 confidence를 구조화해 반환합니다. 저는 키워드 사전이나 영역별 임베딩 앵커를 직접 만들지 않고, 29개 작업 유형을 선택지로 주어 요청을 판정했습니다. Jev도 외부 서비스를 호출하는 방식이므로 입력 비용과 지연이 추가되며, 사용자 요청이 AWS 밖으로 전달됩니다. 작업 유형, 모델 매핑, 판정 문턱 역시 직접 설계해야 합니다.
실제 코드에서는 어디에 끼웠을까
읽기 전: 아래 코드는 구현에서 연결 부분만 발췌했습니다. 그대로 독립 실행할 수 있는 전체 코드는 아닙니다.
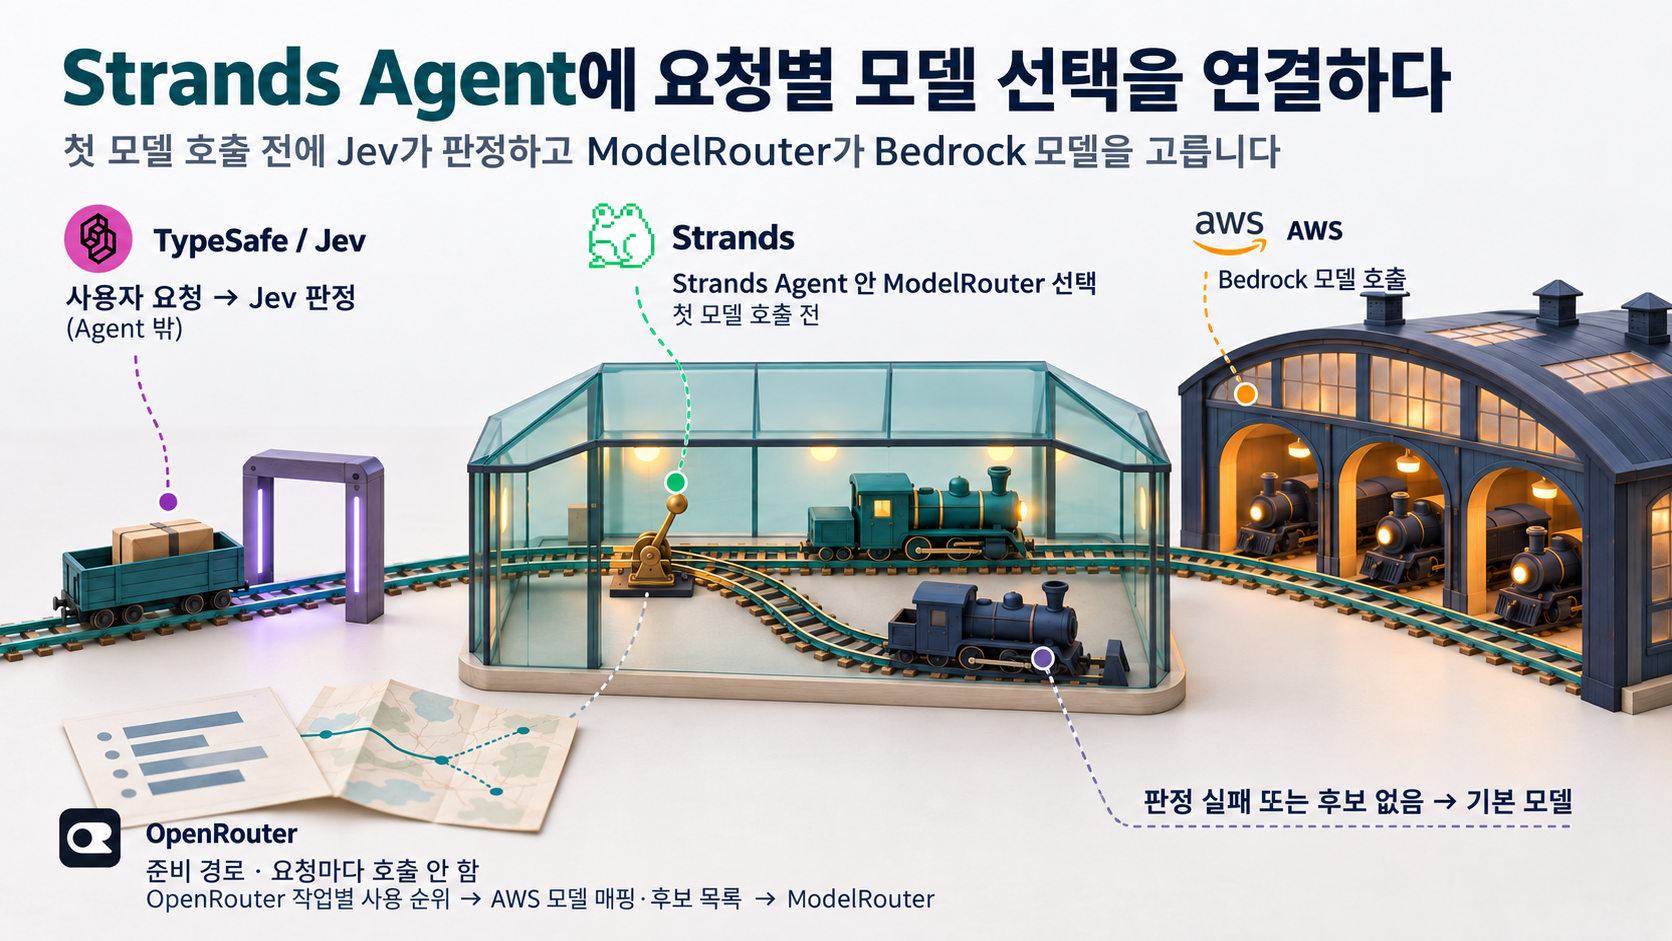
Strands의 ModelRouter 선택 지점에 Jev 판정을 연결했습니다.
class _JevStrategy:
    def __init__(self, router):
        self._router = router

    async def select(self, context, **kwargs):
        return await self._router._select(context)


class JevRouter(ModelRouter):
    def __init__(self, config, state):
        self._config = config
        self._state = state
        self._strategy_impl = (
            TaskStrategy() if config.strategy == "task" else ModelStrategy()
        )
        super().__init__(
            models=state.routing_candidates,
            strategy=_JevStrategy(self),
            max_switches=0,
)ModelRouter가 select()를 호출하면, 이번 요청의 도구·입력 형식·컨텍스트 길이에 맞지 않는 후보를 먼저 제외하도록 구현했습니다. 이어서 Jev에 선택지를 보내고, 응답과 confidence를 확인합니다. TypeSafe SDK를 부르는 핵심 부분은 다음과 같습니다.
question = Choice(criteria=dict(options), instructions=instructions)
response = await client.system_one(
    state=state,
    questions={"route": question},
    model=model,
)
Jev의 판정을 실제 모델 선택에 연결하는 방식은 다음과 같습니다.
task전략: Jev가 29개 작업 유형 중 하나를 고르고, 해당 task의 OpenRouter 순위와 AWS 후보의 교집합에서 모델을 선택합니다.model전략: Jev가 이번 요청의 적격 후보 중 모델을 직접 고릅니다.- 판정 fallback: Jev 판정 실패, 낮은 confidence, 순위에 맞는 후보가 없는 경우 지정한 기본 모델을 씁니다.
여기서 판정 실패와 선택된 모델의 생성 호출 실패는 구분해야 합니다. 이 구현은 생성 호출이 실패했을 때 다른 모델로 자동 교체하지 않습니다(max_switches=0).
실제로 실행한 한 요청
읽기 전: 다음 기록은 2026년 9월 30일 서울 리전의 한 AWS 계정에서 Bedrock 접근 권한과 TypeSafe 키를 설정해 실행한 결과입니다. 모델 ID와 결과는 계정·시점마다 달라질 수 있습니다.
다음은 Agent를 실제로 호출한 코드의 핵심 부분입니다.
from strands import Agent
from strands_model_router import build_router

records = []
router = build_router(
    default_model="global.openai.gpt-5.6-luna",
    bedrock_region="ap-northeast-2",
    endpoints="bedrock",
    strategy="task",
    on_decision=records.append,
)
agent = Agent(model=router, callback_handler=None)
answer = str(agent("안녕하세요. 한 문장으로 인사해 주세요.")).strip()
print(answer)
print(records[0]["task"], records[0]["selected_candidate"])
실행 기록에 저장된 출력은 다음과 같습니다.
안녕하세요! 만나서 반갑습니다.
conversational_reply ['bedrock', 'ap-northeast-2', 'global.openai.gpt-6-luna']default_model의 GPT-5.6 Luna는 판정이나 후보 선택이 실패했을 때 쓸 기본 모델입니다. Jev는 이번 요청을 대화 응답 작업으로 판정했고(confidence 0.99), Strands Agent가 GPT-6 Luna를 한 번 호출했습니다. 이 인사 한 건으로 답변 품질이나 비용 절감 효과를 판단할 수는 없습니다.
시간과 비용은 어떻게 읽어야 할까
별도로 측정한 한국어 요청 145건에서는 task 전략의 Jev 판정 지연이 중앙값 312ms, p95 514ms였습니다. 여기서 측정한 시간은 분류 단계에 걸린 시간입니다. 위 Agent 호출의 전체 소요 시간이나 모델이 답을 생성하는 시간은 포함하지 않습니다. 한 계정·한 리전·한 시점의 측정값입니다.
비용은 공개된 단가를 기준으로 계산해 볼 수 있습니다. TypeSafe가 공개한 Jev 입력 단가는 2026년 10월 1일 확인 기준 100만 입력 토큰당 $0.042이고 출력은 별도 토큰 요금이 없습니다. AWS의 Global CRIS(Global Cross-Region Inference, 전 세계 리전 간 추론) 짧은 컨텍스트 단가는 모델별로 다음과 같습니다. 단위는 모두 100만 토큰당 달러이며, 이번 계산에는 캐시 요금을 적용하지 않았습니다.
| 모델 | 입력 100만 토큰 | 출력 100만 토큰 |
|---|---|---|
| GPT-5.6 Luna | $0.20 | $1.20 |
| GPT-6 Luna | $0.10 | $0.50 |
| GPT-5.6 Sol | $4.00 | $20.00 |
계산 예시일 뿐인 가정: Jev 입력 1,000토큰, 선택 모델 입력 1,000토큰·출력 100토큰인 단일 호출이라면 Jev 약 $0.000042 + 생성 약 $0.000150 = 합계 약 $0.000192입니다. 이 금액은 위 인사 실행에서 실제로 청구된 금액이 아닙니다. 도구 사용, 재시도, 캐시, 컨텍스트 길이, 선택 모델과 계약 단가에 따라 총액은 달라집니다.
29개 작업 유형을 분류한 기록 145건을 바탕으로, 모델을 하나로 고정했을 때의 비용도 비교해 봤습니다. 선택 기록에는 GPT-5.6 Luna 84건(기본 모델 선택 15건 포함), GPT-6 Luna 56건, GPT-5.6 Sol 5건이 남았습니다. 비교 기준은 이 기록에서 선택된 모델 중 가장 비싼 GPT-5.6 Sol을 모든 요청에 사용하는 경우로 잡았습니다. 모델마다 입력 1,000토큰·출력 100토큰, 라우팅에는 요청당 Jev 입력 1,000토큰을 추가한다고 가정하고, 위의 Bedrock Global CRIS 단가를 적용했습니다.
| 방식 | 생성 모델 비용 | Jev 비용 | 합계 |
|---|---|---|---|
| GPT-5.6 Sol 고정 | $0.87000 | $0 | $0.87000 |
| 기록된 모델 선택 분포 | $0.06528 | $0.00609 | $0.07137 |
같은 조건에서는 라우팅 쪽 계산액이 약 91.8% 낮습니다. 다만 이 task 전략으로 선택한 모델에는 Claude가 없었습니다. 그 이유는 아래에서 설명하겠습니다. 따라서 이 수치는 제한된 후보 분포와 GPT-5.6 Sol 고정 기준으로 계산한 값입니다. 여러 공급자를 공평하게 비교한 절감률로 볼 수는 없습니다. 또한 145건은 모델 선택까지만 실행했고 답변은 생성하지 않았습니다. 이 계산만으로 실제 절감액이나 같은 답변 품질을 증명할 수는 없습니다. 고정할 모델이나 출력 길이·재시도·품질 요구가 달라지면 비용 차이도 달라집니다.
비용 최적화 가설은 아직 검증 중입니다. 현재 선택 정책은 실제 토큰 가격을 최소화하는 최적화기가 아니라, Jev 판정과 작업별 사용 순위, 후보가 요청에 적합한지를 기준으로 모델을 고르는 라우터입니다. 처음의 가설에 답하려면, 답변 품질과 Jev 비용을 포함한 총비용을 모델을 고정한 경우와 같은 조건에서 비교해야 합니다.
참고: 29개 작업 유형의 후보 교집합과 판정 결과
읽기 전: 아래 표의 교집합은 OpenRouter의 작업별 7일 사용 점유율 상위 10개와 AWS 모델 ID를 매핑한 뒤, 서울 Bedrock Runtime과 미국 동부 Mantle 후보에서 겹치는 모델을 센 결과입니다. 판정 결과는 서울 Bedrock Runtime 후보만 사용한 한국어 145건(작업 유형당 5건)의 분류 전용 측정입니다. Mantle 후보 수가 있어도 145건을 Mantle에서 생성했다는 뜻은 아닙니다.
왜 Claude 모델은 표에 없을까
- 집계 기준: 실험에 사용한 7일 사용 점유율 순위에서는 29개 작업 유형의 상위 10개 목록 어디에도 Claude가 없었습니다. 별도로 조사한 30일 지출 순위에는 Claude가 29개 유형 모두에 등장합니다. 집계 기간과 지표가 다르므로 두 순위를 같은 결과로 보면 안 됩니다.
- ID 매핑: 서울 Bedrock 후보에는 Claude가 있었지만, 이번 OpenRouter→AWS 모델 매핑 표에는 Claude가 없습니다. 순위에 Claude가 나타나더라도 매핑을 추가하지 않으면
task전략의 선택 대상이 되지 않습니다. - 전략 차이: 이 표의
task전략은 145건 중 Claude를 0건 골랐습니다. 같은 입력에서 Jev가 적격 모델을 직접 고르는 별도model전략은 Claude를 91건 골랐습니다. Claude를 사용할 수 없어서가 아니라, 두 전략이 후보를 고르는 방식이 달랐기 때문에 나온 결과입니다.
따라서 아래 표의 교집합과 모델 순위 일치율은 7일 순위와 검증된 ID 매핑을 모두 통과한 후보 안에서의 결과입니다. Claude를 포함한 모든 AWS 모델의 우열이나 답변 품질을 비교한 결과가 아닙니다.
후보 칸 읽는 법: 1개 · GPT-6 Luna (원순위 10위)는 OpenRouter 상위 10개 중 해당 AWS 경로와 겹친 모델이 1개라는 뜻입니다. 그중 순위가 가장 높은 모델은 GPT-6 Luna이고, 후보를 걸러내기 전 OpenRouter 사용 점유율 10위였다는 뜻입니다. 원순위는 품질 순위가 아닙니다. 0개는 AWS 모델이 전혀 없다는 뜻이 아니라 이 조건의 교집합이 없다는 뜻입니다.
분류·태깅 작업을 예로 들면 서울에서는 10위 GPT-6 Luna 하나가, Mantle에서는 7위 GPT OSS 120B·8위 Gemma 4 31B·10위 GPT-6 Luna 세 개가 겹칩니다. Mantle 칸에는 그중 7위 모델만 대표로 적었습니다. 실제 요청에서는 입력 형식이나 도구 사용 조건에 따라 이 대표 모델이 제외될 수 있습니다.
판정 칸 읽는 법: 각 작업 유형에 준비한 요청은 5건이므로 5/5에서 분모 5는 준비한 요청 수입니다.
- task 라벨 일치: Jev가 고른 작업 유형이 준비한 라벨과 같은 건수입니다.
- 모델 순위 일치: 실제 선택 모델이 준비한 작업 라벨 기준 서울의 1위 적격 후보와 같은 건수입니다. 준비한 라벨에 서울 교집합이 없으면 비교 불가입니다.
- 기본 모델 선택: 순위에 해당하는 후보가 없는 등의 이유로 지정한 기본 모델을 쓴 건수입니다.
다른 작업으로 잘못 분류해도 두 작업의 최상위 모델이 같으면 모델 순위는 일치할 수 있습니다. 기본 모델 선택 건수도 5건보다 작을 수 있습니다.
| 작업 유형 | Bedrock 서울 교집합 | Mantle 미국 동부 교집합 | task 라벨 일치 | 모델 순위 일치 | 기본 모델 선택 |
|---|---|---|---|---|---|
분류·태깅classification_tagging |
1개 · GPT-6 Luna (원순위 10위) | 3개 · GPT OSS 120B (원순위 7위) | 5/5 | 5/5 | 0/5 |
데이터 추출data:extraction |
1개 · GPT-6 Luna (원순위 10위) | 2개 · GPT OSS 120B (원순위 7위) | 5/5 | 5/5 | 0/5 |
워크플로 실행agent:workflow_execution |
2개 · GPT-5.6 Luna (원순위 7위) | 2개 · GPT-5.6 Luna (원순위 7위) | 5/5 | 5/5 | 0/5 |
역할극·창작roleplay_fiction |
0개 | 2개 · DeepSeek V3.2 (원순위 6위) | 4/5 | 비교 불가 | 4/5 |
콘텐츠 작성content_writing |
2개 · GPT-6 Luna (원순위 7위) | 2개 · GPT-6 Luna (원순위 7위) | 5/5 | 5/5 | 0/5 |
데이터 변환data:transformation |
2개 · GPT-5.6 Luna (원순위 5위) | 3개 · GPT-5.6 Luna (원순위 5위) | 5/5 | 5/5 | 0/5 |
코드 생성code:general_impl |
3개 · GPT-5.6 Luna (원순위 2위) | 3개 · GPT-5.6 Luna (원순위 2위) | 5/5 | 5/5 | 0/5 |
다단계 계획agent:multi_step_planning |
2개 · GPT-5.6 Luna (원순위 4위) | 2개 · GPT-5.6 Luna (원순위 4위) | 5/5 | 5/5 | 0/5 |
질의응답·지식qa_knowledge |
2개 · GPT-5.6 Luna (원순위 6위) | 3개 · GPT-5.6 Luna (원순위 6위) | 5/5 | 5/5 | 0/5 |
번역translation |
2개 · GPT-6 Luna (원순위 5위) | 3개 · Gemma 3 4B (원순위 4위) | 5/5 | 5/5 | 0/5 |
대화 응답conversational_reply |
1개 · GPT-6 Luna (원순위 7위) | 1개 · GPT-6 Luna (원순위 7위) | 5/5 | 5/5 | 0/5 |
디버깅code:debugging |
3개 · GPT-5.6 Luna (원순위 3위) | 3개 · GPT-5.6 Luna (원순위 3위) | 5/5 | 5/5 | 0/5 |
요약summarization |
2개 · GPT-5.6 Luna (원순위 6위) | 4개 · Gemma 4 26B (원순위 5위) | 5/5 | 5/5 | 0/5 |
파일 입출력code:file_read_write |
2개 · GPT-5.6 Luna (원순위 9위) | 2개 · GPT-5.6 Luna (원순위 9위) | 0/5 | 5/5 | 0/5 |
고객 지원customer_support |
2개 · GPT-5.6 Luna (원순위 2위) | 2개 · GPT-5.6 Luna (원순위 2위) | 5/5 | 5/5 | 0/5 |
코드 리뷰code:review_security |
1개 · GPT-5.6 Luna (원순위 2위) | 2개 · GPT-5.6 Luna (원순위 2위) | 5/5 | 5/5 | 0/5 |
셸 실행code:shell_execution |
0개 | 0개 | 2/5 | 비교 불가 | 2/5 |
도구 선택·호출agent:tool_dispatch |
2개 · GPT-5.6 Luna (원순위 1위) | 2개 · GPT-5.6 Luna (원순위 1위) | 5/5 | 5/5 | 0/5 |
금융·트레이딩finance_trading |
1개 · GPT-5.6 Luna (원순위 8위) | 3개 · GPT OSS 120B (원순위 3위) | 5/5 | 5/5 | 0/5 |
메모리 추출agent:memory_extraction |
0개 | 1개 · Gemma 4 26B (원순위 3위) | 5/5 | 비교 불가 | 5/5 |
프런트엔드·UIcode:frontend_ui |
2개 · GPT-6 Luna (원순위 6위) | 2개 · GPT-6 Luna (원순위 6위) | 5/5 | 5/5 | 0/5 |
조사·보고서research_report |
2개 · GPT-6 Luna (원순위 5위) | 2개 · GPT-6 Luna (원순위 5위) | 5/5 | 5/5 | 0/5 |
웹 검색agent:web_search |
3개 · GPT-6 Luna (원순위 6위) | 3개 · GPT-6 Luna (원순위 6위) | 4/5 | 4/5 | 0/5 |
저장소 탐색code:repo_scan |
2개 · GPT-6 Luna (원순위 7위) | 2개 · GPT-6 Luna (원순위 7위) | 5/5 | 5/5 | 0/5 |
보안 감사security_audit |
0개 | 2개 · Gemma 4 31B (원순위 8위) | 4/5 | 비교 불가 | 4/5 |
수학math |
1개 · GPT-5.6 Luna (원순위 1위) | 2개 · GPT-5.6 Luna (원순위 1위) | 5/5 | 5/5 | 0/5 |
SQL·데이터베이스code:sql_database |
2개 · GPT-6 Luna (원순위 1위) | 2개 · GPT-6 Luna (원순위 1위) | 5/5 | 5/5 | 0/5 |
개발·운영 설정code:devops_config |
2개 · GPT-5.6 Sol (원순위 4위) | 2개 · GPT-5.6 Sol (원순위 4위) | 5/5 | 5/5 | 0/5 |
개발·운영devops |
1개 · GPT-6 Luna (원순위 9위) | 1개 · GPT-6 Luna (원순위 9위) | 4/5 | 5/5 | 0/5 |
표의 결과를 정리하면 다음 네 가지입니다.
- 후보 교집합: 서울 Bedrock은 25/29개, Mantle
us-east-1은 28/29개 작업 유형에서 순위에 나온 후보가 하나 이상 겹쳤습니다. - task 판정: Jev의 task 라벨은 준비한 라벨과 133/145건 일치했습니다.
- 모델 선택: 서울 교집합이 있는 25개 작업 유형의 요청 125건 중 124건에서 선택 모델이 준비한 작업 라벨의 1위 적격 후보와 같았습니다. 나머지 4개 유형의 20건은 비교할 서울 후보가 없습니다. 이 수치는 답변 품질의 정답률이 아니라 모델 선택 로직을 확인하기 위한 기준선입니다.
- 기본 모델 선택: 순위에 해당하는 후보가 없는 등의 이유로 15/145건에서 기본 모델을 선택했습니다.
code:file_read_write 5건은 Jev가 모두 code:general_impl로 잘못 분류했습니다. 그런데 두 작업의 서울 1위 후보가 GPT-5.6 Luna로 같아서 표에는 task 라벨 0/5, 모델 순위 5/5가 함께 나옵니다. 잘못 분류한 일부 요청에서도 confidence가 높았습니다. 그래서 confidence 문턱만으로는 이 오류를 걸러낼 수 없었습니다. 사용 순위와 confidence를 사용하더라도 작업 라벨이나 최종 답의 품질이 자동으로 보장되지는 않습니다.
이 측정에서는 분류 전용으로 실행했으므로, 답변 생성 품질이나 비용 절감률을 증명할 수는 없습니다. 후보 탐색과 접근 확인을 통과해도 실제 생성 호출은 계정 설정 때문에 거부될 수 있습니다.
마치며
이번에는 “Agent가 요청마다 모델을 고르고 그 이유를 남길 수 있는가”라는 질문에 답하는 코드를 구현했습니다. 다른 계정이나 작업 분포에서도 같은 결과가 나오는지, 선택된 모델의 답이 충분한지, 판정 비용까지 더한 총비용이 실제로 줄어드는지는 따로 검증해야 합니다. 그리고 Jev가 판정할 때는 마지막 사용자 메시지의 글과 첨부된 텍스트 문서가 AWS 밖 TypeSafe로 전달됩니다. 따라서 데이터 경계가 맞지 않는 서비스에는 이 구성을 그대로 적용하면 안 됩니다.