
1. 들어가며
CloudFlare를 운영하다 보면, 콘솔을 열어 Zone을 고르고 메뉴를 몇 단계 들어가 값을 확인하는 반복 작업이 쌓입니다. 운영 대상 도메인이 수백 개가 되면 “지금 어느 도메인의 어떤 설정이 어떤 상태인가”를 즉석에서 확인하는 것 자체가 일이 됩니다. 그래서 운영팀이 평소 쓰는 메신저에서 평소 쓰는 말로 물으면 바로 답을 받을 수 있는 AI 운영 에이전트(AI Operations Agent)를 만들고 있습니다.
“특정 도메인의 DNS 레코드 보여줘”, “최근 6시간 캐시 절감율은?”, “지난 24시간 트래픽이 많은 상위 국가는?”, “이 Zone의 WAF 차단 이벤트 상위 10건” 같은 질문을 던지면, 에이전트가 CloudFlare API와 GraphQL Analytics를 조회해 정리된 답을 돌려줍니다. 단건 조회부터 여러 리소스를 묶어 보는 결합 조회까지 폭넓게 처리하는 것이 목표입니다. 조회뿐 아니라 설정 변경 같은 수정 작업도 다루지만, 수정은 사람의 승인을 거치도록 안전장치를 두었습니다(섹션 6).
특징은 별도의 추가 인프라 없이 CloudFlare 생태계(Workers / D1 / Queue / Workers AI) 위에만 올려 구성했다는 점입니다. 운영 대상인 CloudFlare와 같은 플랫폼 위에서 에이전트가 돌아가므로, 외부에 서버를 따로 두거나 네트워크 경계를 새로 뚫을 필요가 없었습니다.
이번 글은 조회(Read)와 수정(Write)을 처리하는 에이전트까지 다룹니다. 서비스 운영의 출발점이 되는 고객 지원 티켓을 학습해 유사 사례 기반으로 진단 및 가이드를 제시하는 티켓 RAG는 다음 편에서 따로 소개하겠습니다. 그래서 이 글에서는 조회와 수정을 어떻게 정확하고 안전하게 만들어 갔는지에 집중합니다. 특히 설계대로 되지 않아 실제로 부딪힌 함정과 그 과정도 일부 같이 포함했습니다.
2. 왜 Code Mode인가
2.1 CloudFlare가 제공하는 공식 MCP 서버
CloudFlare는 제품 영역별로 여러 공식 MCP 서버를 제공합니다. 2026년 현재 16개가 공개되어 있는데, 운영·조회와 관련이 깊은 것들만 추리면 다음과 같습니다(전체 목록은 공식 저장소 참고).
| 서버 | 용도 |
|---|---|
| Code Mode (권장) | CloudFlare API 전반을 코드 실행으로 폭넓게 접근 |
| Documentation | CloudFlare 공식 문서 참조 |
| Observability | 로그·애널리틱스 디버깅 |
| AI Gateway | 프롬프트·응답 로그 검색 |
| DNS Analytics | DNS 성능 최적화·디버그 |
| Radar | CloudFlare Radar 인터넷 인사이트 |
도메인별 서버는 각 제품 영역에 맞는 타입드 도구(typed tool)를 제공합니다. 반면 Code Mode 서버는 도구 수를 최소화하는 대신, LLM이 CloudFlare API를 직접 호출하는 코드를 생성해 실행하는 방식으로 넓은 API 커버리지를 확보합니다. 주목할 점은 CloudFlare가 이 Code Mode를 공식 권장(recommended)으로 표기하고 있다는 것입니다.
2.2 왜 도메인별 서버 대신 Code Mode를 택했는가
도메인별 서버를 여럿 연결해 쓰는 것도 선택지였지만, 운영 에이전트에는 맞지 않았습니다. 그 이유는 다음과 같습니다.
- 운영자의 질의를 미리 예측할 수 없습니다. “이 Zone의 캐시 절감율은?”처럼 깔끔하게 한 카테고리에 떨어지는 질문만 오지 않습니다. “이 도메인의 DNS는 몇 개이고 SSL은 뭐고 캐시 설정은 어떤지 한 번에 보여줘” 같은 교차 질의도 오고, “지난 24시간 5xx 에러가 많은 호스트별로 WAF 이벤트도 같이 보여줘” 같은 결합 질의도 옵니다. 도메인별 서버를 조합하면 매 질의마다 어느 서버를 부를지 라우팅해야 하고, 교차 질의는 여러 서버를 오가야 합니다.
- Code Mode 하나로 CloudFlare API 전반을 코드로 접근하면, 어떤 조합의 질의가 와도 하나의 코드 블록으로 처리할 수 있습니다. 새로운 조회 유형이 생겨도 Tool을 추가·배포할 필요 없이 LLM이 코드로 즉시 대응합니다.
대신 치러야 하는 대가가 있습니다. LLM이 올바른 코드를 생성하도록 카테고리별 프롬프트 지식을 잘 갖춰야 하고, 그 품질이 결과 품질을 그대로 좌우합니다. 뒤의 섹션 4·5가 바로 이 “프롬프트 지식을 어떻게 쌓았는가”에 대한 이야기입니다.
두 접근의 성격을 정리하면 다음과 같습니다.
| 항목 | 도메인별 MCP Tool 조합 | Code Mode (execute 1개) |
|---|---|---|
| 스키마 사전 정의 | 각 서버가 제공하는 Tool 범위 내로 제한 | 미리 다 정의할 필요 없음 |
| 새 조회 유형 대응 | 해당 서버에 Tool이 없으면 대응 불가 | LLM이 코드로 즉시 대응 |
| 교차·결합 질의 | 여러 서버를 오가며 라우팅 필요 | 하나의 코드 블록에서 처리 |
| 품질을 좌우하는 요소 | Tool 스키마의 커버리지 | 카테고리별 프롬프트 지식의 정확도 |
| CloudFlare 공식 권장 | – | recommended로 표기됨 |
3. 전체 구성
3.1 전체 흐름
전체 조회 파이프라인은 다음과 같이 흐릅니다. 슬랙에서 들어온 자연어 요청이 Worker의 ingestion을 거쳐 Queue에 적재되고, handleQueryTask가 이를 소비합니다. 그다음 의도분류(intent-classifier)가 규칙 1차 판정 후 필요할 때만 LLM으로 폴백하며, 조회(read)로 판정되면 query-handler가 Code Mode로 조회 코드를 생성·실행합니다. 생성된 코드는 MCP execute를 통해 CloudFlare API/GraphQL을 호출하고, 결과를 포맷해 슬랙으로 되돌립니다.
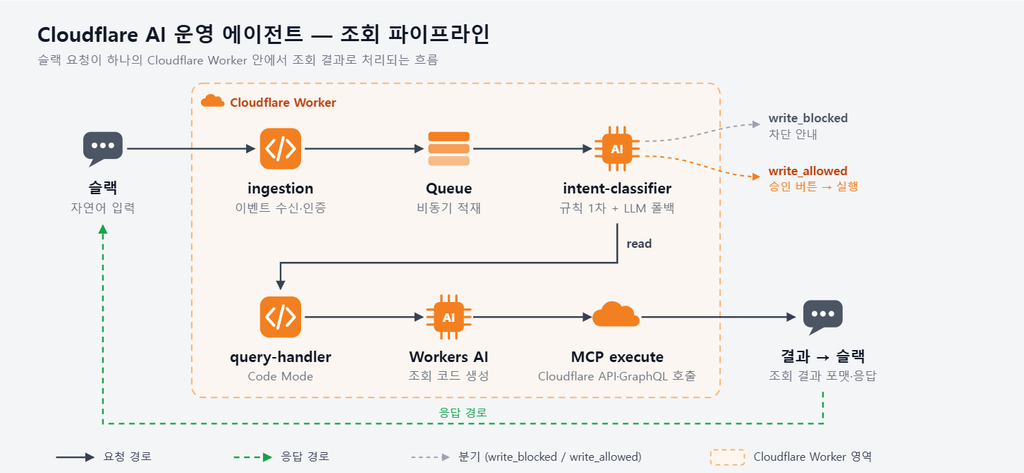
그림 1. 슬랙 자연어 요청이 Worker 큐를 거쳐 Code Mode 조회로 처리되는 파이프라인.
3.2 기술 스택
기술 스택은 다음과 같습니다. 대응되는 AWS 서비스를 같이 표기하여 CloudFlare의 어떤 서비스인지 쉽게 이해할 수 있도록 했습니다.
| 구성요소 | CloudFlare | AWS 대응 | 비고 |
|---|---|---|---|
| 런타임 | Workers | Lambda | V8 isolate 기반 서버리스 |
| 비동기 큐 | Queue | SQS | 슬랙 요청을 비동기 처리 |
| 서버리스 DB | D1 | Aurora Serverless (SQLite 호환) | LLM 토큰 사용량 기록(한도 관리) |
| LLM 추론 | Workers AI | Bedrock | 의도분류 폴백·조회 코드 생성 |
| 벡터 검색 | Vectorize | OpenSearch Serverless / Kendra | 티켓 RAG용(다음 편) |
| 오브젝트 스토리지 | R2 | S3 | 티켓 RAG용(다음 편) |
3.3 LLM 모델 선택
Workers AI에서 제공하는 LLM은 여러 종류가 있으며, 용도에 따라 선택할 수 있습니다. 자주 사용되는 모델 몇 가지를 정리했습니다(Workers AI Models).
| 모델 | 파라미터 | 특징 | 용도 예시 |
|---|---|---|---|
| Llama 3.3 70B Instruct | 70B | speculative decoding으로 2~4배 가속, 범용 성능 | 코드 생성, 분석, 에이전트 (현재 사용 중) |
| Llama 3.2 3B Instruct | 3B | 경량·저비용($0.05/M입력토큰), 빠른 응답 | 분류, 요약, 간단한 대화 |
| Llama 3.2 11B Vision | 11B | 이미지 입력(Vision) 지원 | 이미지 캡셔닝, 스크린샷 분석 |
| Clef 27B | 27B | CloudFlare 자체 개발 멀티모달 의사결정 모델 | 보안 분류, 이미지 판정 |
이 에이전트는 Llama 3.3 70B를 기본 모델로 사용합니다. “모든 모델 중 최선”이라서가 아니라, 다음과 같은 현실적 선택의 결과입니다.
- Workers AI 카탈로그 안에서 범용 성능이 검증된 70B급입니다. Code Mode에서 JS 조회 코드를 생성하고, DNS+Origin 같은 교차 질의를 처리하려면 복잡한 추론이 필요한데, 이 작업에 안정적이었습니다.
- CloudFlare가 speculative decoding으로 가속해, 70B급임에도 응답 속도를 확보할 수 있습니다.
- 경량 모델(3B / 11B)은 의도분류 같은 단순 작업엔 충분하지만, 조회 코드 생성처럼 추론이 필요한 본 작업엔 품질이 부족했습니다.
- 외부 LLM(GPT / Claude)은 코드에 폴백 자리를 열어 두었으나, “CloudFlare 생태계 안에서 처리한다”는 아키텍처 원칙상 당장은 사용하지 않습니다.
다만 모델 간 정량 비교(동일 조건에서 품질·비용·지연 측정)를 끝낸 것은 아니라, 재평가의 여지는 열어 두고 있습니다.
3.4 구성 요소별 참고 사항
몇 가지 오해하기 쉬운 지점을 짚어 둡니다.
- D1의 역할: 조회 결과 데이터를 D1에 저장하지는 않습니다. 조회 결과는 슬랙으로 바로 응답할 뿐입니다. 다만 조회 흐름도 LLM을 호출하므로(조회 코드 생성), LLM을 부를 때마다 D1의
token_usage테이블을 읽어 일일/월간 토큰 한도를 확인하고, 호출 후 사용량을 기록합니다. 즉 D1은 “조회 데이터 저장”이 아니라 토큰 사용량 추적(비용·한도 관리) 용도로 조회 경로에서도 관여합니다. 이 한도 확인은 다음과 같이 동작합니다.- 일일 한도의 80%에 도달하면 Slack 채널에 “⚠️ 일일 토큰 한도 80% 도달” 알림을 자동으로 보냅니다.
- 한도를 초과하면 “⚠️ 토큰 한도를 초과했습니다” 알림을 보내고, 이후 LLM 호출을 차단합니다.
- 소스와 배포본의 관계: 코드 구조는 아래에 있는 소스 트리이고,
wrangler deploy를 하면src/index.ts를 진입점으로 모든 파일이 하나의 JS 번들로 묶여 Worker에 배포됩니다. 카테고리별 프롬프트 지식도 TypeScript 상수 문자열로 코드에 포함되어 번들에 함께 올라갑니다. - Queue 설정: 소비자(consumer)는
max_batch_size = 10,max_batch_timeout = 30으로 동작합니다. 메시지를 최대 10개까지 묶어 처리하되, 10개가 차지 않아도 30초가 지나면 배치를 처리합니다. 이 배치 타임아웃은 “처리 중…” 응답의 체감 지연과도 연결되는 지점이라, 운영 튜닝 시 조정 대상입니다(7.2).
실제로 D1의 token_usage 테이블에는 LLM 호출마다 사용 토큰이 날짜별로 누적됩니다. 아래는 대시보드에서 조회한 실제 적재 결과입니다.
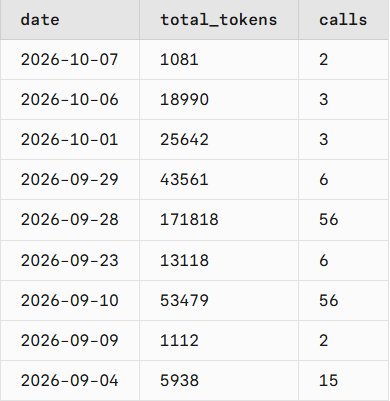
그림 2. D1 token_usage 테이블에 날짜별 토큰 사용량이 기록된 모습. 조회 흐름의 LLM 호출이 여기에 누적되어 일일/월간 한도 관리의 근거가 됩니다.
3.5 에이전트 코드 구조
실제 운영 중인 에이전트의 소스 트리를 조회 흐름 기준으로 추려 보면 다음과 같습니다. 티켓 RAG(다음 편)과 테스트용 모듈은 제외했습니다.
src/
├── index.ts                          # Worker 진입점
├── ingestion/                        # 슬랙 이벤트 수신·인증·파싱
│   ├── index.ts
│   ├── auth-verifier.ts
│   ├── interactivity.ts              # 승인 버튼 상호작용 처리
│   └── parsers.ts
├── agent/                            # 핵심 에이전트 로직
│   ├── worker.ts                     # Queue consumer (handleQueryTask)
│   ├── intent-classifier.ts          # 의도분류 (규칙 1차 + LLM 폴백)
│   ├── query-handler.ts              # Code Mode 조회 코드 생성·실행
│   ├── decision.ts                   # 수정(Write) 액션 판정
│   ├── slack-formatter.ts            # 결과 포맷 → 슬랙 메시지
│   ├── slack.ts                      # 슬랙 API 통신
│   ├── notifier.ts                   # 알림 전송
│   └── prompts/                      # 프롬프트 지식 (Code Mode의 핵심)
│       ├── common.ts                 # 공통 규칙 (경로 창작 금지, 안전한 필드 접근 등)
│       ├── build-prompt.ts           # 카테고리별 프롬프트 조합
│       └── categories/               # 카테고리별 조회 지식
│           ├── dns.ts
│           ├── zone.ts
│           ├── cache.ts
│           ├── ssl.ts
│           ├── rules.ts
│           ├── r2.ts
│           ├── analytics.ts          # GraphQL Analytics (트래픽·WAF·R2·DNS)
│           └── waf.ts                # WAF/보안 이벤트
├── mcp/                              # CloudFlare MCP 클라이언트
│   └── client.ts                     # execute 호출 (Code Mode 실행 엔진)
├── ai-gateway/                       # Workers AI 호출 + 토큰 한도 관리
│   ├── index.ts
│   └── limits.ts
├── approval/                         # 수정(Write) 승인 워크플로
│   ├── engine.ts
│   ├── approval-queue.ts
│   └── diff.ts
├── gateway/                          # Tool Gateway (안전 인터페이스)
│   ├── tool-gateway.ts
│   └── validators.ts
├── audit/                            # 감사 로그
│   └── logger.ts
└── shared/                           # 공통 타입·상수·에러
    ├── types.ts
    ├── constants.ts                  # PHASE1_ALLOWLIST / BLOCKLIST
    ├── env.ts
    └── errors.ts
조회 요청이 흐르는 핵심 경로는 index.ts → ingestion/ → agent/worker.ts → agent/intent-classifier.ts → agent/query-handler.ts → agent/prompts/ → mcp/client.ts → agent/slack-formatter.ts 입니다. 수정(Write) 요청은 intent-classifier에서 갈라져 approval/ → gateway/를 거칩니다.
4. 프롬프트에 실측 지식 쌓기
Code Mode의 품질은 “LLM이 CloudFlare API 스키마를 얼마나 정확히 아느냐”에 달려 있습니다. LLM이 조회 코드를 잘못 짜는 경우의 대부분은 창의성 부족이 아니라 스키마를 모르는 것이었습니다. 그래서 다음 세 단계 사이클을 조회 카테고리(DNS / Zone / Cache / SSL / Rules / R2 / Analytics / WAF)마다 반복했습니다.
4.1 실측 → 축적 → 검증 사이클
① probe 스크립트로 실제 CloudFlare API/GraphQL을 직접 호출해 응답 구조를 실측합니다. 이 단계에는 LLM이 끼지 않습니다. 어떤 필드가 어떤 모양으로 오는지, 공식 문서에 적힌 것과 실제가 다른 부분은 없는지 눈으로 확인하는 과정입니다.
② 실측 결과를 카테고리별 프롬프트에 지식으로 축적합니다.
③ 자연어 케이스를 돌려, LLM이 실제로 올바른 코드를 생성하는지 검증합니다.
이 사이클의 핵심은 “LLM이 이미 알 거라고 가정하지 않는다”는 것입니다. 공식 문서에 적힌 스키마와 실제 응답이 다른 경우가 적지 않았고, 데이터셋마다 지원하는 필드와 쿼리 구문이 달랐습니다. 실측으로 확인한 지식을 프롬프트에 넣어 두면, 같은 실수가 재현성 있게 교정됩니다.
4.2 카테고리별 프롬프트 지식
카테고리별로 쌓은 대표적인 프롬프트 지식을 정리하면 다음과 같습니다.
| 카테고리 | 프롬프트에 축적한 지식 예시 |
|---|---|
| Analytics (GraphQL) | 데이터셋마다 지원 필드가 다름 — 집계용과 상세필터용을 구분해 쓰도록 명시. 시간 필터 없는 쿼리 금지(비용 방어). 기본 조회 범위를 24시간으로 제한 |
| Cache | 캐시 동작을 최종적으로 좌우하는 것은 zone 레벨 설정이 아니라 사용자가 만든 캐시 룰(Cache Rules). 룰 목록 조회 → 상세 조회의 2단계 필요. 전체 룰이 수백 개일 수 있어 상위 N개 + 전체 개수로 요약 |
| DNS | Zone 이름만 주어졌을 때 zone_id를 먼저 조회해야 함. zone_id를 임의로 쓰지 말 것 |
| SSL/TLS | 인증서 팩이 여러 개(RSA+ECDSA). 모드 조회와 인증서 목록 조회는 별개 경로 |
| Rules | 리다이렉트·URL 재작성·헤더 변형·오리진 등 모든 룰은 /rulesets phase로 구분. 별도 REST 경로(예: /zones/{id}/rules)는 존재하지 않음(경로 창작 금지) |
| R2 | 버킷 스토리지 시계열은 account 스코프의 GraphQL 데이터셋 사용. 버킷명 없이 호출하면 전체 계정 합산 |
| WAF/보안 | 방화벽 이벤트는 집계가 아니라 개별 이벤트 목록으로 조회(limit·정렬 필수). action/source/IP/국가/경로 등 필터 조합 가능 |
| 공통 | 존재하지 않는 REST 경로를 창작하지 말 것(경로 창작 금지). 판단형 질문에도 조회한 근거 값을 반드시 포함할 것. 중첩 필드에는 예외 없이 안전한 필드 접근(?.) 적용 |
실측에서는 “응답 구조가 어떻게 생겼는가”뿐 아니라 “한 Zone에 리소스가 실제로 얼마나 많은가”도 함께 확인했습니다. 예를 들어 운영 중인 어떤 Zone 하나는 DNS 레코드가 수백 개, 캐시룰이 수십 개에 이르렀습니다. 응답이 이렇게 커질 수 있다는 사실 자체가 프롬프트 설계에 영향을 줬습니다. 목록형 조회는 전부 반환하지 말고 핵심 필드만 추려 상위 N개 + 전체 개수로 요약하도록 지침을 넣은 이유입니다.
4.3 “하지 말 것” 규칙의 효과
프롬프트에 지식을 축적할 때는 “이렇게 하라”보다 “이것은 하지 마라”를 함께 못박는 편이 효과적이었습니다. 이건 경험에서 비롯된 판단인데, LLM은 “올바른 방법”보다 “하면 안 되는 실수”를 못박아 주는 쪽에 더 잘 반응했습니다. 공통 프롬프트에는 존재하지 않는 REST 경로를 지어내지 말 것, 단정 대신 값으로 근거를 제시할 것, 전체 Zone을 순회할 때 콜백 안에서 비동기 처리를 하지 말고 반복문으로 순회할 것 같은 “하지 말 것” 규칙을 적어 두었습니다.
5. 실제로 부딪힌 함정들
Code Mode는 DNS·Zone·Cache·SSL·Rules·R2·Analytics 전반을 다루고, 여러 리소스를 묶어 보는 결합 조회(예: Zone 상태 + 캐시 적중률 + 트래픽 추이를 한 번에)도 처리합니다. 커버리지가 넓은 만큼 카테고리마다 LLM이 틀리는 지점도 제각각이었습니다. 아래는 그 튜닝 과정에서 대표적으로 부딪힌 함정 몇 가지입니다.
5.1 집계 수치가 콘솔과 어긋나던 문제
대표 사례로 캐시 절감율 조회가 있었습니다. 초기에는 LLM이 생성한 코드가 절감율을 항상 100%로 돌려줬습니다. 저장할 값(절감된 바이트)에 전체 바이트를 그대로 대입해, 같은 값을 자기 자신으로 나누는 꼴이 됐기 때문입니다. probe로 특정 구간(KST를 UTC로 고정)의 원본을 직접 찍어 보니 실제 절감율은 100%와는 거리가 먼 한 자릿수 퍼센트였습니다.
1차 수정으로 프롬프트에 “절감율은 전체 바이트가 아니라 캐시가 처리한 바이트로 계산할 것, 같은 값을 자기 자신으로 나누지 말 것, 임의 필드명을 만들지 말 것”을 명시했습니다.
5.2 데이터셋을 콘솔과 맞추기
계산식을 고친 뒤에도 더 깊은 문제가 있었습니다. 데이터셋 자체가 콘솔과 어긋났습니다. 처음 쓰던 집계 데이터셋의 전송량 값이 콘솔의 “Data transfer”와 10% 이상 차이가 났습니다. GraphQL Analytics에는 비슷해 보이는 데이터셋이 여럿 있는데, 각각 샘플링 방식과 지원 필드가 달라 같은 지표라도 값이 다르게 나옵니다. 콘솔과 일치하는 데이터셋(캐시 상태별로 응답 바이트를 집계할 수 있는 쪽)으로 바꾸니 거의 정확히 맞아떨어졌습니다. 그리고 콘솔의 “Served by” 분류를 실측으로 역산했습니다.
- Served by origin = 캐시 상태가
dynamic또는miss(오리진이 전송량을 부담) - Served by CloudFlare = 나머지(hit / expired / revalidated / bypass 등 CloudFlare 엣지가 처리)
- 캐시 절감율 = served_by_cloudflare / total × 100
이렇게 바꾼 데이터셋으로 조회한 값은 같은 구간의 콘솔 “Served by CloudFlare” 수치와 오차 1% 안쪽으로 맞아떨어졌습니다. 여기서 확인한 점은 분명합니다. “같은 지표”라도 데이터셋마다 값이 다릅니다. 콘솔과 대조 가능한 데이터셋을 골라야 신뢰할 수 있습니다.
이렇게 데이터셋과 분류 기준을 다시 세운 결과는 지금 배포된 에이전트에 그대로 반영되어 있습니다. 아래는 현재 배포된 에이전트가 슬랙에서 돌려준 실제 응답의 형태입니다(값은 조회 시점의 트래픽에 따라 달라집니다).
질의: (슬랙에서) 지난 24시간 데이터 전송량과 캐시로 절감된 비율을 알려줘.응답(JSON):
{
  "조회구간": "... ~ ... (KST)",
  "total_transfer": "201.60 MB",
  "served_by_cloudflare": "72.95 MB",
  "served_by_origin": "128.65 MB",
  "cache_saved_rate": "36.18%"
}
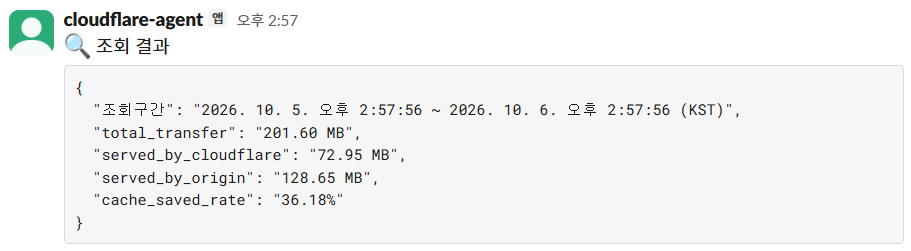
그림 3. 자연어 질의 한 줄로 전송량과 캐시 절감율을 조회한 실제 슬랙 화면. 캐시 절감율은 결합 조회가 가능한 여러 사례 중 하나입니다.
이 응답 하나가 앞서 다룬 것들이 실제로 동작함을 보여 줍니다.
- 반환 필드명이 재정의한 설계와 정확히 일치합니다.
total_transfer/served_by_cloudflare/served_by_origin/cache_saved_rate로, 임의 필드명을 만들던 버그를 잡고 필드를 정리한 결과물입니다. 조회구간이 KST로 표시됩니다. 내부 필터는 UTC로 처리하되 사용자 표시는 KST로 변환하는 원칙(5.3)이 실제로 적용된 모습입니다.cache_saved_rate가 정상 범위의 값으로 나옵니다. “항상 100%”로 나오던 버그가 실제로 수정됐음을 그대로 확인할 수 있습니다.
5.3 KST와 UTC — 상대 구간과 절대 시각의 구분
운영자는 한국시간(KST=UTC+9) 콘솔을 보고, API는 UTC로 응답합니다. 혼동하기 쉬운 두 가지가 있어 규칙으로 정리했습니다.
| 구분 | 처리 규칙 |
|---|---|
| 상대 구간(“최근 6시간”) | 변환 불필요. Date.now()가 이미 UTC 절대시각이므로 거기서 6시간을 빼면 KST로 보든 UTC로 보든 동일한 순간 |
| 절대 시각(“9월 15일 10시”) | 변환 필수. 사용자가 말한 건 KST 벽시계 시각이므로 +09:00로 해석 후 ISO 변환 시 9시간 차감(예: UTC 01:00Z) |
| 결과 표시 | 항상 KST로 변환하고 “(KST)” 라벨을 붙여 콘솔과 대조 가능하게 |
용어도 바로잡았습니다. 사용자가 “대역폭”이라고 물어도, 정확히는 “대역폭(bandwidth, 초당 속도)”이 아니라 “전송량(Data transfer, 누적 바이트)”이므로 결과 라벨은 “전송량”으로 응답하도록 프롬프트에 명시했습니다.
5.4 안전한 필드 접근은 일반 원칙으로
CloudFlare API 응답은 같은 목록 안에서도 항목마다 필드 구성이 다릅니다. 예를 들어 어떤 룰에는 origin.host가 있고, 어떤 룰에는 없습니다. 이때 없는 필드를 그대로 읽으면 에러가 나서 조회 전체가 실패합니다. JavaScript의 ?. 문법을 쓰면 필드가 없을 때 에러 대신 빈 값으로 넘어가는데, 이 글에서는 이를 안전한 필드 접근이라고 부르겠습니다.
교차질의(DNS+Origin 등) 테스트에서 LLM이 origin.host 같은 중첩 접근에서 자주 실패했습니다. 처음에는 “이 필드에 ?.를 붙여라”고 특정 필드를 지시했는데, 그러자 다른 필드에서 또 실수하는 두더지 잡기가 됐습니다. 그래서 “첫 단계를 넘는 모든 중첩 접근에는 예외 없이 ?.를 쓴다”는 강한 일반 원칙으로 바꿨습니다. 여기서 얻은 원칙은 LLM 프롬프트에서 케이스를 나열하기보다 일반 규칙을 세우는 쪽이 재현성이 높다는 것입니다.
5.5 의도분류 하이브리드 캐스케이드
모든 요청이 LLM을 2회(의도분류 + 조회) 거치면서 느렸습니다. 실제로는 순수 조회가 대부분인데도요. 세 가지 안을 검토했습니다.
- (A) 의도분류 완전 제거 → 반려. 안전게이트와 승인 워크플로우가 사라집니다.
- (C) 전면 규칙 교체 → 반려. 오분류가 곧 안전 문제입니다(write를 read로 잘못 보면 위험).
- (B) 하이브리드 캐스케이드 채택 → 규칙 1차 판정(write 키워드가 하나도 없으면 read로 확정하고 LLM 분류를 스킵) + write 냄새가 있으면 기존 LLM
classifyIntent로 폴백.
이 설계는 Taskade의 “cheap rule → embedding → LLM” 캐스케이드, Inworld의 “의도분류·안전필터·ack는 소형 모델로 충분”이라는 패턴을 참고했습니다. 결과적으로 순수 조회는 LLM 1회를 스킵해 빨라지고, write는 승인 버튼 흐름을 그대로 유지합니다.
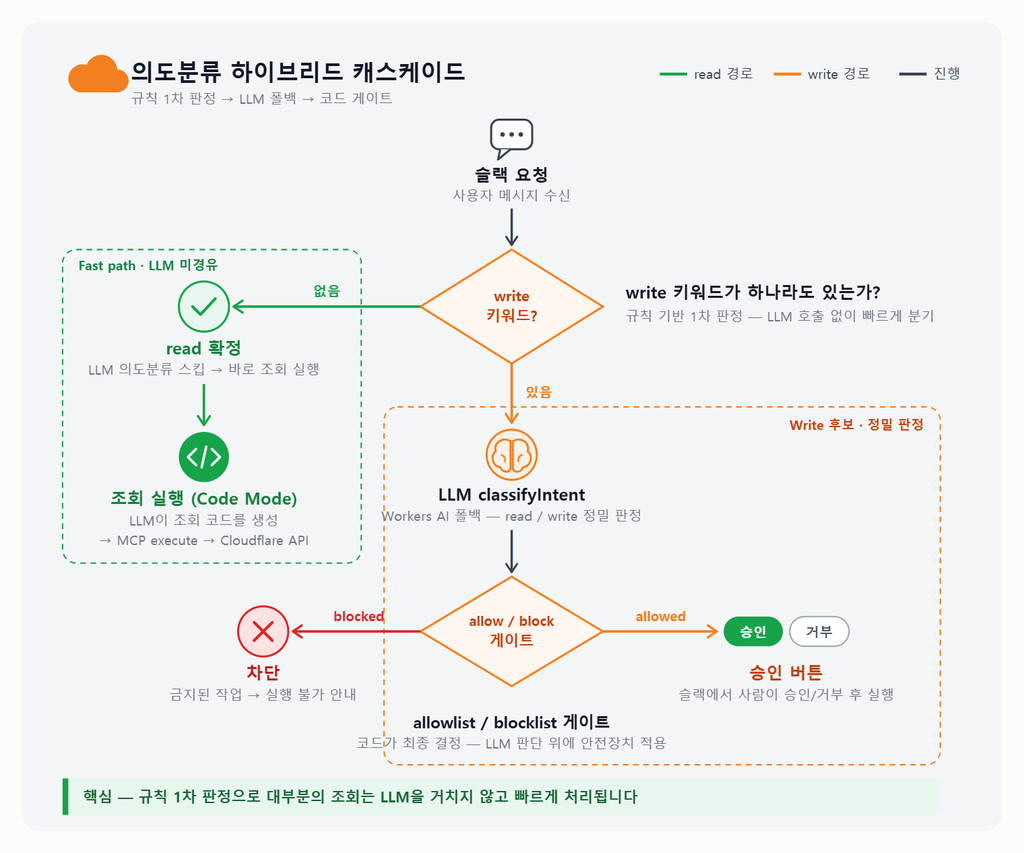
그림 4. 규칙 1차 판정 후 필요할 때만 LLM으로 폴백하는 의도분류 캐스케이드.
6. 안전 모델 — CQRS + 승인 게이트
조회와 수정의 성격은 다릅니다. 그래서 CQRS(명령·조회 분리) 발상으로 안전 모델을 세웠습니다.
- 조회(Read): 자유롭게 수행합니다. 되돌릴 것이 없으니 안전합니다.
- 수정(Write): 의도분류 → Allowlist/Blocklist 게이트 → 슬랙 승인 버튼 → 실행의 단계를 거칩니다.
6.1 작업 분류 원칙
분류 원칙은 작업의 성격에 따라 단순하게 세웠습니다.
- 삭제(Delete) 계열은 전면 금지(X)입니다. DNS 레코드 삭제, Zone 삭제, 인증서 삭제, Zone 전체 캐시 퍼지처럼 되돌리기 어렵고 영향 범위가 큰 작업은 에이전트가 아예 수행하지 못하게 막았습니다.
- 생성·수정(Create/Update) 계열은 승인 게이트(RW)를 거칩니다. 리소스를 새로 만들거나 설정을 바꾸는 작업은 사람이 슬랙에서 승인해야만 실행됩니다. 다만 영향 범위가 특히 큰 수정(WAF 규칙 변경, SSL 모드 변경 등)은 초기 단계에서 보수적으로 금지(X)로 두고, 검증을 거쳐 단계적으로 승인 대상(RW)으로 넓혀 갈 계획입니다.
- 조회(Read)는 자유(R)입니다.
이 분류는 액션 카탈로그에 R/RW/X로 정리해 두었고, 그대로 게이트의 Allowlist/Blocklist로 반영됩니다. 범례는 R=조회만 허용, RW=조회+수정 허용(승인 절차 필수), X=금지입니다. 현재 단계(Phase 1)의 대표 액션을 발췌하면 다음과 같습니다.
| 범위 | 대표 액션 |
|---|---|
| R(조회) | DNS 레코드 조회, Zone 목록/상태·설정 조회, 인증서·SSL 모드 조회, Cache 분석 조회, Rules 조회, WAF 이벤트 조회, R2 버킷 목록, Traffic/Cache/DNS/Audit Analytics |
| RW(승인 후 생성·수정) | Zone 추가, R2 버킷 생성, R2 Custom Domain 연결/변경, DNS 레코드 생성, Cache Rules 수정, 개별 URL 캐시 퍼지 (Phase 확장 시) |
| X(금지) | 모든 삭제 작업 전면 금지(DNS 레코드 삭제, Zone 삭제, 인증서 삭제 등), Zone 전체 캐시 퍼지, WAF Custom/Managed Rules 변경, SSL 모드 변경, API 토큰/멤버/결제 관리 |
범위를 정하는 기준은 네 가지입니다. ① 되돌릴 수 있는가, ② 영향 범위가 얼마나 큰가, ③ 요청 빈도가 높은가, ④ 지금이 어느 Phase 단계인가.
6.2 승인 게이트 동작
처음 구상은 수정까지 자동으로 실행하는 쪽에 가까웠습니다. 하지만 조직 운영 관점에서 수정 작업은 사람의 확인을 반드시 거쳐야 했습니다. 그래서 완전 자동 실행이 아니라, Action Proposal → Human Approval(슬랙 승인) → 실행으로 이어지는 반수동으로 재정의했습니다. 조회는 자율로 두되 수정은 승인 게이트를 통과하게 한 것입니다.
이 승인 게이트는 특정 작업 하나만을 위한 것이 아니라, 상태를 바꾸는 모든 조작 작업에 공통으로 적용되는 장치입니다. DNS 레코드 수정·삭제, 캐시/리다이렉트 룰 변경, SSL 모드 변경, 캐시 전체 퍼지처럼 영향 범위가 큰 작업은 아예 금지(X)로 막아 두고, 허용(RW)으로 분류된 작업만 “승인 후 실행” 경로를 탑니다. 어느 쪽이든 LLM의 판단만으로 바로 실행되는 일은 없습니다.
아래는 허용(RW) 작업의 동작을 보여 주는 한 예시입니다. R2 버킷 생성을 슬랙에서 요청하면, 즉시 실행하지 않고 승인/거부 버튼으로 멈춥니다.
사용자: (슬랙에서) 새 버킷 하나 생성해줘. (이름 지정)에이전트:
⏳ 요청을 처리 중입니다... 🔒 승인이 필요한 수정 작업입니다 요청: (요청 원문) 분류: R2 / r2:createBucket⏰ 5분 내 아래 버튼으로 승인/거부해주세요.
[✅ 승인] [❌ 거부]
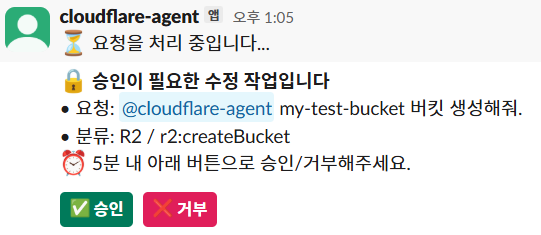
그림 5. 수정(쓰기) 요청이 승인 게이트에서 멈추고 승인/거부 버튼을 띄우는 실제 슬랙 화면. R2 버킷 생성은 허용(RW)으로 분류된 작업의 한 예시입니다.
이 응답에 안전 모델의 핵심이 드러납니다.
- 의도분류가 작동합니다. 요청이
R2 / r2:createBucket으로 분류됐습니다. 의도분류기가 이 작업을 허용(Allowlist) 범주로 판정한 결과입니다. 반대로 삭제·수정처럼 위험한 조작이면 같은 분류 단계에서 차단(Blocklist) 범주로 걸러집니다. - 승인 게이트가 작동합니다. 즉시 실행하지 않고 “승인이 필요한 수정 작업”임을 알린 뒤 승인/거부 버튼에서 멈춥니다. CQRS의 Write 경로가 실제로 Human-in-the-loop로 동작함을 보여 줍니다.
- “요청을 처리 중입니다…” ack가 먼저 뜨고, 승인은 5분 타임아웃이 걸려 있습니다. 7.2에서 다루는 ack(수행 가능 상태일 때만 전송) 원칙이 쓰기 경로에서도 그대로 적용됩니다.
6.3 API 토큰 권한 관리
토큰 관리에서도 실전 제약이 있었습니다. Workers의 아웃바운드 IP는 수많은 PoP에서 수시로 변동하므로, IP 필터로 접근을 제한하는 방식은 맞지 않았습니다(IP 필터는 한 번 걸면 제거가 어려워 새 토큰 생성으로 우회해야 하는 문제도 있었습니다). 대신 토큰 권한을 최소화하는 쪽으로 방어했습니다.
| 원칙 | 내용 |
|---|---|
| 토큰 권한 최소화 | 특정 계정/Zone 범위로만 권한을 좁힘 |
| 조회용/수정용 토큰 물리 분리 | 조회 토큰과 수정 토큰을 물리적으로 분리 |
| IP 필터 부적합 | Workers 아웃바운드 IP가 변동 → IP 필터 대신 토큰 스코프로 제어 |
운영 전환 시에는 데모 계정에서 충분히 테스트한 뒤, 실운영 계정으로 전환하면서 토큰과 권한 스코프를 재설정합니다. 실운영 계정은 다루는 Zone이 수백 개 규모라, 토큰 스코프를 좁게 유지하는 원칙이 특히 중요합니다.
6.4 권한(토큰) 기반의 방어
LLM을 통한 삭제 작업 차단은 실제 서비스 운영 시 상당한 리스크를 동반합니다. 모델이 좋아질수록 스스로 판단해 승인 없이 작업을 수행하려는 경향이 늘어나고, 자연어 기반의 프롬프트의 곡해, 모델의 과잉 적극성으로 언제든 우회될 수 있기 때문입니다.
이를 위해 세 단계를 방어를 두었습니다.
| 방어선 | 통제 방식 | 설명 |
|---|---|---|
| ① 코드 레벨 Read-only 강제 | 코드(결정론적) | 조회 코드에 PUT/PATCH/DELETE가 있으면 차단. POST는 GraphQL 조회만 허용(mutation 차단). |
| ② 토큰 권한 최소화 | 인프라(토큰 스코프) | 조회 신원에 Read-only만 부여, 조회·수정 토큰 분리. 조회 토큰으론 쓰기 API 호출 불가. |
| ③ 수정 작업 승인 게이트 | 사람(HITL) | 허용된 쓰기만 Allowlist/Blocklist 게이트 통과 후 슬랙 승인 시 실행(6.1~6.2). |
세 방어선은 서로 독립적이라 하나가 뚫려도 다음이 막습니다. 프롬프트 통제가 우회돼 삭제 코드가 생성돼도 ①에서 걸러지고, 통과하더라도 ②의 토큰에 쓰기 권한이 없어 API 호출이 거부됩니다.
Cloudflare 환경에서의 적용 지점은 다음과 같습니다.
- MCP 접근 인증: Cloudflare MCP 엔드포인트는 OAuth 2.1 기반으로 인증한다. 우리는 그 과정에서 발급한 Read-only 액세스 토큰을 Bearer로 붙여 호출하고, 스코프를 필요한 계정/Zone으로 좁힌다.
- API 토큰 분리 발급: 조회용은 읽기 권한만, 수정용은 승인 경로에서만 쓰도록 분리.
- 권한은 필요한 만큼만: 조회 유형이 늘어도 권한을 넓히지 않고 꼭 필요한 범위만 추가.
모델의 성능과 자율성이 높아질수록 프롬프트로 하는 통제의 신뢰도는 떨어집니다. 토큰에 애초에 어떤 권한을 줄 것인가 하는 설계가 LLM 기반 운영 자동화의 가장 근본적인 안전장치입니다.
7. 주의할 점 / 교훈
7.1 공통 원칙
조회 튜닝 과정에서 얻은 공통 원칙은 네 가지로 정리됩니다.
- probe로 실측해서 프롬프트에 지식을 축적하는 사이클이 Code Mode 품질의 핵심입니다.
- 콘솔과 값을 대조하는 것이 “정답”의 기준이며, 데이터셋 선택이 정확도를 좌우합니다.
- LLM 프롬프트는 케이스를 나열하기보다 강한 일반 원칙을 세우는 쪽이 재현성이 높습니다.
- 로컬 프롬프트 하네스에서 실제 LLM+MCP로 먼저 검증한 뒤 운영 환경에 배포하면, 문자 유실 없이 안전하게 반영됩니다.
7.2 운영 단계 고려 사항
운영 단계에서 좀 더 고려되어야 하는 부분도 있습니다.
- ack 체감 지연: “처리 중…” 응답을 “수행 가능 상태일 때만” 보내는 원칙은 유지 대상입니다. 다만 Queue 소비자의
max_batch_timeout = 30(10개가 차지 않으면 최대 30초 대기 후 배치 처리) 때문에, 메시지가 큐에 들어간 뒤 소비까지 지연이 생길 수 있습니다. 배치 타임아웃 축소, 또는 2단계 표시(접수됨 → 처리 중 → 결과)로 완화할 여지가 있습니다. - 자동 재시도(self-correction): LLM이 만든 조회 코드가 실행 중 에러를 내면, 그 에러를 LLM에 다시 알려 코드를 스스로 고쳐 재실행하게 하는 기능입니다. 지금은 에러 시 바로 실패 처리하지만, 향후 보완할 과제입니다.
- 디버그 로그 정리: 민감정보 노출 관점에서 로그를 정리하고, 사용자/채널 화이트리스트가 실제로 적용됐는지 확인해야 합니다.
운영 중 발견한 소소한 버그들도 있었습니다. 승인 메시지가 2번 중복 전송되던 문제(중복 호출 제거로 해결), 스마트쿼트 정규화가 아포스트로피를 깨뜨리던 normalizeQuotes 부작용(호출 제거), 일일 토큰 한도(DAILY_TOKEN_LIMIT) 100000에서 300000으로의 상향 같은 것들입니다.
8. 마치며
처음 전체 파이프라인이 붙었을 때, “Zone 목록 보여줘”라는 한 줄이 슬랙 → Worker → Queue → Workers AI → CloudFlare API → 슬랙 응답까지 1초 안쪽에 돌았습니다. 숫자 자체보다, 설계한 조각들이 실제로 하나의 흐름으로 이어진 그 순간이 조회 에이전트의 출발점이었습니다. 이후의 작업은 대부분 그 흐름을 더 정확하고 안전하게 다듬는 과정이었습니다.
다음 편에서는 과거 고객 지원 티켓을 학습한 티켓 RAG를 다룹니다. 조회가 “지금의 상태”를 보는 일이라면, 티켓 RAG는 “비슷한 과거 사례”를 찾아 진단과 가이드를 돕는 일입니다. 조회 에이전트 위에 어떻게 지식 검색을 얹었는지 이어서 소개하겠습니다.
9. 참고 문서
- CloudFlare Workers — 서버리스 런타임. developers.cloudflare.com
- CloudFlare Queues — 비동기 메시지 큐. developers.cloudflare.com
- CloudFlare D1 — 서버리스 SQL 데이터베이스. developers.cloudflare.com
- Workers AI — LLM 모델 카탈로그(llama-3.3-70b 포함). developers.cloudflare.com
- GraphQL Analytics API —
httpRequestsAdaptiveGroups/httpRequests1hGroups/r2StorageAdaptiveGroups등 데이터셋. developers.cloudflare.com