
H200 도입 후 마주한 Timeout — Reasoning 모델의 TTFT 착시와 Thinking Budget
1. 배경: 응답 지연과 인프라 스펙 확장
금융권 고객사를 대상으로 생성형 AI 플랫폼 PoC를 수행하며 겪은 엔지니어링 사례입니다. 해당 프로젝트에서는 복잡한 도메인 질의를 처리하기 위해 MoE(Mixture of Experts) 아키텍처 기반의 Qwen3.6-35B-A3B 모델을 사용하고 있었습니다.
초기에는 ml.g7e.48xlarge 사양의 AWS SageMaker 실시간 엔드포인트를 통해 모델을 서빙했습니다. 그러나 파일럿 테스트 과정에서 다음과 같은 사용자 피드백이 지속해서 접수되었습니다.
“답변 결과의 정확도는 양호하나, 체감 레이턴시가 지나치게 깁니다.”
엔지니어링 관점에서 가장 먼저 검토한 가설은 추론 인프라의 연산 성능 확장이었습니다. 더 높은 메모리 대역폭과 연산 역량을 갖춘 최신 GPU 인프라를 투입하면 토큰 생성 속도가 개선되어 사용자가 체감하는 지연 시간 역시 단축될 것으로 판단했습니다.
이를 검증하기 위해 NVIDIA H200 Tensor Core GPU 기반의 EC2 p5en.48xlarge 인스턴스에 오픈소스 LLM 서빙 엔진인 vLLM을 직접 구축했습니다. 제한된 비용을 고려하여 호스트의 8장 GPU 중 2장을 할당(Tensor Parallelism, TP=2)했습니다.
당시 구성한 엔드투엔드(E2E) 요청 파이프라인의 각 계층별 역할은 다음과 같습니다.
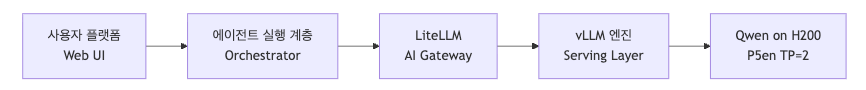
- 사용자 플랫폼: 최종 사용자가 프롬프트를 입력하고 완성된 응답을 확인하는 프론트엔드 웹 애플리케이션
- 에이전트 실행 계층: 작업 흐름(Workflow) 제어, 도구(Tool) 호출 및 프롬프트 구성을 담당하는 오케스트레이터
- LiteLLM: 다양한 모델 API 엔드포인트를 OpenAI 규격으로 통합 라우팅하는 AI 게이트웨이 프록시
- vLLM: H200 GPU 2장(TP=2)을 활용하여 Qwen 모델 추론을 직접 수행하는 백엔드 서빙 엔진
H200 인스턴스 내 컨테이너 배포 및 vLLM 엔진 기동, LiteLLM 프록시 연동을 완료하고, 터미널 환경에서 프록시 엔드포인트로 직접 수행한 curl 스트리밍 테스트에서는 정상적으로 높은 처리량의 토큰 스트림이 반환되었습니다.
2. 장애 현상: 인프라 정상 응답과 상위 계층의 Timeout 발생
그러나 새로운 H200 추론 스택을 상위 플랫폼 파이프라인에 통합한 직후, 사용자 환경에서 간헐적으로 LLM 무응답에 따른 오류가 발생하기 시작했습니다.
시스템 모니터링 콘솔과 로그를 확인한 결과, 하위 서빙 인프라는 정상적으로 가동되고 있었습니다.
- GPU 상태: H200의 연산 유닛은 높은 가동률을 유지하며 연산을 수행하고 있었습니다.
- vLLM 엔진 로그: 모델이 초당 수백 토큰의 속도로 정상 출력을 생성하고 있었습니다.
- LiteLLM 프록시: 백엔드로부터 끊김 없이 응답 스트림 청크를 수신하고 있었습니다.
하위 추론 인프라는 오류 없이 높은 처리량으로 토큰을 생성하고 있었으나, 최상위 사용자 플랫폼 계층에서는 응답을 수신하지 못해 Client Timeout이 발생하며 요청이 중단되는 현상이 관찰되었습니다.
이는 단순한 하드웨어 연산 속도 문제가 아닌, 모델이 생성한 응답이 여러 계층을 거쳐 사용자 화면에 도달하기까지의 E2E 파이프라인 전달 과정에 병목 또는 단절이 존재함을 의미했습니다.
3. 원인 분석: 추론(Reasoning) 모델의 출력 특성과 TTFT 왜곡
사용 중이던 Qwen 모델은 일반적인 LLM과 달리, 최종 답변을 생성하기 전에 내부 논리를 단계별로 풀어나가는 추론형(Reasoning/Thinking) 모델이었습니다.
추론 모델의 출력 과정은 개념적으로 다음과 같이 구분됩니다.
사용자 질의 입력
   │
   ▼
[1단계: Reasoning 단계]
모델 내부의 논리 전개 및 사고 과정
   │
   ▼
[2단계: Visible Content 단계]
사용자 화면에 표시되는 최종 응답 본문
여기서 엔지니어링 측면의 주요 쟁점이 발생합니다.
- Reasoning Token (사고 토큰): 모델이 심층 추론을 위해 생성하는 중간 데이터입니다. 다수의 엔터프라이즈 플랫폼에서는 간결한 UI 및 내부 정책을 이유로 해당 추론 블록을 사용자 화면에 노출하지 않고 숨기거나 필터링합니다.
- Visible Content (가시 응답): 추론이 종료된 후 비로소 생성되는 실제 본문 텍스트입니다.
- TTFT(Time To First Token)의 착시: 기존 모니터링 시스템의 TTFT 지표는 첫 번째 토큰이 생성된 시점만을 측정합니다.
모델은 요청 수신 후 0.2~0.3초 내에 첫 토큰을 출력하므로 대시보드의 TTFT 지표는 매우 정상(Green)으로 기록됩니다. 그러나 이 토큰은 사용자에게 표시되지 않는 Reasoning Token이었습니다.
특히 중간 에이전트 실행 계층(Orchestrator)이 LiteLLM으로부터 Reasoning 스트림을 수신하더라도 이를 사용자 플랫폼(Web UI)으로 포워딩하지 않도록 설계되어 있어, 모델이 수십 초간 추론 과정을 거치는 동안 최상위 웹 화면에는 어떠한 데이터도 전달되지 않는 상태가 지속되었습니다.
기존 SageMaker 운영 지표 분석
동일한 Qwen 모델이 운영 워크로드에서 보인 동작 패턴을 확인하기 위해, 과거 SageMaker 환경에서 수집된 2시간 분량의 Prometheus 운영 지표를 분석했습니다.
| 모니터링 항목 | 측정값 | 엔지니어링 관점의 의미 |
|---|---|---|
| 성공 요청 수 | 약 203건 | 분석 대상 샘플 |
| 평균 입력 토큰 | 약 81,355 tokens | RAG 컨텍스트 주입 및 복잡한 에이전트 워크로드 |
| 평균 출력 토큰 | 약 690 tokens | 모델의 총 생성 토큰량 |
| 출력 중 Reasoning 비중 | 약 31.9% | 전체 생성 토큰의 약 1/3이 추론 과정에 소비됨 |
| 평균 TTFT | 0.397초 | 첫 번째 토큰 생성 반응 속도는 매우 신속함 |
| TTFT p95 | 0.919초 | 95%의 요청에서 1초 이내 첫 토큰 생성 시작 |
| E2E 전체 지연시간 평균 | 5.13초 | 평균 요청 완료 시간 |
| E2E 전체 지연시간 p95 | 22.80초 | 상위 5% 요청에서 20초 이상의 지연 관찰 |
| E2E 전체 지연시간 p99 | 29.20초 | 상위 1% 요청에서 약 30초 소요 |
| 10초 초과 요청 비율 | 13.0% (26건) | 전체 요청의 13%가 10초 이상 소요됨 |
| 평균 큐 대기시간(Queue Time) | 0.196ms | 서빙 큐 대기 병목은 부재함을 확인 |
큐 대기 시간(0.196ms)과 TTFT p95(0.919초) 지표는 인프라 리소스 경합이 없음을 나타냈습니다. 그러나 TTFT는 0.9초 이하임에도 전체 지연시간 p95는 22.8초에 달했습니다.
확인된 극단적인 케이스는 아래와 같습니다.
| 요청 샘플 | 기록된 TTFT | E2E 총 처리 시간 | 입력 토큰 | 출력 토큰 |
|---|---|---|---|---|
| Sample A | 0.223초 | 31.058초 | 24,424 | 4,815 |
| Sample B | 0.605초 | 26.296초 | 141,342 | 2,993 |
Sample A의 경우, 첫 토큰 생성은 0.22초에 이루어졌으나 전체 처리 시간은 31초를 초과했습니다. 이 시간의 상당 부분이 사용자 화면에 표시되지 않는 추론 토큰 생성에 사용되었다면, 상위 게이트웨이는 장시간 유의미한 페이로드를 수신하지 못해 유휴 타임아웃(Idle Timeout)을 유발하게 됩니다.
4. 실증 검증: Thinking Budget 미설정 시의 출력 잠식 현상
모델의 사고 길이를 제어하는 Thinking Budget의 동작을 검증하기 위해, LiteLLM 프록시 경로에서 캐시를 우회하고 통제된 조건(max_tokens=512, temperature=0)으로 A/B 테스트를 진행했습니다.
| 테스트 조건 | HTTP 응답 코드 | 실행 결과 및 분석 |
|---|---|---|
| 1. Budget 미설정 | 200 OK | 모델이 512개의 허용 토큰 전체를 Reasoning으로 소비함. 추론 텍스트만 1,357자 생성 후 finish_reason=length로 조기 종료되었으며, 사용자에게 전달될 Visible Content는 0자로 반환됨. |
2. thinking_budget=64 | 200 OK | 설정이 반영되지 않고 조건 1과 완전히 동일하게 동작함. 별도의 에러나 경고 없이 파라미터가 무시됨(Silent Ignore). |
3. thinking_token_budget=64 | 424 Failed Dependency | LiteLLM에서 424를 반환하였으며, 모델 컨테이너 레벨에서 HTTP 400 에러 메시지가 기록됨. |
조건 3에서 확인된 SageMaker 컨테이너의 로그는 다음과 같았습니다.
thinking_token_budget is set but reasoning_config is not configured.
Please set --reasoning-config to use thinking_token_budget.
이 테스트를 통해 확인된 사실은 다음과 같습니다.
- 출력 토큰 잠식(Output Starvation): Reasoning Budget 제한이 없을 경우, 모델이 가용한 최대 출력 토큰(
max_tokens) 전체를 사고 과정에 소모하여 최종 답변을 전혀 생성하지 못한 채 종료될 수 있습니다. - 비공식 파라미터 무시: 프록시 계층에서 미지원 파라미터(
thinking_budget)를 전달할 경우 오류를 반환하지 않고 정상(200 OK)으로 통과시키나 실제 엔진에는 적용되지 않는 현상이 발생합니다. - 서빙 런타임 제약: 당시 테스트 대상이었던 SageMaker vLLM DLC(v0.19.1 기반) 환경은 컨테이너 구동 옵션(
--reasoning-config)이 미반영되어 있어thinking_token_budget파라미터를 즉시 활용할 수 없었습니다.
max_tokens가 모델이 출력할 수 있는 전체 토큰 버퍼의 상한이라면, thinking_token_budget은 그 안에서 추론 과정에 할당할 수 있는 최대 한도를 규정합니다. 전체 상한이 크더라도 추론 한도가 통제되지 않으면 최종 응답에 할당될 버퍼가 고갈됩니다.
5. 메커니즘 분석: Timeout 유발 시퀀스
실측 데이터를 기반으로 상위 플랫폼 계층에서 발생한 타임아웃 메커니즘을 분석한 결과는 다음과 같습니다.
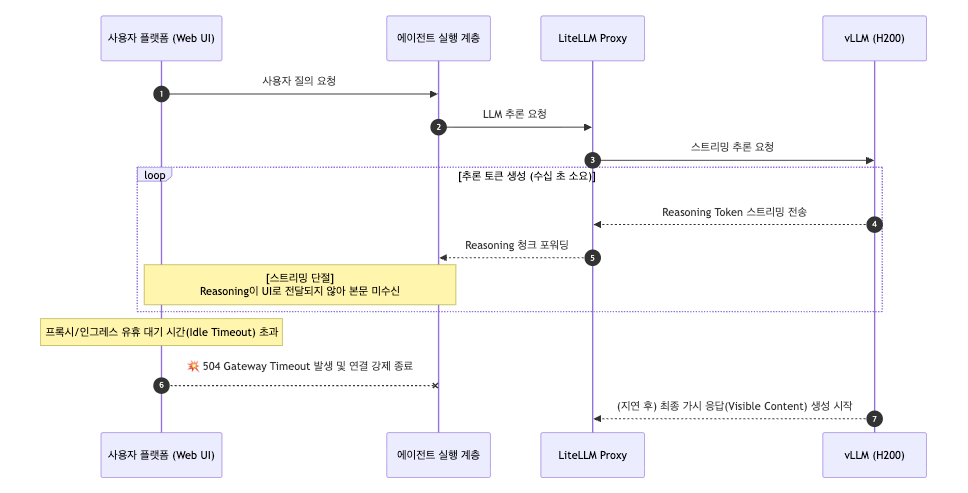
하위 인프라(vLLM 및 LiteLLM)는 Reasoning 토큰 스트림을 정상적으로 송수신하고 있었으나, 에이전트 실행 계층에서 해당 토큰을 웹 UI로 스트리밍하지 않음에 따라 상위 웹 계층 기준으로는 유의미한 HTTP 페이로드가 전달되지 않았습니다.
결과적으로 사용자 플랫폼의 유휴 연결 타임아웃 임계치를 초과하면서 Timeout이 발생한 것으로 분석됩니다.
📌 검증된 사실과 정황적 가설
- 직접 검증된 사실:
- H200 및 vLLM 엔진은 정상적으로 토큰을 생성하고 있었으며, LiteLLM 역시 스트림을 수신하고 있었습니다.
- Thinking Budget이 부재할 경우 Reasoning이 전체 토큰을 잠식하여 Visible Content가 0자로 종료되는 현상을 재현했습니다.
- 구버전 서빙 환경에서는 해당 Budget 옵션을 즉시 활성화할 수 없었습니다.
- 정황적 가설:
- 과도한 추론 과정으로 인해 첫 가시 응답(Visible Content) 도달 시점이 지연되었을 것입니다.
- 해당 지연이 상위 게이트웨이 및 프런트엔드의 유휴 타임아웃 임계치를 초과하여 오류를 발생시켰을 것입니다.
6. 대응 및 분석: 추론 품질을 고려한 Thinking Budget 적용
1) vLLM 0.22.1 기반 thinking_token_budget 설정
H200 호스트에 자체 구성한 vLLM 0.22.1 환경에서는 thinking_token_budget 파라미터가 정상적으로 지원되었습니다.
테스트를 통해 해당 파라미터 적용 시 설정된 토큰 범위 내에서 추론을 종료하고 신속하게 최종 응답(Visible Content) 생성 단계로 전환됨을 확인했습니다. 이후 운영 워크로드의 특성을 고려하여 4,096 토큰을 예산으로 구성하여 타임아웃 발생 가능성을 차단했습니다.
2) 관측성 지표 고도화
기존 TTFT 단일 지표의 한계를 보완하기 위해 다음과 같은 분리된 모니터링 메트릭 체계를 정의했습니다.
time_to_first_reasoning_token: 엔진의 최초 응답 개시 속도 계측time_to_first_visible_content: 실제 사용자 화면에 첫 텍스트가 도달하기까지의 체감 지연 계측reasoning_to_output_ratio: 전체 출력 중 추론 토큰이 차지하는 비율zero_visible_content_count: 본문 생성 실패(답변 0자) 발생 건수 추적
3) Thinking Budget 제어와 추론 품질의 상관관계
타임아웃 해소를 위한 Thinking Budget 설정이 모델의 추론 성능(정확도) 저하를 유발하지 않는지에 대한 검토가 수반되어야 합니다.
최근 발표된 프론티어 AI 연구(Qwen3 Technical Report, When More Thinking Hurts)에 따르면 다음과 같은 특성이 보고되고 있습니다.
- 복합 추론 업무: 수학, 알고리즘 구현, 다단계 논리 분석 등 고난도 태스크에서는 Thinking Budget이 확보될수록 문제 해결 정확도가 비례하여 상승합니다.
- 일반 업무 및 오버씽킹(Overthinking): 반면 사실 기반 질의응답이나 단순 요약 업무에서는 사고 토큰을 과도하게 생성하더라도 품질 개선 효과는 미미하며, 오히려 모델이 불필요한 자기 의심을 반복하다 정답을 번복하는 오버씽킹 현상이 발생할 수 있습니다.
따라서 무조건적인 추론 억제가 아닌, 업무 성격에 부합하는 적정 수준의 Thinking Budget을 설정하는 것이 유효 가시 응답의 전달 속도(Time to First Visible Token)를 확보하고 불필요한 GPU 연산 자원 낭비를 방지하는 접근법입니다.
7. 엔지니어링 교훈
① 하드웨어 스펙 확장이 E2E 지연시간 단축을 보장하지 않는다
최신 GPU 인프라 도입이 모든 서비스 지연을 해결하지는 않습니다. 최종 사용자가 체감하는 응답 지연은 하드웨어 연산 역량뿐 아니라 오케스트레이터의 버퍼링 정책, 프록시 라우팅, 게이트웨이 타임아웃 설정 등 E2E 파이프라인 전체의 상호작용에 의해 결정됩니다.
② 추론 모델 환경에서는 TTFT 지표를 재정의해야 한다
기존의 TTFT(첫 토큰 시간)는 중간 추론 토큰을 생성하는 모델 구조에서 왜곡된 지표를 제공합니다. 첫 추론 토큰이 0.2초 만에 생성되더라도 사용자가 유효 응답을 수신하기까지 수십 초가 소요될 수 있습니다. 프로덕션 환경에서는 Time to First Visible Content를 핵심 서비스 수준 지표(SLI)로 계측하거나, UI 차원에서 추론 진행 상태를 사용자에게 명시적으로 피드백하는 UX 설계가 병행되어야 합니다.
③ 비공식 서빙 파라미터의 Silent Ignore를 검증해야 한다
프레임워크나 게이트웨이에 따라 지원되지 않는 파라미터가 유입되어도 에러 없이 200 OK를 반환하며 설정을 묵살하는 경우가 발생합니다. 추론 제어 옵션을 적용할 때는 설정 파일 검토에 그치지 않고, 실제 반환 페이로드의 토큰 구성 분포를 엔드투엔드로 직접 검증해야 합니다.