
들어가며
Cloud Storage 버킷에 문서를 올리면 Eventarc 트리거가 Cloud Run 서비스를 호출하고, 그 서비스가 Vertex AI의 Gemini 모델로 문서를 Markdown으로 바꿔 같은 버킷의 parsed/ 아래에 쓰는 파이프라인을 만들었습니다. 처리 결과는 파일 하나에 한 행씩 BigQuery 테이블에 스트리밍 insert로 적재합니다. 샘플 문서 5개를 차례로 올리고 행이 SUCCESS로 찍히는지 확인하는 통합 테스트를 돌렸는데, 마지막 파일에서 멈췄습니다. 아래는 그때 남은 오류 로그의 발췌입니다.
Cloud Run recorded FAILED metadata for gs://${BUCKET}/${DOC}.pdf:
404 GET https://storage.googleapis.com/download/storage/v1/b/${BUCKET}/o/%E1%84%8B...pdf
No such object
URL에 퍼센트 인코딩된 파일명이 눈에 걸렸습니다. %E1%84%8B는 U+110B, 조합용 초성 「ㅇ」입니다. 한글 음절을 완성형(NFC)으로 적으면 「가」는 U+AC00 한 글자라 %EA%B0%80로 나오지만, 자모를 따로 적는 분해형(NFD)으로 적으면 초성 U+1100과 중성 U+1161로 분리되어 %E1%84%80%E1%85%A1가 됩니다. 조합용 자모 영역(U+1100부터)의 값은 완성형 음절에는 나오지 않으므로, 이 URL의 파일명은 분해형이었습니다. 그래서 처음에는 올린 파일명과 찾는 이름의 정규화 방식이 어긋나 객체를 찾지 못하는 문제로 보였습니다. 오류 메시지가 가리키는 곳과 실제 원인이 달랐기 때문에 진단이 오래 걸렸습니다.
원인은 파일명이 아니라 Eventarc가 트리거와 함께 만드는 Pub/Sub push 구독의 ack deadline 기본값 10초였습니다. 파싱에 수십 초가 걸리는 서비스가 응답하기 전에 같은 이벤트가 다시 전달되고 있었습니다. 구독 · 서비스 · 테스트 세 곳을 함께 고친 뒤 같은 테스트에서 파일당 처리 횟수가 4~7회에서 1회로, BigQuery 행이 27행에서 5행으로 줄었습니다.
이 글은 404에서 원인까지 좁혀 간 과정, 고친 세 곳, 재전송을 걷어내자 드러난 BigQuery 스트리밍 insert의 404를 다룹니다. Eventarc 트리거를 만드는 절차와 문서 파싱 품질은 다루지 않습니다. 검증 환경은 서울 리전(asia-northeast3)이고, 트리거 이벤트는 google.cloud.storage.object.v1.finalized, Cloud Run 요청 타임아웃은 300초, 입력과 출력은 같은 버킷을 썼습니다. Eventarc로 Cloud Run을 호출하는 이벤트 파이프라인을 만드는 인프라 엔지니어를 대상으로 합니다.
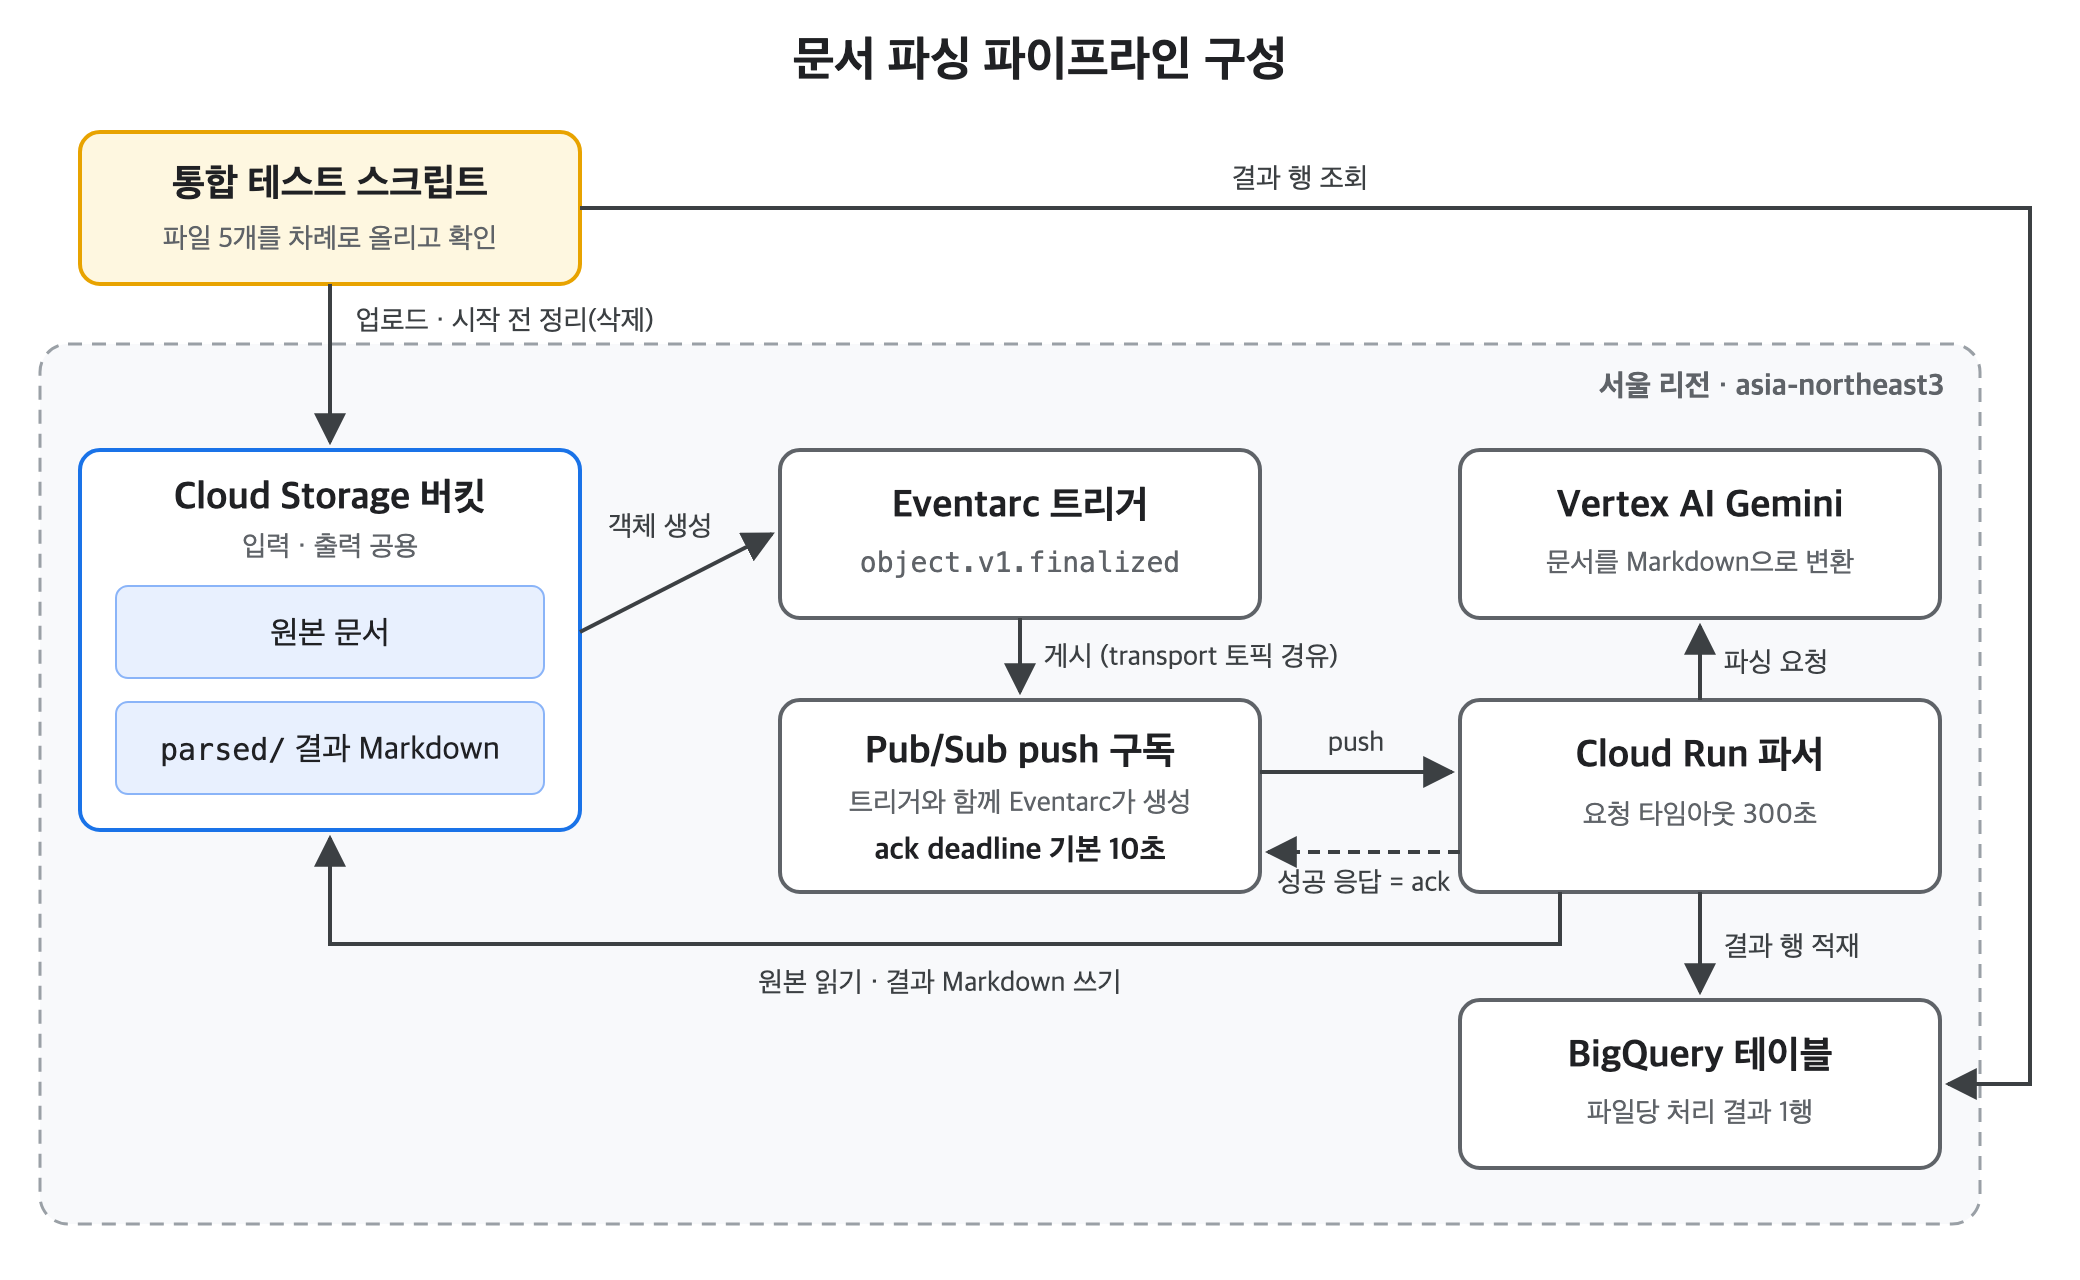
그림에서 이 글이 다루는 구간은 Pub/Sub push 구독과 Cloud Run 사이입니다. push 구독은 트리거를 만들 때 Eventarc가 함께 만드는 리소스이고, Cloud Run이 성공 응답을 돌려주는 것이 그 메시지에 대한 확인(ack)입니다. 버킷 하나를 입력과 출력에 함께 쓴다는 점, 테스트 스크립트가 시작할 때 이전 실행이 남긴 객체를 지운다는 점도 뒤에서 다시 나옵니다.
1. 404의 원인은 파일명 정규화가 아니었다
1-1. 버킷에는 원본도 결과물도 있었다
정규화 가설을 코드에서 따져 보는 대신 리소스의 실제 상태를 먼저 조회했습니다. 문제의 PDF도, 그 파싱 결과인 parsed/ 아래 Markdown도 버킷에 있었고 객체 이름은 모두 NFC였습니다. 이 파일의 파싱이 적어도 한 번은 성공했다는 뜻이므로, 정규화가 어긋나 객체를 영영 찾지 못하는 상황은 아니었습니다.
오류에 찍힌 NFD 형태의 URL은 서비스 코드의 폴백에서 나온 것이었습니다. 이 서비스는 NFC 이름으로 객체를 찾지 못하면 NFD 이름으로 한 번 더 찾는데, 로그에 남은 것이 그 두 번째 시도였습니다. 두 이름 모두로 찾지 못했다는 것은 정규화가 틀린 것이 아니라 그 요청이 처리되던 시점에 객체 자체가 없었다는 뜻입니다. 그렇다면 객체가 없는 시점에 왜 이 파일의 요청이 들어왔는지가 다음 질문이 됩니다.
1-2. 실패 행이 파일을 올리기도 전에 찍혀 있었다
테스트 스크립트는 파일마다 가장 최근 행 한 건만 조회하고 있었습니다. 같은 테이블을 전부, 처리 시각 순서로 다시 조회했습니다. 아래는 문제의 구간만 옮긴 발췌이고, 파일 이름은 자리표시자로 바꿨습니다.
10:19:20  FAILED   ${DOC}.pdf    ← 5번째 파일을 올리기 전
10:20:24  SUCCESS  ${DOC2}.txt   (4번째 파일)
10:20:40  SUCCESS  ${DOC}.pdf    (5번째 파일, 업로드 후 성공)
테스트는 파일을 하나씩 순차로 올리므로, 5번째 파일의 행은 4번째 파일이 끝난 10:20:24 뒤에만 생겨야 합니다. 그런데 FAILED 행은 그보다 1분 이상 앞선 10:19:20에 있었습니다. 이번 업로드가 만든 실패가 아니라, 이전 실행에서 발생한 이벤트가 이번 실행의 정리 단계로 객체가 지워진 뒤에 도착해 404를 냈다는 뜻입니다.
이 순서만으로 「재전송」까지 증명되지는 않습니다. 늦게 도착한 최초 전달일 수도 있기 때문입니다. 원인을 좁힌 것은 같은 조회에서 본 행의 개수였습니다. 파일은 5개인데 행은 27행이었고, 파일마다 4~7회씩 처리되고 있었습니다. 이벤트 하나가 늦은 것이 아니라 같은 이벤트가 반복해서 전달되고 있었습니다.
2. 응답하기 전에 같은 이벤트가 다시 왔다
2-1. push 구독의 ack deadline 기본값은 10초다
트리거가 만든 구독의 설정을 조회하자 ackDeadlineSeconds가 10이었습니다. ack deadline은 Pub/Sub 구독 속성 문서의 설명대로 확인되지 않은 메시지를 다시 보내기까지 기다리는 최초 기한이고, 기본값 10초에 최댓값은 600초입니다. push 구독에서는 엔드포인트가 돌려준 HTTP 상태 코드가 확인 여부를 정합니다. 200 같은 성공 코드가 확인이고, 그 밖의 코드를 돌려주거나 ack deadline이 지나면 Pub/Sub은 같은 메시지를 다시 보냅니다. 이 서비스는 Gemini 파싱에만 20초에서 1분 가까이 걸렸으므로, 대부분의 요청이 응답하기 전에 재전송 대상이 됐습니다.
이 10초는 누가 고른 값이 아닙니다. Cloud Run 이벤트 트리거 문서의 「Set the Pub/Sub acknowledgement deadline」 절은 이 구독의 ack deadline이 기본 10초이며 이 설정이 많은 함수와 서비스에 부족해서 원치 않는 중복 실행을 부를 수 있다고 적고, 최댓값인 600초로 설정할 것을 권장합니다. 트리거를 만들면 딸려 오는 값이라, 구독 값을 한 번 고쳐 두면 끝나는지가 궁금했습니다. 3절에서 직접 해 보니 그렇지 않았습니다.
2-2. 세 가지가 겹쳐 다음 실행까지 오염시켰다
재전송만으로는 이전 실행의 이벤트가 다음 실행 도중에 나타나는 것이 설명되지 않습니다. 원인은 세 층으로 겹쳐 있었습니다.
| 층위 | 무엇이 | 결과 |
|---|---|---|
| 근본 | ack deadline 10초 < 파싱 시간 20초~1분 | 응답하기 전에 같은 이벤트가 재전송된다 |
| 전파 | 실패에 500 응답 · 메시지 보존 기본 24시간 | 실행이 끝난 뒤에도 재시도가 이어져 다음 실행 중에 도착한다 |
| 표면 | 파일당 최신 행 1건만 조회 · 처리 시각 하한 없음 | 과거 실행의 FAILED 행을 이번 실행의 결과로 판정한다 |
표에서 문제를 다음 실행까지 끌고 간 것은 전파 층입니다. 그때 서비스는 처리에 실패하면 500을 돌려줬고, Eventarc 재시도 문서에 따르면 확인되지 않은 메시지는 10초에서 시작해 최대 600초까지 늘어나는 간격으로 다시 전달되며 Eventarc는 메시지 보존 기간을 기본 24시간으로 설정합니다. 테스트 한 번은 몇 분이면 끝나므로, 확인되지 않은 메시지가 실행이 끝난 뒤에도 남아 다음 실행 도중에 도착할 수 있었습니다. 그때는 원본이 이미 지워졌으니 404로 실패하고, 실패에 500을 돌려주니 재시도가 다시 이어졌습니다.
테스트의 정리 단계에는 parsed/ 아래에 결과물이 더 생기지 않는 상태가 일정 시간 이어지는지 기다려 이전 실행의 처리가 끝났는지 확인하는 로직이 있었지만, 이 경우를 잡지 못했습니다. 실패한 이벤트는 Markdown을 만들지 않으므로 「아직 처리 중이다」와 「처리할 것이 없다」가 같은 모습으로 보이기 때문입니다.
3. 구독 · 서비스 · 테스트 세 곳을 고쳤다
재전송이 생기는 구조를 없애는 것은 ack deadline이지만, 이미 전달된 무효 이벤트와 테스트의 오판은 따로 막아야 했습니다.
| 위치 | 바꾼 것 | 막는 것 |
|---|---|---|
| 배포 스크립트 | 트리거의 구독을 조회해 ack deadline을 600초로 갱신하는 단계 추가 | 처리 중 재전송 · 트리거 재생성 뒤 기본값 복귀 |
| 서비스 | 원본 객체가 없으면 500 대신 200(IGNORED)으로 응답하고 BigQuery에도 쓰지 않음 |
지워진 객체를 두고 반복되는 재시도 |
| 서비스 | 결과 Markdown에 원본의 generation을 기록해 같은 generation이면 다시 파싱하지 않음 | 중복 전달 시의 재파싱과 중복 행 |
| 테스트 스크립트 | 시작 전 구독에 seek을 걸어 밀린 메시지를 버림 · 결과 조회에 processed_at >= 업로드 시각 − 60초 조건 추가 (60초는 로컬 시계와 Cloud Run 시계의 오차를 감안한 여유분) |
이전 실행이 남긴 이벤트 · 과거 행 오판 |
generation은 객체를 쓸 때마다 바뀌는 버전 번호입니다. 결과 Markdown의 메타데이터에 원본의 generation을 새겨 두면, 같은 이벤트가 몇 번을 더 와도 이미 그 버전으로 만든 결과가 있는지 한 번의 조회로 확인합니다.
ack deadline을 600초로 잡은 근거는 Cloud Run의 요청 타임아웃입니다. 이 서비스는 300초로 설정했으므로, 재전송 판단 기준이 그보다 넉넉히 커야 정상 처리 중에 재전송이 일어나지 않습니다. 600초는 Pub/Sub이 허용하는 최댓값이기도 합니다.
콘솔에서 구독 값을 한 번 고치는 것으로는 부족합니다. 구독을 600초로 고친 뒤 무엇이 그 값을 되돌리는지 하나씩 해 봤습니다.
| 한 일 | ack deadline | 구독 |
|---|---|---|
| Cloud Run 새 리비전 배포 | 600초 유지 | 그대로 |
| 트리거 수정 — 라벨만 바꾸거나, 같은 서비스 계정을 다시 지정해도 | 10초로 복귀 | 이름은 그대로 |
| 트리거 삭제 후 같은 이름으로 재생성 | 10초 | 새 이름으로 다시 생김 |
예상한 것은 세 번째 줄뿐이었습니다. 두 번째 줄은 구독 이름이 바뀌지 않아서 값이 돌아간 것을 눈치채기 어렵습니다. 누군가 콘솔에서 트리거의 라벨 하나만 고쳐도 다음 배포 전까지 10초로 돕니다. 그래서 값을 맞추는 단계를 배포 스크립트 안에 넣었고, 이 스크립트는 트리거가 이미 있으면 트리거를 건드리지 않고 구독 값만 다시 맞춥니다.
# 트리거가 만든 구독 이름은 트리거에서 꺼낸다
SUB=$(gcloud eventarc triggers describe "${TRIGGER}" \
  --location="${REGION}" --project="${PROJECT_ID}" \
  --format="value(transport.pubsub.subscription)")

# 현재 값을 확인하고 600초로 갱신한다
gcloud pubsub subscriptions describe "${SUB}" --format="value(ackDeadlineSeconds)"
gcloud pubsub subscriptions update "${SUB}" --ack-deadline=600
수정 뒤 같은 테스트 스크립트로 같은 파일 5개를 다시 올렸습니다.
| 지표 | 수정 전 | 수정 후 |
|---|---|---|
| 파일당 Cloud Run 처리 횟수 | 4~7회 | 1회 |
| BigQuery 행 수 (파일 5개) | 27행 | 5행, 전부 SUCCESS |
| 통합 테스트 | 5번째 파일에서 중단 | 통과 (4분 49초) |
행 수가 파일 수와 같아졌다는 것이 파일마다 한 번씩만 처리됐다는 증거입니다. 파일별로 업로드에서 행 적재까지 걸린 시간은 56초 · 1분 7초 · 30초 · 17초 · 44초였습니다. 이 시간에는 이벤트가 전달되기까지의 지연과 BigQuery 적재까지 들어 있어 Cloud Run 요청 시간 자체와 같지 않고, 가장 짧은 파일은 그 전부를 합쳐 17초 안에 끝났습니다. 그래도 수정 전에는 다섯 파일이 모두 4~7회씩 다시 전달됐으므로, 파싱에 수십 초가 걸리는 이 서비스에서 ack deadline 10초로는 재전송을 피할 수 없었습니다.
표의 통과는 수정 후 두 번째 실행의 결과입니다. 첫 실행은 4절에서 다루는 BigQuery 404로 멈췄고, 그 원인이 된 테이블 재생성을 끈 다음 실행이 통과했습니다. 또 위 표의 수정을 한꺼번에 적용했으므로, 처리 횟수가 1회가 된 몫을 수정별로 나누어 재지는 않았습니다.
4. 재전송을 걷어내자 BigQuery 스트리밍 404가 드러났다
4-1. 방금 다시 만든 테이블이 없다고 나왔다
수정 후 첫 실행에서 테스트가 1번 파일의 결과 행을 기다리다 타임아웃했습니다. 파싱은 성공해 Markdown까지 나왔는데 BigQuery 적재만 실패했습니다.
[ERROR] BQ 저장 실패: 404 ... insertAll: Table ...${TABLE} not found.그때 테스트 스크립트는 실행할 때마다 결과 테이블을 지우고 다시 만들었고, 이 테이블도 방금 다시 만든 것이었습니다. 조회하면 테이블은 분명히 있었지만, 다시 만들고 59초가 지난 뒤에도 스트리밍 insert는 404를 받았습니다. BigQuery 스트리밍 문서의 「Metadata errors for streaming inserts」 절은 테이블 메타데이터 변경이 스트리밍 시스템에 최종적 일관성으로 전파되므로 새로 만든 테이블을 뒤이은 스트리밍 insert가 곧바로 인식하지 못할 수 있다고 설명합니다. 같은 절은 테이블을 지우거나 다시 만들면 한동안 스트리밍 insert가 사실상 옛 테이블로 전달되어 새 테이블에서는 보이지 않는 구간이 생긴다고도 적고 있습니다. 404는 적어도 실패가 눈에 보이지만, 뒤쪽은 오류 없이 행만 사라지므로 더 찾기 어렵습니다.
4-2. 테이블을 비우지 않고 이번 실행의 행만 골라 본다
테스트가 테이블을 다시 만든 데에는 이유가 있었습니다. 스트리밍으로 방금 쓴 행은 DELETE로 지울 수 없어서, 테스트를 연달아 돌리며 이전 실행의 행을 없애려면 테이블째 다시 만드는 것이 빨랐기 때문입니다. 이 서비스는 tabledata.insertAll로 행을 씁니다. BigQuery DML 문서의 Limitations 목록은 최근 30분 안에 쓴 행을 UPDATE · DELETE · MERGE · TRUNCATE로 수정할 수 없다고 적으면서 그 대상을 「Storage Write API (REST)」로 적고 gRPC 방식과 구분합니다. 여기서 REST 쪽이 이 서비스가 쓰는 경로입니다. 스트리밍 문서가 그 이름을 「이전에 레거시 tabledata.insertAll 방식으로 불리던 것」이라고 밝히고 있습니다. 쓰는 경로에 따라 이 제한에 걸리는지가 달라지므로 자기 코드가 어느 쪽인지 확인해야 합니다.
그런데 3절에서 결과 조회에 처리 시각 하한을 넣은 순간 그 전제가 사라졌습니다. 이번 실행의 행만 골라 볼 수 있다면 테이블을 비울 이유가 없습니다. 그래서 테이블 재생성을 기본 동작에서 빼고 옵션을 줄 때만 하도록 바꿨습니다. 시각 하한이 완전한 격리는 아닙니다. 오래된 이벤트가 이번 실행 도중에 도착해 기록되면 그 행도 하한을 통과하므로, 확실히 가르려면 실행 식별자나 원본 generation으로 묶어야 합니다.
이 404가 그전까지 보이지 않았던 이유도 재전송에 있습니다. 중복 전달된 요청 중 하나가 나중에 성공하면서 행이 결국 채워졌고, 테스트는 통과한 것으로 보였습니다. 재시도가 잦은 시스템은 이런 식으로 다른 결함을 가립니다.
5. 남은 과제
ack deadline을 늘린 것은 「응답하기 전의 재전송」을 없앤 것이지 재전송 자체를 없앤 것이 아닙니다. Pub/Sub push는 최소 한 번 전달(at-least-once)이라 중복 전달이 원칙적으로 가능하고, 처리가 요청 타임아웃 300초를 넘겨 성공 응답을 돌려주지 못하면 재전송은 다시 열립니다. 이때 generation 검사에는 좁은 경합 구간이 남습니다. 중복된 두 요청이 거의 동시에 도착하면 둘 다 결과 Markdown이 아직 없는 상태를 보고 파싱을 시작할 수 있습니다. 수정 뒤에는 중복 전달이 관측되지 않아 실질 위험은 낮다고 봤고, 완전히 없애려면 처리를 시작할 때 마커 객체를 조건부 쓰기로 선점하는 잠금이 필요합니다.
원본이 없을 때 200으로 응답하게 바꾼 것에도 대가가 있습니다. 재전송된 과거 이벤트만 이 길로 오는 것이 아닙니다. 경로 오타나 정규화 버그로 생긴 진짜 404도 같은 길로 조용히 확인 처리되고, BigQuery에는 아무것도 남지 않습니다. 남는 것은 Cloud Logging의 경고 한 줄(원본 객체 없음 — 무효 이벤트로 ack)뿐입니다. 지금은 이것을 자동으로 잡는 장치가 없어서, 로그를 직접 조회하거나 그 문구에 로그 기반 지표와 알림을 걸어야 합니다.
입력과 출력이 같은 버킷이라는 점도 그대로입니다. Cloud Storage 트리거의 필터는 이벤트 종류와 버킷뿐이고 경로로 거를 수 없습니다. 그래서 서비스가 parsed/에 Markdown을 쓸 때마다 이벤트가 생기고 Cloud Run이 추가로 호출됩니다. parsed/ 아래에 파일 하나를 올려 보니, 이후 90초 동안 요청이 한 건 들어왔습니다. 지금은 parsed/ 아래 객체를 무시하고 바로 200을 돌려주는 코드로 재처리를 막을 뿐, 할 일 없는 호출 자체는 남습니다. 3절 표의 「파일당 처리 1회」는 BigQuery 행 수로 센 값이라, 행을 남기지 않는 이 호출은 들어 있지 않습니다. 버킷을 나누면 이 호출도, 방어 코드도 필요 없어집니다.
같은 프로젝트에서 같은 방식으로 만든 다른 트리거 세 개도 구독의 ack deadline이 10초였습니다. 값만 확인했고 그쪽에서 실제로 중복 처리가 일어났는지는 보지 않았습니다. 소유자가 다른 리소스라 값을 바꾸지 않았습니다. 기본값이 만든 문제는 대개 한 곳에만 있지 않습니다.
마치며
처음 질문은 파일을 올리기도 전에 왜 그 파일의 404 실패 행이 생겼는가였습니다. 답은 Eventarc가 만든 push 구독의 ack deadline 10초가 파싱 시간보다 짧아 같은 이벤트가 반복 전달됐고, 확인되지 않은 메시지가 기본 24시간 보존되면서 이번 실행의 정리 단계로 지워진 객체를 뒤늦게 찾았다는 것입니다. 구독을 600초로 올리고 무효 이벤트에 200으로 응답하게 한 뒤, 같은 테스트에서 파일마다 한 번씩만 처리되는 것을 확인했습니다. 다만 수정을 한꺼번에 적용했으므로 수정별 효과는 나누어 재지 않았고, 경합 구간은 남아 있습니다.
Eventarc로 Cloud Run을 호출하는 구성에서 요청 처리가 10초를 넘을 수 있다면, 트리거를 만든 직후 transport.pubsub.subscription이 가리키는 구독의 ack deadline을 확인하는 편이 좋습니다. 이 값은 트리거와 함께 생기고 트리거를 다시 만들면 돌아오므로, 콘솔에서 한 번 고치기보다 배포 스크립트의 한 단계로 두어야 유지됩니다. 서비스 쪽은 최소 한 번 전달을 전제로, 이미 처리했거나 처리할 수 없는 이벤트에는 성공 응답을 돌려줘 재시도 루프를 끊어야 합니다.
진단에서 가져갈 기준은 두 가지입니다. 오류 메시지의 눈에 띄는 단서보다 리소스의 실제 상태를 먼저 조회하고, 결과 테이블은 최신 한 건이 아니라 시간순 전체로 봅니다. 이 글에서는 버킷에 결과물이 이미 있었다는 사실과 실패 행이 업로드보다 앞서 있었다는 순서가 정규화 가설을 뒤집었습니다. 그리고 비동기 파이프라인의 테스트는 상태를 지워 격리하기보다 실행 단위로 결과를 골라 보는 편이 안전합니다. 지우는 방식은 4절의 스트리밍 404처럼 그 자체가 새로운 실패를 만듭니다.
참고 자료
- Cloud Run — Trigger with events
- Pub/Sub — Subscription properties
- Pub/Sub — Push subscriptions
- Eventarc — Retry events
- BigQuery — Streaming data into BigQuery
- BigQuery — Data manipulation language
- Pub/Sub — Replay and purge messages
부록: 테스트를 시작하기 전에 밀린 이벤트 버리기
아래는 테스트 환경 전용입니다. 운영 구독에 돌리면 아직 처리되지 않은 이벤트가 그대로 사라집니다.
# 지정한 시각 이전에 받은 메시지를 모두 확인 처리한다
# --time 은 RFC 3339 형식이다. 여기서는 UTC(Z)로, 1분 뒤 시각을 적었다 (GNU date · Cloud Shell)
# macOS 에서는 date -u -v+1M +%Y-%m-%dT%H:%M:%SZ
gcloud pubsub subscriptions seek "${SUB}" \
  --time="$(date -u -d '+1 minute' +%Y-%m-%dT%H:%M:%SZ)"
Pub/Sub 재생 문서의 설명대로 시각으로 seek을 걸면 그 시각 이전에 받은 메시지는 확인된 것으로 표시됩니다. 기준이 되는 것은 메시지를 받은 시각이라, 현재 시각으로 걸면 명령을 내리는 사이에 들어온 메시지가 남을 수 있습니다. 같은 문서는 밀린 메시지를 전부 버릴 때 미래 시각을 쓰라고 안내하고, seek이 완전히 적용되기까지 최대 1분이 걸릴 수 있다고 적습니다. 위 예시는 그 안내를 따라 1분 뒤 시각으로 걸었고, 이렇게 쓸 때는 1분이 지난 뒤에 테스트 파일을 올려야 합니다. 이 글의 테스트 스크립트는 현재 시각으로 걸고 있어서, 명령 사이에 들어온 메시지가 남을 틈이 있습니다.