
들어가며
지난 글 [AWS S3 Files 기반 온프레미스 SMB 파일 공유 환경 구축하기-1]에서는 AWS S3 Files와 Samba를 이용해 S3 버킷을 SMB로 공유하고, Site-to-Site VPN을 통해 IDC 서버에서 마운트하는 구성을 다뤘습니다. 구성 자체는 문제없이 동작했지만, “그래서 실제로 얼마나 빠른가”는 별개의 질문이었습니다.
이번 글에서는 이 조합의 실사용 성능을 fio로 검증한 과정과 결과를 다룹니다. 특히 예상과 다르게 나온 두 가지 결과인 순차 I/O의 워밍업 효과, 동시 접속 시 처리량 저하를 어떻게 원인 추적했는지에 집중했습니다.
이번 성능 검증은 재현 가능하고 투명하게 공유할 수 있도록, 동일 리전(서울) 내에 VPC 두 개를 두고 Site-to-Site VPN으로 연결해 온프레미스 환경을 시뮬레이션한 환경에서 진행했습니다. 구성에 사용한 인스턴스 스펙과 명령어를 모두 본문에 공개했으니, 비슷한 환경을 검토 중이시라면 그대로 재현해보실 수 있습니다.
구성 환경
동일 리전(서울) 내 VPC 두 개를 두고 Site-to-Site VPN으로 연결해, 온프레미스 라우터 역할은 퍼블릭 서브넷에 위치한 EC2가 대신하는 형태로 구성했습니다. (테스트 수행일: 2026.08.15)
| 역할 | 위치 | 인스턴스 타입 | vCPU / 메모리 | 네트워크 대역폭 |
| Samba 서버 (S3 Files NFS 마운트 + SMB 공유) | VPC-A (10.70.0.0/16, AWS 측) | m6i.large | 2 vCPU / 8 GiB | Up to 12.5 Gbps |
| VPN 장비 (Customer Gateway 역할) | VPC-B (10.1.0.0/16, 가상 IDC) | c6i.large | 2 vCPU / 4 GiB | Up to 12.5 Gbps |
| IDC 클라이언트 (SMB 마운트) | VPC-B 프라이빗 서브넷 | m6i.large | 2 vCPU / 8 GiB | Up to 12.5 Gbps |
네트워크 대역폭 관련 공식문서 : m6i.large , c6i.large
VPN 장비는 IPsec 암복호화가 CPU 바운드 작업이라는 점을 고려해 컴퓨팅 최적화 인스턴스(c6i)로, 나머지는 범용 인스턴스(m6i)로 설정했습니다. 또한 fio가 데이터를 읽고 쓰는 /mnt/smb_s3files는 SMB로 마운트된 네트워크 경로이며, 로컬 EBS를 거치지 않고 Samba EC2를 통해 S3까지 직접 오가기 때문에 로컬 디스크 스펙은 기재하지 않았습니다.
전체 구성 흐름은 아래와 같습니다.
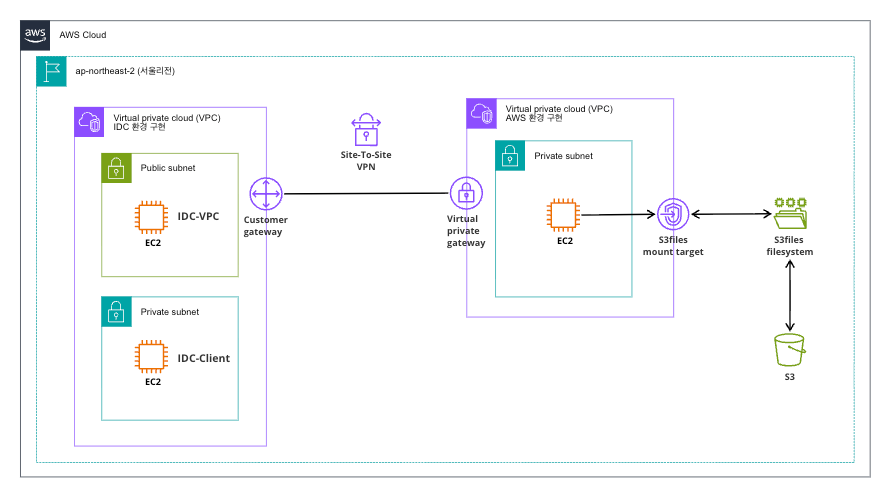
Site-to-Site VPN은 정적 라우팅 + 단일 터널로 구성했습니다.
운영 환경에서는 BGP 기반 이중 터널을 권장하지만, 이번 검증의 목적은 “S3 Files + SMB 조합이 VPN 환경에서 정상 동작하고 어느 정도 성능을 내는가”였기 때문에 VPN 자체의 복잡도는 최소화했습니다.
측정 방법
| 도구 | 역할 | 측정 지표 |
| dd | 참고 지표 | 소요시간만 (특정 용량 파일 생성/읽기에 걸린 시간) |
| fio | 핵심 성능 데이터 | Throughput, IOPS, Latency (avg / p99) |
네트워크 순수 대역폭(iperf3)은 별도로 측정하지 않았습니다. VPN 대역폭은 AWS 스펙(단일 터널 기준 최대 1.25Gbps)으로 이미 알려져 있고, 이번 검증의 핵심은 “네트워크가 빠른가”가 아니라 “S3 Files + SMB 조합이 실사용에 쓸 만한가”이기 때문입니다. 모든 fio 테스트는 –direct=1로 OS 페이지 캐시를 우회했고, 각 테스트는 3회 반복 후 평균을 기록했습니다.
순차 I/O (대용량 파일 업/다운로드 시뮬레이션)
큰 파일 하나를 통째로 쓰거나 읽는 시나리오입니다. 도면 파일이나 백업 아카이브처럼 대용량 파일을 S3로 올리거나 내려받을 때의 처리량을 가늠하는 테스트입니다.
fio --name=seq-write --directory=/mnt/smb_s3files --rw=write --bs=1M --size=512M \ --numjobs=1 --time_based --runtime=30 --group_reporting --direct=1
fio --name=seq-read --directory=/mnt/smb_s3files --rw=read --bs=1M --size=512M \ --numjobs=1 --time_based --runtime=30 --group_reporting --direct=1
| 테스트 | Throughput | IOPS | Latency (avg) | Latency (p99) |
| 순차 쓰기 | 137.3 MiB/s | 137 | 7.26 ms | 16.3 ms |
| 순차 읽기 | 141.3 MiB/s | 141 | 7.07 ms | 14.8 ms |
이 처리량은 VPN 터널 대역폭 상한(1.25Gbps)의 약 92~95% 수준으로, 순차 I/O 구간에서는 SMB나 S3 Files 계층이 아니라 VPN 터널 자체가 이미 실질적인 상한선에 가깝게 작용하고 있다고 볼 수 있습니다. 참고로 dd로 512MB 파일을 쓰고 읽는 데 걸린 시간도 각각 6.85초, 6.93초로 fio 순차 결과와 근접해, 두 도구가 서로 결과를 교차 검증해주었습니다.
흥미로운 점 하나는, 이번 조합에서 순차 쓰기(137.3 MiB/s)가 순차 읽기(141.3 MiB/s)와 거의 대칭적인 성능을 보였다는 것입니다.
일반적으로 스토리지 시스템은 읽기가 쓰기보다 빠른 경우가 많은데, 이 구성에서는 그 차이가 크지 않았습니다. 또한 최초 단일 실행 시에는 각각 81 MiB/s, 75 MiB/s 수준이었던 것이, 3회 반복 평균에서는 137~141 MiB/s로 약 70% 높게 나타났습니다. 모든 테스트에 –direct=1을 적용했기 때문에 OS 페이지 캐시로 인한 효과는 아니며, NFS readahead나 S3 Files의 데이터 계층 프리페치 효과로 추정되지만, 정확한 메커니즘은 이번 검증에서 확정하지 못했습니다. 지속적으로 반복 접근하는 워크로드라면 초기 실행보다 나은 성능을 기대할 수 있다는 정도로 참고하시면 좋겠습니다.
랜덤 I/O — 단일 사용자 (문서 파일 열람 시뮬레이션)
파일 전체가 아니라 작은 블록 단위로 여기저기 흩어진 위치를 읽는 시나리오입니다. 사용자가 문서 파일 하나를 열어볼 때, 파일 시스템이 실제로 겪는 접근 패턴에 가깝습니다.
fio --name=rand-read-4k --directory=/mnt/smb_s3files --rw=randread --bs=4K --size=64M \ --numjobs=1 --time_based --runtime=30 --group_reporting --direct=1
| 테스트 | Throughput | IOPS | Latency (avg) | Latency (p99) |
| randread 4K (1명) | 1.4 MiB/s | 358 | 2.79 ms | 5.71 ms |
일반 문서 파일 하나를 열어보는 수준의 접근에서는 평균 2.79ms, p99 기준으로도 6ms 이내에 응답이 왔습니다. 단일 사용자의 체감 성능으로는 충분히 실용적인 수준입니다.
랜덤 I/O — 동시 접속 8명 (여러 사용자 동시 접근 시뮬레이션)
앞선 테스트와 같은 랜덤 읽기지만, 이번엔 8개의 프로세스가 동시에 파일을 읽습니다. 여러 사용자가 같은 시간대에 공유 폴더에 접근했을 때 성능이 얼마나 유지되는지 보기 위한 테스트입니다.
fio --name=rand-read-8users --directory=/mnt/smb_s3files --rw=randread --bs=64K --size=128M \ --numjobs=8 --time_based --runtime=30 --group_reporting --direct=1
| 테스트 | Throughput | IOPS | Latency (avg) | Latency (p99) |
| randread 64K (8명, 초기 실행) | 114.8 MiB/s | 1,835 | 4.36 ms | 9.1 ms |
이 테스트에서 가장 흥미로운 발견이 나왔습니다. 위 표는 8-job 테스트를 최초 2회 실행했을 때의 결과이며, 이 상태로는 8명이 동시 접속해도 평균 4.36ms의 안정적인 응답이 나옵니다. 그런데 동일한 8-job 테스트를 쿨다운 없이 연속으로 8회 반복 실행해보니, 처리량이 점진적으로 떨어졌습니다.
| 실행 순서 | Throughput |
| 1차 (초기) | 114.9 MiB/s |
| 2차 (초기) | 114.5 MiB/s |
| 3차 | 75.5 MiB/s |
| 4차 | 56.9 MiB/s |
| 5차 | 56.3 MiB/s |
| 6차 | 55.9 MiB/s |
| 7차 | 47.5 MiB/s |
| 8차 | 46.6 MiB/s |
최종적으로 초기 대비 약 50%까지 처리량이 감소했습니다. 원인을 좁혀보기 위해 다음을 확인했습니다.
- Samba EC2 CPU: sar로 캡처한 결과 해당 구간 idle 85~95%로, CPU는 병목이 아니었습니다.
- 네트워크 패킷 손실: nfsstat의 재전송(retrans) 카운트가 0으로, 네트워크 구간의 문제도 아니었습니다.
- S3 Files 자체의 처리량 제한 여부: AWS 공식 문서에는 S3 Files가 워크로드에 맞춰 처리량/IOPS를 자동으로 스케일한다고 되어 있어, 처음에는 S3 Files 백엔드의 스로틀링을 의심했습니다. 그런데 CloudWatch의 AWS/S3Files 네임스페이스에서 DataReadBytes 지표를 확인해보니, S3 Files가 실제로 서빙한 바이트량은 초기 안정 구간과 처리량 감소 구간 모두에서 분당 약 1,031~1,265 MB 수준으로 큰 차이가 없었습니다. (fio 실행이 30초 단위인 반면 CloudWatch 집계는 1분 단위라 경계에 걸리는 구간에서 값의 변동이 있었지만, 두 구간을 비교했을 때 유의미한 차이는 없었습니다.)
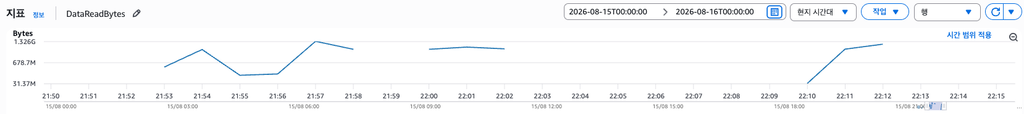
즉, S3 Files 백엔드는 계속 정상적으로 데이터를 내려주고 있었는데도 fio 클라이언트가 체감하는 처리량은 절반으로 떨어진 것입니다.
이 시점에는 SMB 프로토콜 계층이나 Samba의 NFS→SMB 변환 과정에서 오버헤드가 누적되는 현상일 가능성이 높다고 판단했습니다. 다만 아래에서 다루듯, 이후 재현을 시도하는 과정에서 이 판단에 대한 확신은 다소 흔들렸습니다.
후속 재현 시도
이 저하가 재현 가능한 현상인지 확인하기 위해, 이후 두 차례에 걸쳐 같은 8-job 테스트를 8회 연속 반복해봤습니다.
| Run | 8/15 원본 | 재검증 1차 | 재검증 2차 |
| 1회차 | 114.9 MiB/s | 114 MiB/s | 114 MiB/s |
| 2회차 | 114.5 MiB/s | 114 MiB/s | 114 MiB/s |
| 3회차 | 75.5 MiB/s | 114 MiB/s | 115 MiB/s |
| 4회차 | 56.9 MiB/s | 115 MiB/s | 115 MiB/s |
| 5회차 | 56.3 MiB/s | 115 MiB/s | 114 MiB/s |
| 6회차 | 55.9 MiB/s | 114 MiB/s | 114 MiB/s |
| 7회차 | 47.5 MiB/s | 114 MiB/s | 114 MiB/s |
| 8회차 | 46.6 MiB/s | 114 MiB/s | 114 MiB/s |
두 차례 모두 저하가 재현되지 않았습니다. 처음에는 “서버 Samba/NFS 세션이 누적돼 저하가 나타난 것”이라는 가설을 세웠지만, 재검증 시점에는 서버 3대 모두 8/15 이후 한 차례 재시작된 상태였고, 재시작 후 약 20시간이 지난 시점에서도 저하가 나타나지 않았습니다. 다만 이번 재검증은 재시작 후 약 20시간이라는 한 시점 부근에서만 이뤄진 것이라 “장시간 가동 자체가 원인이 아니다”라고 완전히 단정하기보다는, 최소한 그 시점까지는 저하가 나타나지 않는다는 정도로 조심스럽게 해석하는 게 맞을 것 같습니다.
재검증 과정에서 새롭게 발견한 사실(뒤에 나오는 “날짜 간 성능 편차” 참고)을 감안하면, 8/15의 저하가 SMB 계층의 누적 오버헤드가 아니라, S3 Files가 접근 빈도에 따라 데이터를 고성능 계층으로 올리고 내리는 과정의 타이밍에 우연히 걸렸을 가능성도 배제할 수 없습니다. 즉 처음 판단했던 “SMB/Samba 계층 오버헤드”라는 결론은 여러 가설 중 하나로 낮춰서 봐야 할 것 같습니다.
실무적으로는, 8명이 30초 이상 끊임없이 랜덤 읽기를 쏟아붓는 상황 자체가 일반적인 파일 공유 사용 패턴과는 거리가 있고, 이번 검증에서도 이런 저하가 항상 나타나는 건 아니었습니다. 다만 드물게라도 이런 저하가 발생할 수 있다는 점은 감안하고, 백업 배치나 대규모 동기화처럼 지속적인 고부하가 걸리는 워크로드를 이 구성 위에 올릴 계획이라면 여유를 두고 사전 검증하는 것을 권장합니다.
랜덤 I/O — 읽기/쓰기 혼합 (실제 업무 패턴 시뮬레이션)
읽기만 있는 앞선 테스트들과 달리, 읽기 70%·쓰기 30% 비율로 섞인 시나리오입니다. 실제 업무 환경은 순수 읽기나 순수 쓰기보다 이런 혼합 패턴에 가깝습니다. job 수는 앞선 randread 64K 테스트와 동일하게 8로 맞춰, 쓰기가 섞였을 때의 순수한 영향만 비교할 수 있게 했습니다.
fio --name=mixed-rw --directory=/mnt/smb_s3files --rw=randrw --rwmixread=70 --bs=64K --size=256M \ --numjobs=8 --time_based --runtime=30 --group_reporting --direct=1
| 구분 | Throughput | IOPS | Latency (avg) | Latency (p99) |
| 읽기 (70%) | 80.8 MiB/s | 1,293 | 4.59 ms | 10.7 ms |
| 쓰기 (30%) | 35.1 MiB/s | 561 | 3.66 ms | 15.1 ms |
읽기와 쓰기가 동시에 발생하는 실제 업무 패턴에서도 8명 동시 사용 기준 평균 5ms 내외의 응답 시간을 유지했습니다.
randread 64K vs randrw 70/30 — 동일 조건(8jobs) 비교
job 수를 동일하게 맞춘 덕분에, 쓰기가 섞였을 때 읽기 성능이 순수하게 얼마나 저하되는지 바로 비교할 수 있습니다.
| randread (순수 읽기) | randrw 70/30 (혼합) | 변화 | |
| Read Throughput | 114.8 MiB/s | 80.8 MiB/s | −30% |
| Read IOPS | 1,835 | 1,293 | −30% |
| Read Latency (avg) | 4.36 ms | 4.59 ms | +5% |
동일한 8-job 조건에서, 쓰기가 30% 섞이면 읽기 throughput이 약 30% 감소했습니다. 읽기/쓰기가 동시에 발생하면서 네트워크 대역폭과 NFS/SMB 처리 큐 같은 자원을 경합하기 때문으로 보입니다. 읽기/쓰기가 섞인 워크로드를 계획 중이라면, 순수 읽기 테스트 수치만으로 용량을 산정하지 않는 것이 안전합니다.
날짜 간 성능 편차 — 절대 수치보다 상대 비교에 주목해야 하는 이유
randread 64K 저하 현상을 재검증하는 과정에서, 예상하지 못했던 또 다른 사실을 발견했습니다. 같은 인스턴스, 같은 명령어로 실행했는데도, 날짜에 따라 순차 I/O 성능이 크게 달랐습니다.
| 테스트 | 8/15 (원본) | 8/19 (재검증) | 차이 |
| 순차 쓰기 | 137.3 MiB/s | 209 MiB/s | +53% |
| 순차 읽기 | 141.3 MiB/s | 111 MiB/s | −21% |
| randread 4K IOPS | 358 | 1,063 | 약 3배 |
순차 쓰기는 53% 더 빨라졌는데 순차 읽기는 21% 느려졌고, randread 4K의 IOPS는 3배 가까이 뛰었습니다. 방향성도 제각각이라 한 가지 원인으로 깔끔하게 설명되지 않습니다. 짐작 가는 원인 후보는 이렇습니다.
- 물리 호스트 재배치: 8/15와 8/19 사이에 EC2를 중지·시작(stop/start)했는데, 이 과정에서 AWS 내부적으로 다른 물리 호스트에 재배치됐을 가능성이 있습니다. 새 호스트의 네트워크/메모리 대역폭이 다르거나, 다른 테넌트와의 자원 경합(noisy neighbor) 정도가 달라졌을 수 있습니다.
- S3 Files 데이터 계층 상태: S3 Files는 자주 접근하는 데이터를 고성능 계층으로 옮겨두는 것으로 알려져 있습니다. 8/15는 이 구성으로 처음 테스트하던 시점이라 데이터가 콜드(cold) 상태였을 수 있고, 8/19는 여러 차례 접근한 뒤라 이미 핫(hot) 데이터로 승격돼 있었을 수 있습니다. randread 4K의 IOPS가 3배 뛴 것은 이 가설과 어느 정도 맞아떨어집니다.
- VPN 터널 재협상: stop/start 이후 EIP가 바뀌면서 VPN 터널도 새로 맺어졌을 텐데, 다른 AWS VPN 엔드포인트에 붙었을 가능성이 있습니다. 다만 이 경우 순차 쓰기와 순차 읽기 양쪽에 비슷한 방향으로 영향을 줘야 하는데, 실제로는 쓰기만 올라가고 읽기는 내려가서 이 가설만으로는 설명이 부족합니다.
세 가설 모두 추정이고, 이번 검증만으로는 어느 것이 실제 원인인지 확정하지 못했습니다. 다만 이 편차 자체가 주는 실무적 시사점은 명확합니다
이 글에 실린 절대 수치(137.3 MiB/s, 141.3 MiB/s 등)를 여러분의 환경에 그대로 적용하지 마시고, 같은 조건에서도 시점에 따라 수십 % 단위로 달라질 수 있다는 점을 감안해야 합니다.
오히려 이번 검증에서 신뢰도가 높은 건 “같은 시점, 같은 조건에서의 상대 비교”입니다. randread 64K와 randrw 70/30을 8/19 같은 세션 안에서 비교했을 때 나온 “쓰기가 섞이면 읽기가 30% 감소한다”는 결론은, 같은 시점 내 비교라 이런 날짜 간 편차의 영향을 받지 않는 값이라 상대적으로 신뢰할 수 있습니다.
실제로 이 구성의 도입을 검토하신다면, 이 글의 절대 수치를 그대로 용량 산정에 쓰기보다는, 여러분의 환경에서 동일한 fio 명령어로 직접 측정해보시는 것을 권장합니다.
마치며
이번 검증에서는 몇 가지 방향으로 유용한 결과를 얻었습니다. 단일 사용자의 문서 파일 접근이나 8명 수준의 동시 접속에서는 실용적인 응답 시간(수 ms대)을 확인했고, 쓰기가 섞인 혼합 워크로드에서는 순수 읽기 대비 읽기 성능이 약 30% 감소한다는 것도 같은 시점 내 비교로 확인했습니다.
다만 두 가지는 애초 예상보다 결론을 낮춰 잡아야 했습니다. 하나는 8명 동시 접속 상태에서 부하를 지속하면 처리량이 절반 가까이 떨어지는 현상으로, 처음에는 SMB/Samba 계층의 오버헤드 누적으로 추정했지만 이후 재검증에서 재현되지 않아 원인 미상의 간헐적 현상으로 정정했습니다. 다른 하나는 순차 I/O의 반복 실행 시 상승하는 워밍업 효과로, 정확한 메커니즘은 끝내 확정하지 못했습니다. 그리고 이 둘을 재현하는 과정에서, 같은 조건인데도 날짜에 따라 성능이 최대 53%까지 달라진다는 새로운 문제를 발견했습니다.
정리하면, 이 시리즈에 실린 절대적인 수치보다는 “쓰기가 섞이면 얼마나 손해를 보는가”처럼 같은 시점 내에서 비교한 상대적 경향에 더 무게를 두고 참고하시길 권합니다. 이번 검증은 소규모 환경을 기준으로 진행했으며, 실제 도입을 검토하신다면 여러분의 환경에서 직접 재현해보시는 것을 권장합니다.
| AWS의 파트너사인 MegazoneCloud 소속으로 AWS AI Ambassador 후보자로 활동하며 작성한 내용입니다. AWS의 서비스를 소개하고, 실제 업무에서 사용한 사례들에 대한 내용들을 담고 있습니다. |
| Written By. Seungyeon Lee |