
들어가며
생성형 AI 서비스가 운영에 들어가면 가장 먼저 듣는 불만은 대개 정확도가 아니라 속도입니다. 여러 부서가 모델을 함께 쓰는 엔터프라이즈 플랫폼이라면 더욱 그렇습니다.
이 글은 그런 환경에서 실제로 마주한 사례를 바탕으로 하되, 구성은 일반화해 소개합니다. 플랫폼 구성은 다음과 같습니다.
| 구분 | 구성 |
|---|---|
| 게이트웨이 | Azure API Management(APIM, API 게이트웨이 서비스) |
| 모델 플랫폼 | Microsoft Foundry(구 Azure AI Foundry) |
| 배포 유형 | GlobalStandard: 전 세계 데이터센터 용량을 공유하는 종량제 배포 |
| 리전 | 한국 중부(Korea Central), 미국 동부 2(East US 2) |
| 모델 | gpt-6 계열 4종(gpt-6-astra, gpt-6-sol, gpt-6-luna, gpt-6.1-sol), gpt-5.6 3종(gpt-5.6-sol, gpt-5.6-terra, gpt-5.6-luna), gpt-5.5, gpt-5.4, gpt-5.4-mini, 임베딩 모델 |
| 호출 업무 | 문서 처리와 요약, 사내 지식 검색 챗봇(RAG, 검색 증강 생성), 업무 자동화 에이전트, 비정형 데이터 정제와 임베딩, 보고서 초안 생성, 다국어 번역 |
여러 부서의 업무가 이 위에서 용도에 맞는 모델을 골라 호출합니다. 호출하는 업무가 늘어날수록 응답이 느리다는 이야기도 잦아졌고, 곧 이런 요청이 올라왔습니다.
“이미 한국 중부와 미국 동부 2, 두 리전을 함께 쓰고 있는데도 응답이 느립니다. 요청이 몰려 대기열이 밀리는 것 같으니, 할당량을 늘리거나 일본 리전까지 추가하면 해결될까요?”
그럴듯한 처방입니다. 여러 업무가 같은 배포를 나눠 쓰니 줄이 길어질 것 같고, 리전을 하나 더 늘려 줄을 나누면 빨라질 것 같으니까요. 하지만 가정이 틀리면 비용만 늘고 지연은 그대로 남습니다.
그래서 증설보다 먼저 “지연이 정확히 어디에서 생기는가”부터 확인했습니다. 호출량이 가장 많고 응답이 느리다는 불만이 집중된 gpt-5.5 배포의 2주간 운영 지표는 예상과 전혀 다른 방향을 가리켰습니다.
- 할당량 초과 오류(HTTP 429, 아래 1절 표 참고)는 0건이었습니다.
- 분당 토큰 수(TPM, Tokens Per Minute)는 피크에도 배포 한도의 약 64%로, 3분의 1 이상이 남아 있었습니다.
- 응답 시간과 가장 강하게 함께 움직인 것은 요청량이 아니라 요청당 출력 토큰 수였습니다.
이 글은 그 진단을 통제된 실습 환경에서 변수별로 다시 재현해 검증한 기록입니다. 출력 길이, 동시 요청 수, 추론 강도, 입력 길이를 하나씩 바꿔 가며 응답 시간을 분해했고, 재현에 쓴 Azure CLI와 측정 코드, KQL(Kusto 쿼리 언어, Log Analytics 질의 언어)을 모두 본문에 실었습니다. 비슷한 증설 검토를 앞두고 계시다면 같은 방식으로 직접 확인해 보실 수 있습니다.
1. 먼저 알아둘 것: 지연 지표와 HTTP 오류 코드
LLM(대규모 언어 모델)의 응답 시간은 하나의 숫자로 보면 원인을 나눌 수 없습니다. 이 글에서는 다음 네 가지로 쪼개서 봅니다.
| 용어 | 뜻 | 쉽게 말하면 |
|---|---|---|
| 첫 토큰 시간 (TTFT, Time To First Token) | 요청을 보낸 뒤 첫 토큰이 도착하기까지의 시간 | 모델이 “말을 시작하기까지” 걸린 시간 |
| 토큰 간 간격 (TBT, Time Between Tokens) | 토큰 하나를 만들고 다음 토큰을 만들기까지의 간격 | 모델이 “말하는 속도” |
| 전체 응답 시간 (TTLT, Time To Last Token) | 요청을 보낸 뒤 응답이 끝나기까지의 전체 시간 | 사용자가 체감하는 “응답 시간” |
| 생성 토큰 | 모델이 만들어 낸 출력 토큰 수 (추론 토큰 포함) | 모델이 “말한 분량” |
할당량을 의심할 근거가 되는 것은 HTTP 오류 코드입니다. Microsoft Foundry의 Azure OpenAI 모델이 돌려주는 주요 오류는 다음과 같습니다(Troubleshoot common HTTP errors for Azure OpenAI).
| 코드 | 의미 | 주요 원인 | 대응 |
|---|---|---|---|
| 400 | 잘못된 요청 | 요청 형식 오류, 컨텍스트 길이 초과, 콘텐츠 필터 차단 | 오류 메시지의 검증 실패 항목 확인 |
| 401 | 인증 실패 | API 키 오류, Entra ID 토큰 만료나 범위 오류, 역할 누락 | 키, 토큰, 역할 기반 접근 제어(RBAC) 할당 확인 |
| 403 | 접근 거부 | 네트워크 차단(IP 규칙, Private Endpoint, 네트워크 보안 그룹(NSG)), 리소스 정지 | 네트워크 설정과 DNS 해석 확인 |
| 404 | 대상 없음 | 엔드포인트 URL, 배포 이름, API 버전 오류 | 경로와 배포 이름 확인 |
| 429 | 요청 과다 | 분당 토큰 수(TPM)·분당 요청 수(RPM, Requests Per Minute) 할당량 초과, 일시적 용량 제한 | retry-after-ms 헤더만큼 기다린 뒤 재시도 |
| 500, 503 | 서버 오류 | 일시적인 서비스 문제 | 지수 백오프로 재시도, 지속되면 Service Health 확인 |
응답이 느릴 때 할당량을 원인으로 볼 수 있는 근거는 사실상 429뿐입니다. 429가 없다면 요청은 한도에 막히지 않고 모두 처리되고 있다는 뜻이고, 할당량을 늘려도 응답 시간은 달라지지 않습니다.
2. 운영 지표가 가리킨 것: 429는 0건, 응답 시간은 출력 길이를 따라갔다
이 플랫폼은 애플리케이션이 APIM 게이트웨이를 거쳐 모델 배포를 호출하는 구조이고, APIM 백엔드 풀은 한국 중부(주)와 미국 동부 2(대기)의 배포로 구성되어 있습니다. 분석 대상은 호출량이 가장 많고 응답이 느리다는 불만이 집중된 gpt-5.5 배포이며, 분석에는 호출 경로와 관계없이 모든 요청이 집계되는 Foundry 배포의 Azure Monitor 지표 2주치와 APIM 게이트웨이 로그를 기준으로 삼았습니다. 수치는 모두 반올림한 값입니다.
| 항목 | 값 | 해석 |
|---|---|---|
| HTTP 429 (할당량 초과) | 0건 | 한도에 막힌 요청은 없음 |
| 분당 토큰 피크 / 배포 한도 | 약 64% | 피크에도 한도에 여유가 있음 |
| 요청당 평균 입력 / 출력 토큰 | 약 5,000 / 2,300 | 출력이 긴 워크로드 |
| 평균 전체 응답 시간 (TTLT) | 약 26초 | 사용자가 느낀 “느림”의 실체 |
| 평균 첫 토큰 시간 (TTFT) | 약 1.4초 | 시작은 빠름 |
| 토큰 간 간격 (TBT) | 약 11.5ms (초당 약 87토큰) | 생성 속도 자체는 정상 범위 |
숫자를 나란히 놓고 보면, 응답은 1.4초 만에 시작되는데 끝나기까지 26초가 걸린다는 점이 눈에 띕니다. 시작이 아니라 “말하는 시간”이 길다는 뜻입니다. 시간대별로 묶어 상관을 보면 이 그림이 더 분명해집니다.
| 비교 | 상관계수 |
|---|---|
| 요청당 출력 토큰 ↔ TTLT | 0.91 |
| 요청량 ↔ TTLT | 0.42 |
| 요청량 ↔ TBT | 0.10 |
대기열 가설이 맞다면 요청이 몰리는 시간대에 생성 속도(TBT)가 눈에 띄게 느려졌어야 합니다. 그런데 요청량과 TBT는 거의 무관했고, 응답 시간은 출력 길이를 따라 움직였습니다. 계산으로도 확인됩니다. 1.4초 + 11.5ms × 2,300토큰 ≈ 28초로, 관측된 평균 26초와 거의 같습니다.
이 계산은 Microsoft 공식 문서가 제시하는 지연 공식을 그대로 적용한 것입니다.
TTLT = TTFT + (TBT × 생성 토큰 수)
— Performance and latency (Microsoft Learn)
같은 문서는 “TTLT와 생성 토큰 수가 함께 늘었다면 성능 저하가 아니라 예상된 동작”이라고 안내합니다. 그렇다면 리전을 추가해도, 할당량을 늘려도 평균 응답 시간은 줄어들지 않습니다. 이 결론을 권고안으로 내기 전에, 변수를 하나씩 통제할 수 있는 환경에서 같은 현상이 재현되는지 검증할 필요가 있었습니다.
3. 재현 환경
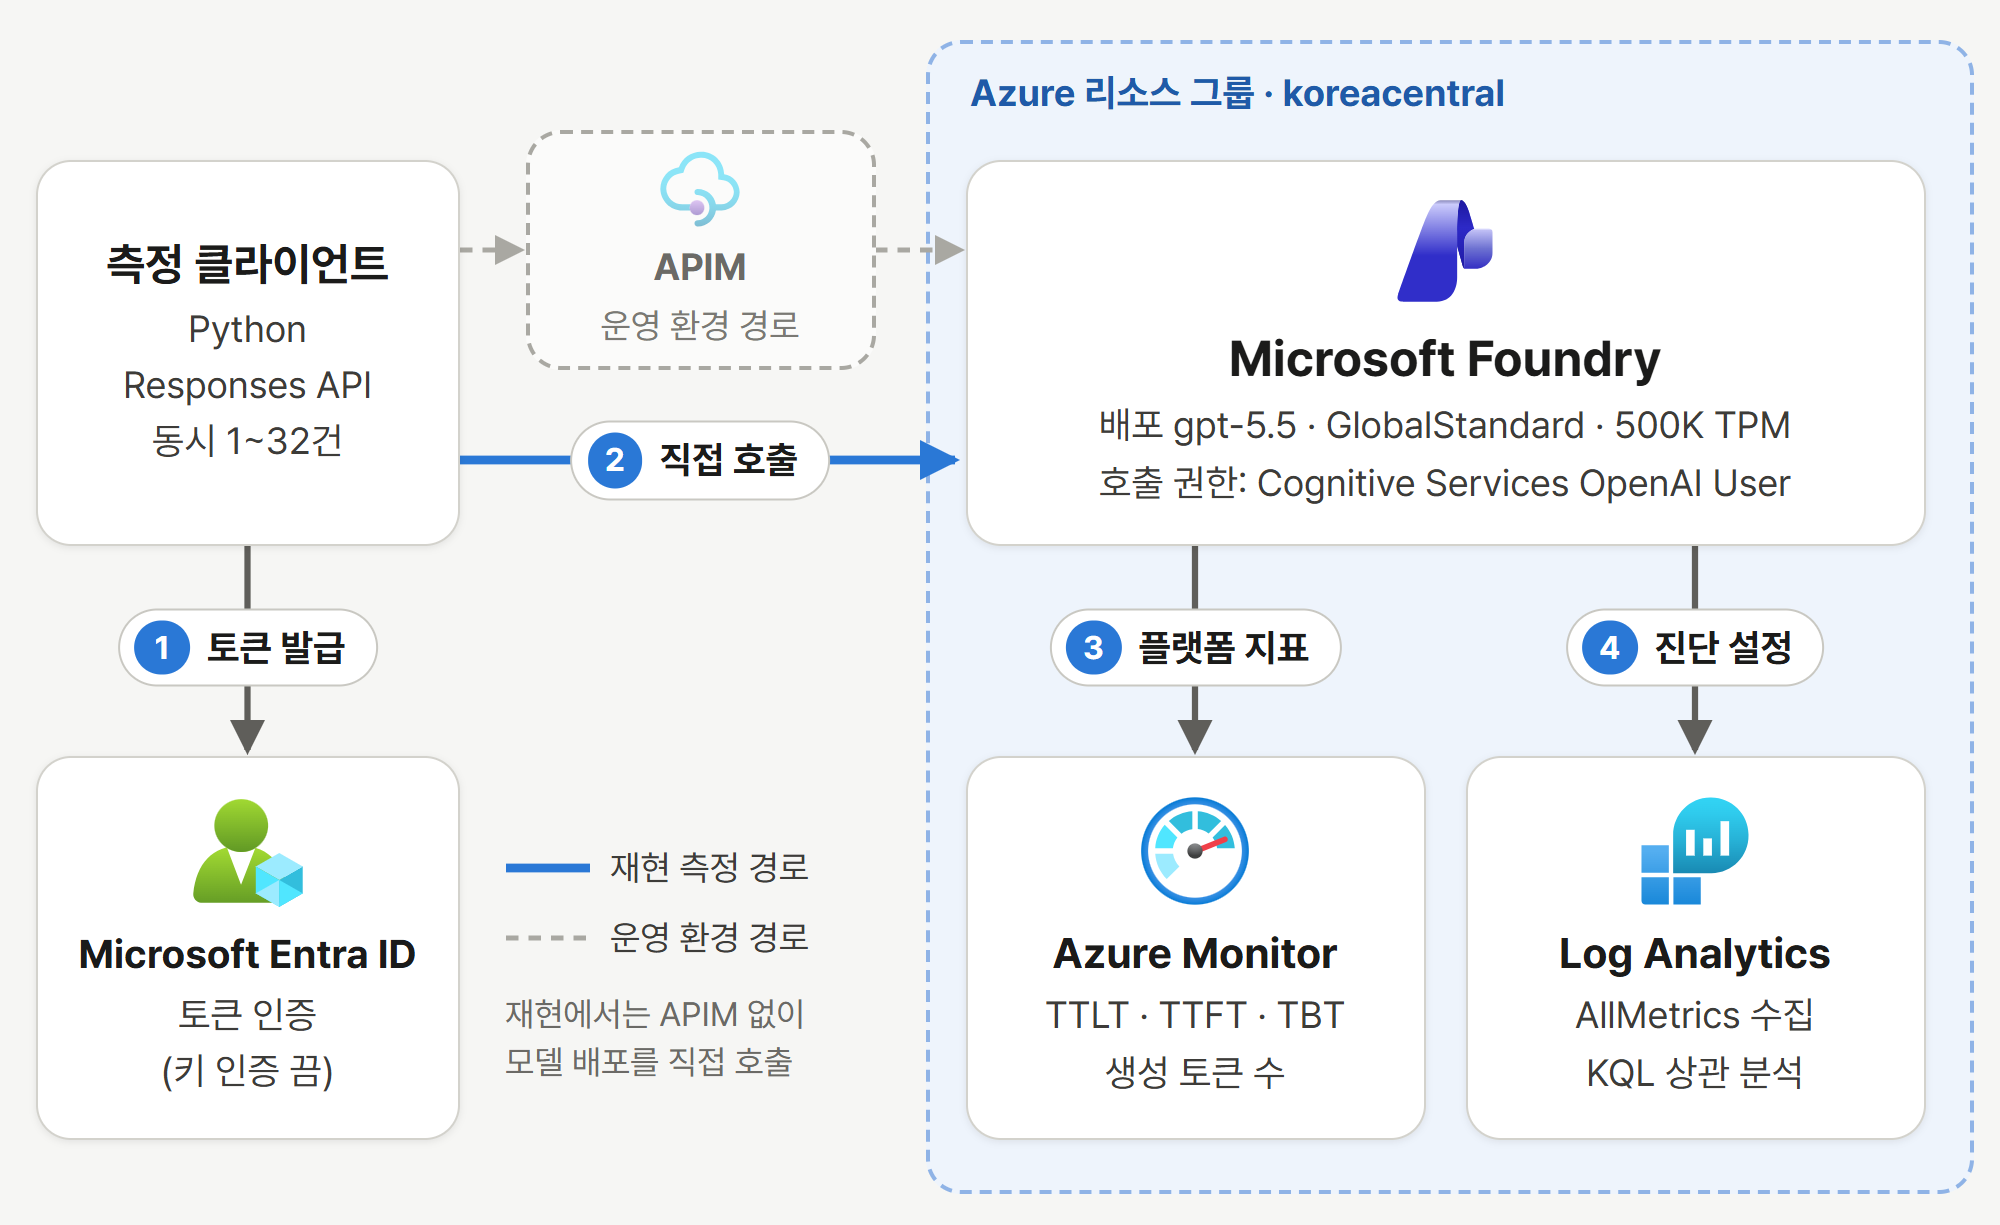
운영에서 지연은 모델 배포 구간의 지표(TTLT)만으로 설명됐고, 게이트웨이 구간이 전체 응답 시간에서 차지하는 비중은 작았습니다. 그래서 재현 환경은 APIM을 제외하고 모델 배포 자체의 특성만 볼 수 있도록 구성을 최소한으로 유지합니다. 그림에서 점선으로 표시한 APIM은 운영 환경의 호출 경로이며, 재현 측정에서는 거치지 않습니다.
| 구성 요소 | 설정 | 비고 |
|---|---|---|
| Microsoft Foundry (AIServices) | koreacentral, 키 인증 끔(disableLocalAuth=true) |
Entra ID 토큰으로만 호출 |
| 모델 배포 | gpt-5.5 (2026-04-24), GlobalStandard, capacity 500 | 500K TPM / 500 RPM |
| 권한 | 측정 계정에 Cognitive Services OpenAI User (계정 범위) |
호출만 가능한 최소 권한 |
| 진단 설정 | AllMetrics → Log Analytics | 지표를 KQL로 분석 |
| 측정 클라이언트 | Python, Responses API, stream=true |
시점을 클라이언트에서 직접 측정 |
재현 환경은 편의상 공용 엔드포인트를 쓰지만, 운영 환경이라면 Private Endpoint와 Private DNS Zone 구성을 권장합니다.
전체 구성은 Azure CLI로 다음과 같이 만들 수 있습니다.
SUB="<구독>"; LOC="koreacentral"
RG="rg-llm-latency-lab"; LAW="law-llm-latency-lab"; AIF="aif-llm-latency-lab"

# 0) 배포할 모델의 GlobalStandard 쿼터 잔여량 확인
az cognitiveservices usage list --subscription "$SUB" -l "$LOC" \
  --query "[?name.value=='OpenAI.GlobalStandard.gpt-5.5'].{used:currentValue,limit:limit}" -o table

# 1) 리소스 그룹, Log Analytics
az group create --subscription "$SUB" -n "$RG" -l "$LOC"
az monitor log-analytics workspace create --subscription "$SUB" -g "$RG" -n "$LAW" -l "$LOC"

# 2) Foundry 계정 + 키 인증 끄기
az cognitiveservices account create --subscription "$SUB" -g "$RG" -n "$AIF" -l "$LOC" \
  --kind AIServices --sku S0 --custom-domain "$AIF" --yes
AIF_ID=$(az cognitiveservices account show --subscription "$SUB" -g "$RG" -n "$AIF" --query id -o tsv)
az resource update --ids "$AIF_ID" --set properties.disableLocalAuth=true

# 3) 모델 배포 (capacity 1 = 1,000 TPM)
az cognitiveservices account deployment create --subscription "$SUB" -g "$RG" -n "$AIF" \
  --deployment-name gpt-5.5 --model-format OpenAI --model-name gpt-5.5 --model-version 2026-04-24 \
  --sku-name GlobalStandard --sku-capacity 500

# 4) 최소 권한 역할 (계정 범위)
ME=$(az ad signed-in-user show --query id -o tsv)
az role assignment create --assignee-object-id "$ME" --assignee-principal-type User \
  --role "Cognitive Services OpenAI User" --scope "$AIF_ID"

# 5) 진단 설정
LAW_ID=$(az monitor log-analytics workspace show --subscription "$SUB" -g "$RG" -n "$LAW" --query id -o tsv)
az monitor diagnostic-settings create --name diag-to-law --resource "$AIF_ID" --workspace "$LAW_ID" \
  --metrics '[{"category":"AllMetrics","enabled":true}]'
배포 결과의 일부입니다. capacity 500이 분당 요청 500건, 분당 토큰 50만 개 한도로 적용된 것을 확인할 수 있습니다.
{
  "sku": { "name": "GlobalStandard", "capacity": 500 },
  "properties": {
    "model": { "format": "OpenAI", "name": "gpt-5.5", "version": "2026-04-24" },
    "raiPolicyName": "Microsoft.DefaultV2",
    "rateLimits": [
      { "key": "request", "renewalPeriod": 60.0, "count": 500.0 },
      { "key": "token",   "renewalPeriod": 60.0, "count": 500000.0 }
    ]
  }
}
4. 측정 방법
응답 시간을 원인별로 나누려면 요청 하나 안에서 여러 시점을 따로 잡아야 합니다. 그래서 서버 전송 이벤트(SSE, Server-Sent Events), 즉 응답을 조금씩 흘려보내는 스트리밍 방식으로 응답을 받으면서 요청마다 네 가지 값을 기록합니다.
| 측정값 | 정의 | Azure Monitor 대응 지표 |
|---|---|---|
| TTFT | 요청 시작 → 첫 스트리밍 이벤트 | Time to Response (AzureOpenAITimeToResponse) |
| 첫 답변 글자 | 요청 시작 → 첫 response.output_text.delta |
(없음, 클라이언트에서만 측정 가능) |
| TTLT | 요청 시작 → 응답 완료 | Time to Last Byte (AzureOpenAITTLTInMS) |
| 토큰 수 | 응답 usage의 입력·출력·추론·캐시 토큰 |
Generated Completion Tokens, Processed Prompt Tokens |
“첫 답변 글자”를 따로 잰 데는 이유가 있습니다. 추론(reasoning) 모델은 화면에 보이지 않는 추론 토큰을 먼저 만들기 때문에, 첫 이벤트는 빨리 도착해도 사용자가 보는 첫 글자는 한참 뒤에 나올 수 있습니다.
측정 코드의 핵심 부분입니다. 키 대신 Entra ID 토큰으로 인증하고, 이벤트 종류별로 시점을 남깁니다.
body = {"model": "gpt-5.5", "input": prompt, "max_output_tokens": max_out,
        "stream": True, "reasoning": {"effort": effort}}
headers = {"Authorization": f"Bearer {token}"}   # az account get-access-token --resource https://cognitiveservices.azure.com
t0 = time.perf_counter()
with requests.post(f"{ENDPOINT}/openai/v1/responses", headers=headers, json=body, stream=True) as r:
    for line in r.iter_lines(decode_unicode=True):
        if not line.startswith("data:"):
            continue
        now = (time.perf_counter() - t0) * 1000
        rec["ttft_ms"] = rec["ttft_ms"] or now                       # 첫 이벤트
        ev = json.loads(line[5:])
        if ev["type"] == "response.output_text.delta" and rec["ttfv_ms"] is None:
            rec["ttfv_ms"] = now                                       # 첫 답변 글자
        if ev["type"] in ("response.completed", "response.incomplete"):
            u = ev["response"]["usage"]                                # 입력·출력·추론·캐시 토큰
rec["ttlt_ms"] = (time.perf_counter() - t0) * 1000                     # 응답 완료
각 실험은 변수 하나만 바꾸고 나머지는 고정합니다.
| 실험 | 바꾼 것 | 고정한 것 |
|---|---|---|
| A. 출력 길이 | max_output_tokens 128 ~ 4,096 (수준별 5회) |
동시 1건, 추론 low |
| B. 동시 요청 수 | 동시 1 / 4 / 8 / 16 / 32건 | 출력 1,024토큰, 추론 low |
| C. 추론 강도 | reasoning.effort low / medium / high (각 5회) |
같은 질문, 동시 3건 |
| D. 입력 길이 | 입력 약 1K / 8K / 32K / 64K 토큰 (각 4회) | 출력 약 30토큰, 캐시 적중 차단 |
실험 A와 B의 응답은 max_output_tokens에 도달하면 끊기는(incomplete) 형태인데, 출력 길이를 정확히 맞추기 위한 의도된 설계입니다. 끊기기 전까지 토큰을 만드는 속도는 같으므로 생성 속도 측정에는 영향이 없습니다.
5. 실험 결과
5-1. 출력 길이: 응답 시간은 출력 토큰에 정비례한다
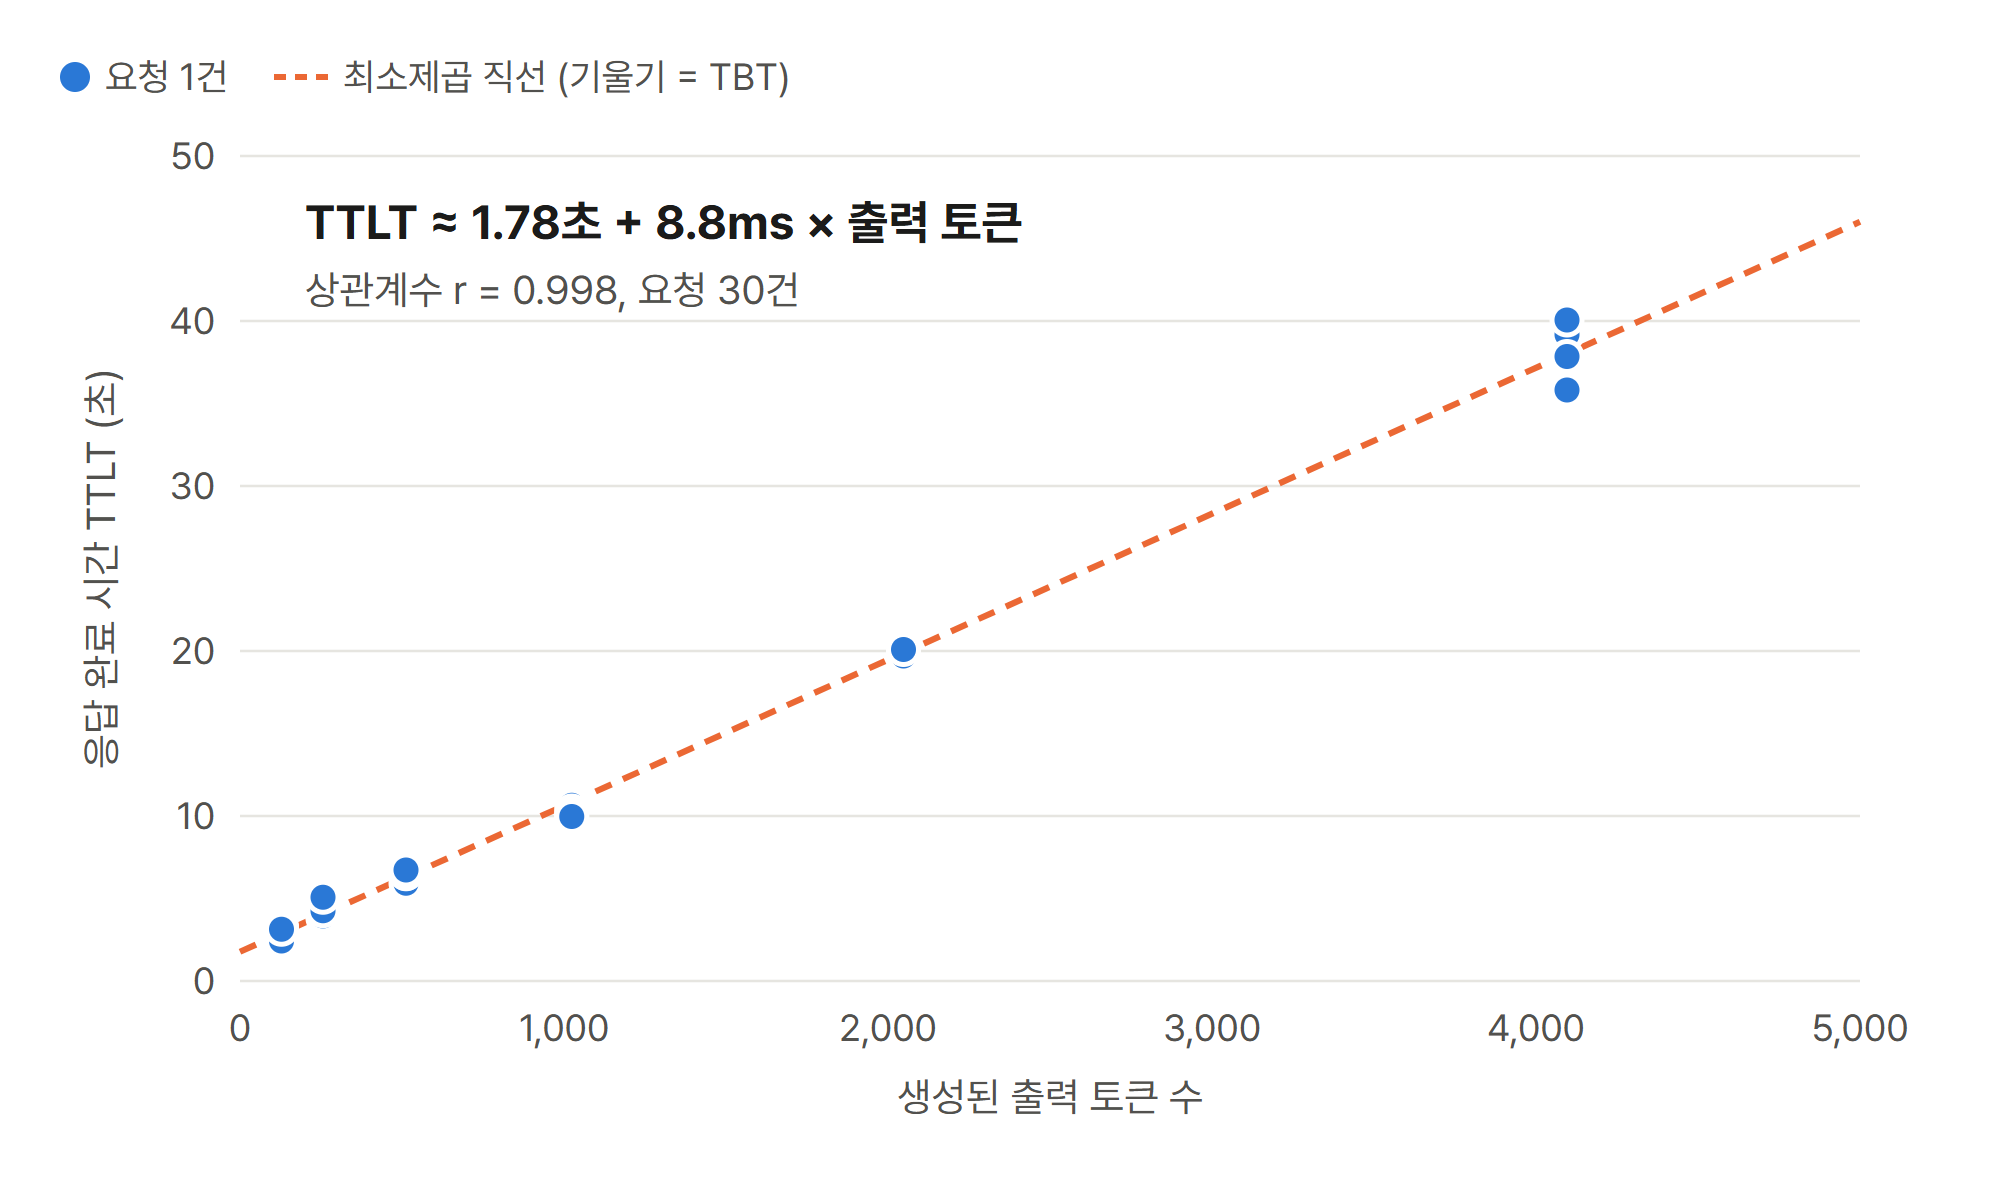
출력 상한을 128토큰에서 4,096토큰까지 늘려 가며 30건을 순서대로 호출하면, 점들이 거의 한 직선 위에 놓입니다.
- TTLT ≈ 1.78초 + 8.8ms × 출력 토큰, 상관계수 r = 0.998
- 기울기 8.8ms가 곧 TBT이고, 초당 약 113토큰을 생성한다는 뜻입니다.
- 절편 1.78초는 첫 이벤트까지의 시간(약 1.5초)에 low 추론 토큰 20~30개분(약 0.2초, 실험 A의 질문 기준)을 더한 값으로 볼 수 있습니다.
다른 조건이 모두 정상이어도 출력이 4,096토큰이면 응답에 약 38초가 걸리는 셈입니다. 운영에서 관측된 평균 26초도 같은 원리로 설명됩니다.
5-2. 동시 요청 수: 32배로 늘려도 응답 시간은 6%만 늘었다
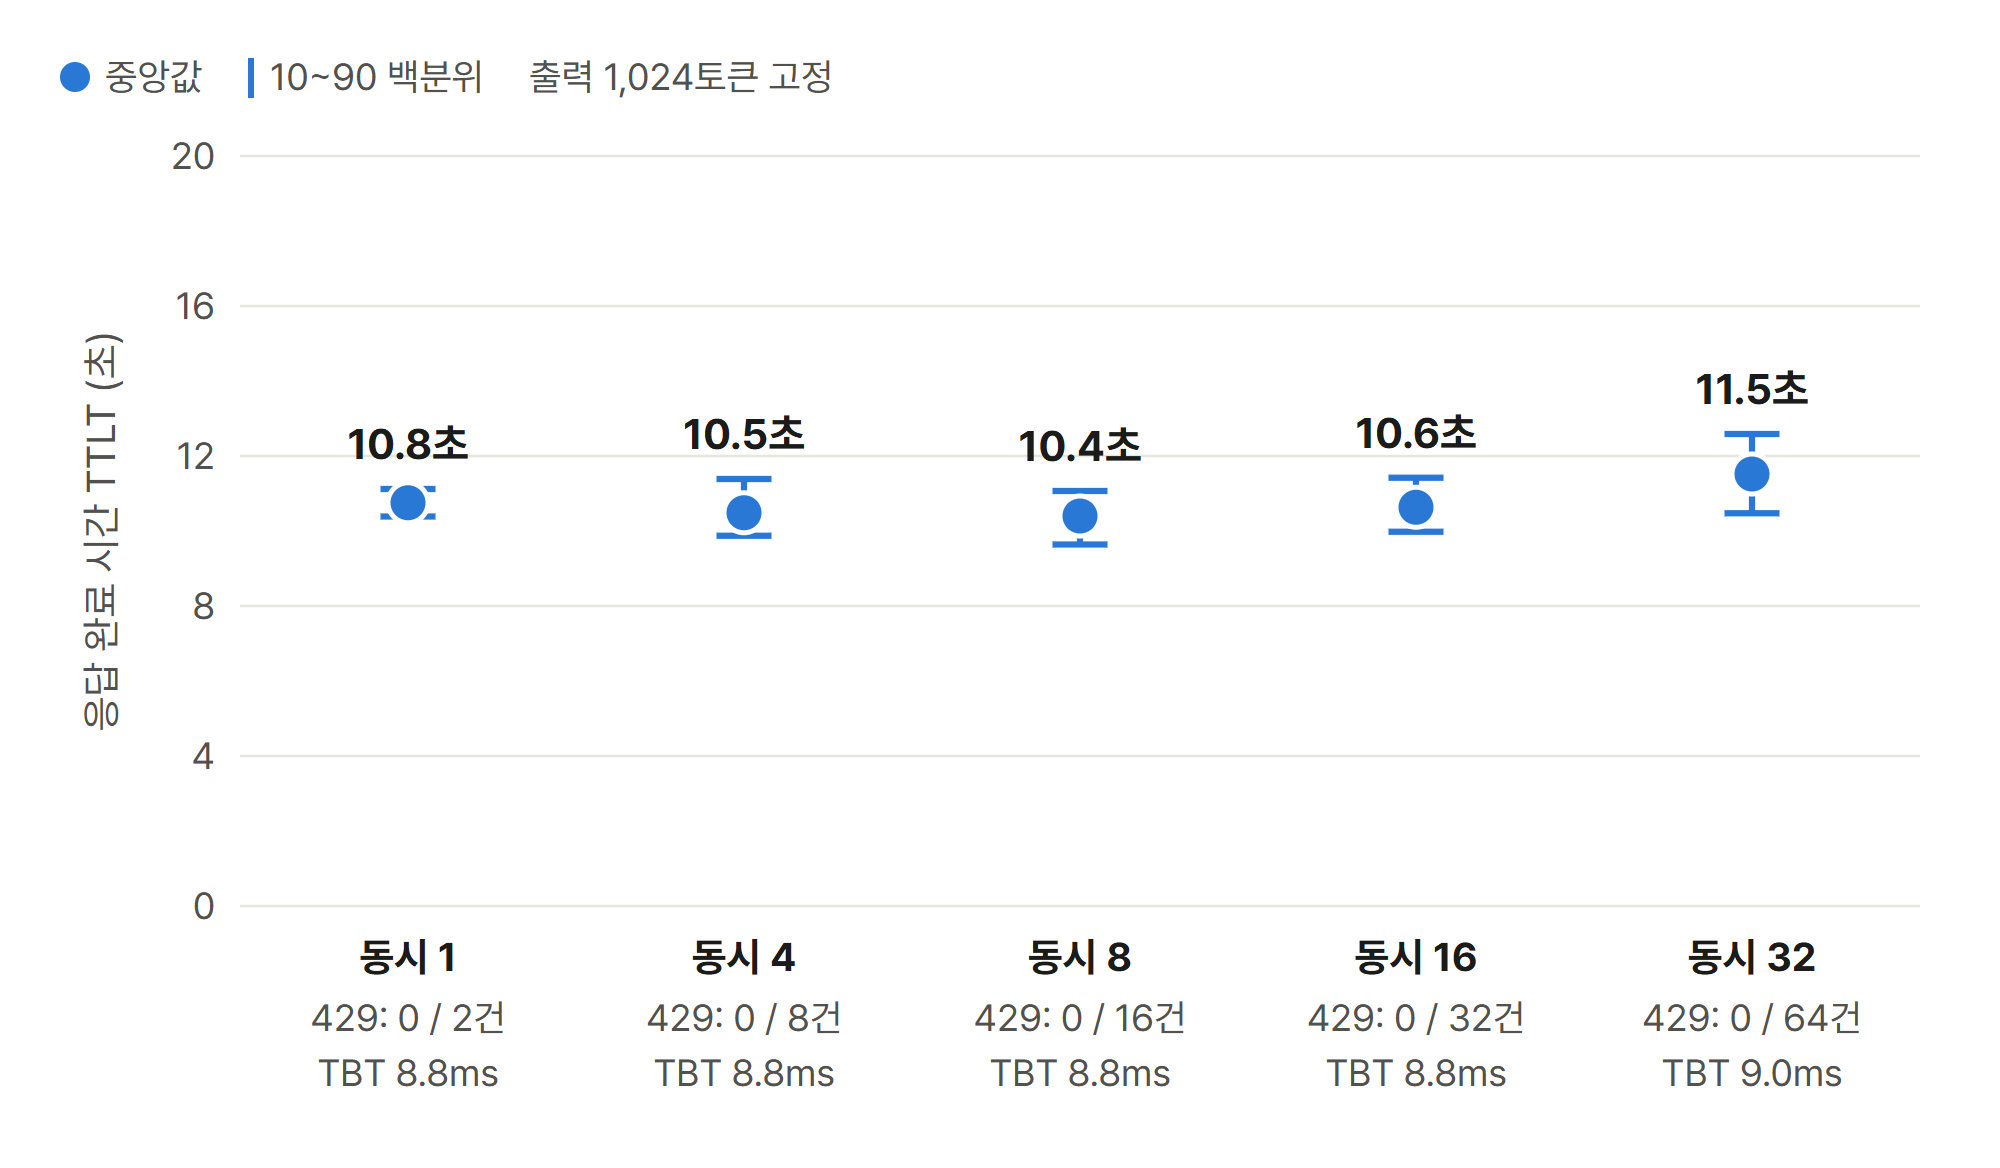
그렇다면 요청이 몰리면 어떻게 될까요? 출력을 1,024토큰으로 고정하고 동시 요청을 1건에서 32건까지 늘려 총 122건을 보냈습니다.
| 동시 요청 | 요청 수 | 429 | TTLT 중앙값 | TBT 중앙값 | TTFT 중앙값 |
|---|---|---|---|---|---|
| 1 | 2 | 0 | 10.8초 | 8.8ms | 1.75초 |
| 4 | 8 | 0 | 10.5초 | 8.8ms | 1.18초 |
| 8 | 16 | 0 | 10.4초 | 8.8ms | 1.33초 |
| 16 | 32 | 0 | 10.6초 | 8.8ms | 1.76초 |
| 32 | 64 | 0 | 11.5초 | 9.0ms | 2.33초 |
- 동시 요청을 32배로 늘리는 동안 응답 시간은 약 6% 늘어나는 데 그쳤고, 토큰을 만드는 속도(TBT)는 8.8ms 안팎에서 거의 움직이지 않았습니다.
- 32건 구간에서 첫 토큰이 2.3초로 다소 늦어지긴 했지만, 10초가 넘는 전체 응답 시간에 비하면 작은 차이입니다.
- 가장 붐빈 1분의 부하는 요청 78건, 생성 토큰 약 7만 개로 배포 한도(500 RPM, 500K TPM)의 약 15% 수준이었고, 429는 한 건도 발생하지 않았습니다.
배포 한도 안에서는 요청이 몰린다고 생성 속도가 떨어지는 “대기열” 현상이 나타나지 않았습니다. 운영 지표의 “요청량 ↔ TBT 상관 0.10″과 같은 결과입니다.
5-3. 추론 강도: 보이지 않는 토큰이 첫 글자를 늦춘다
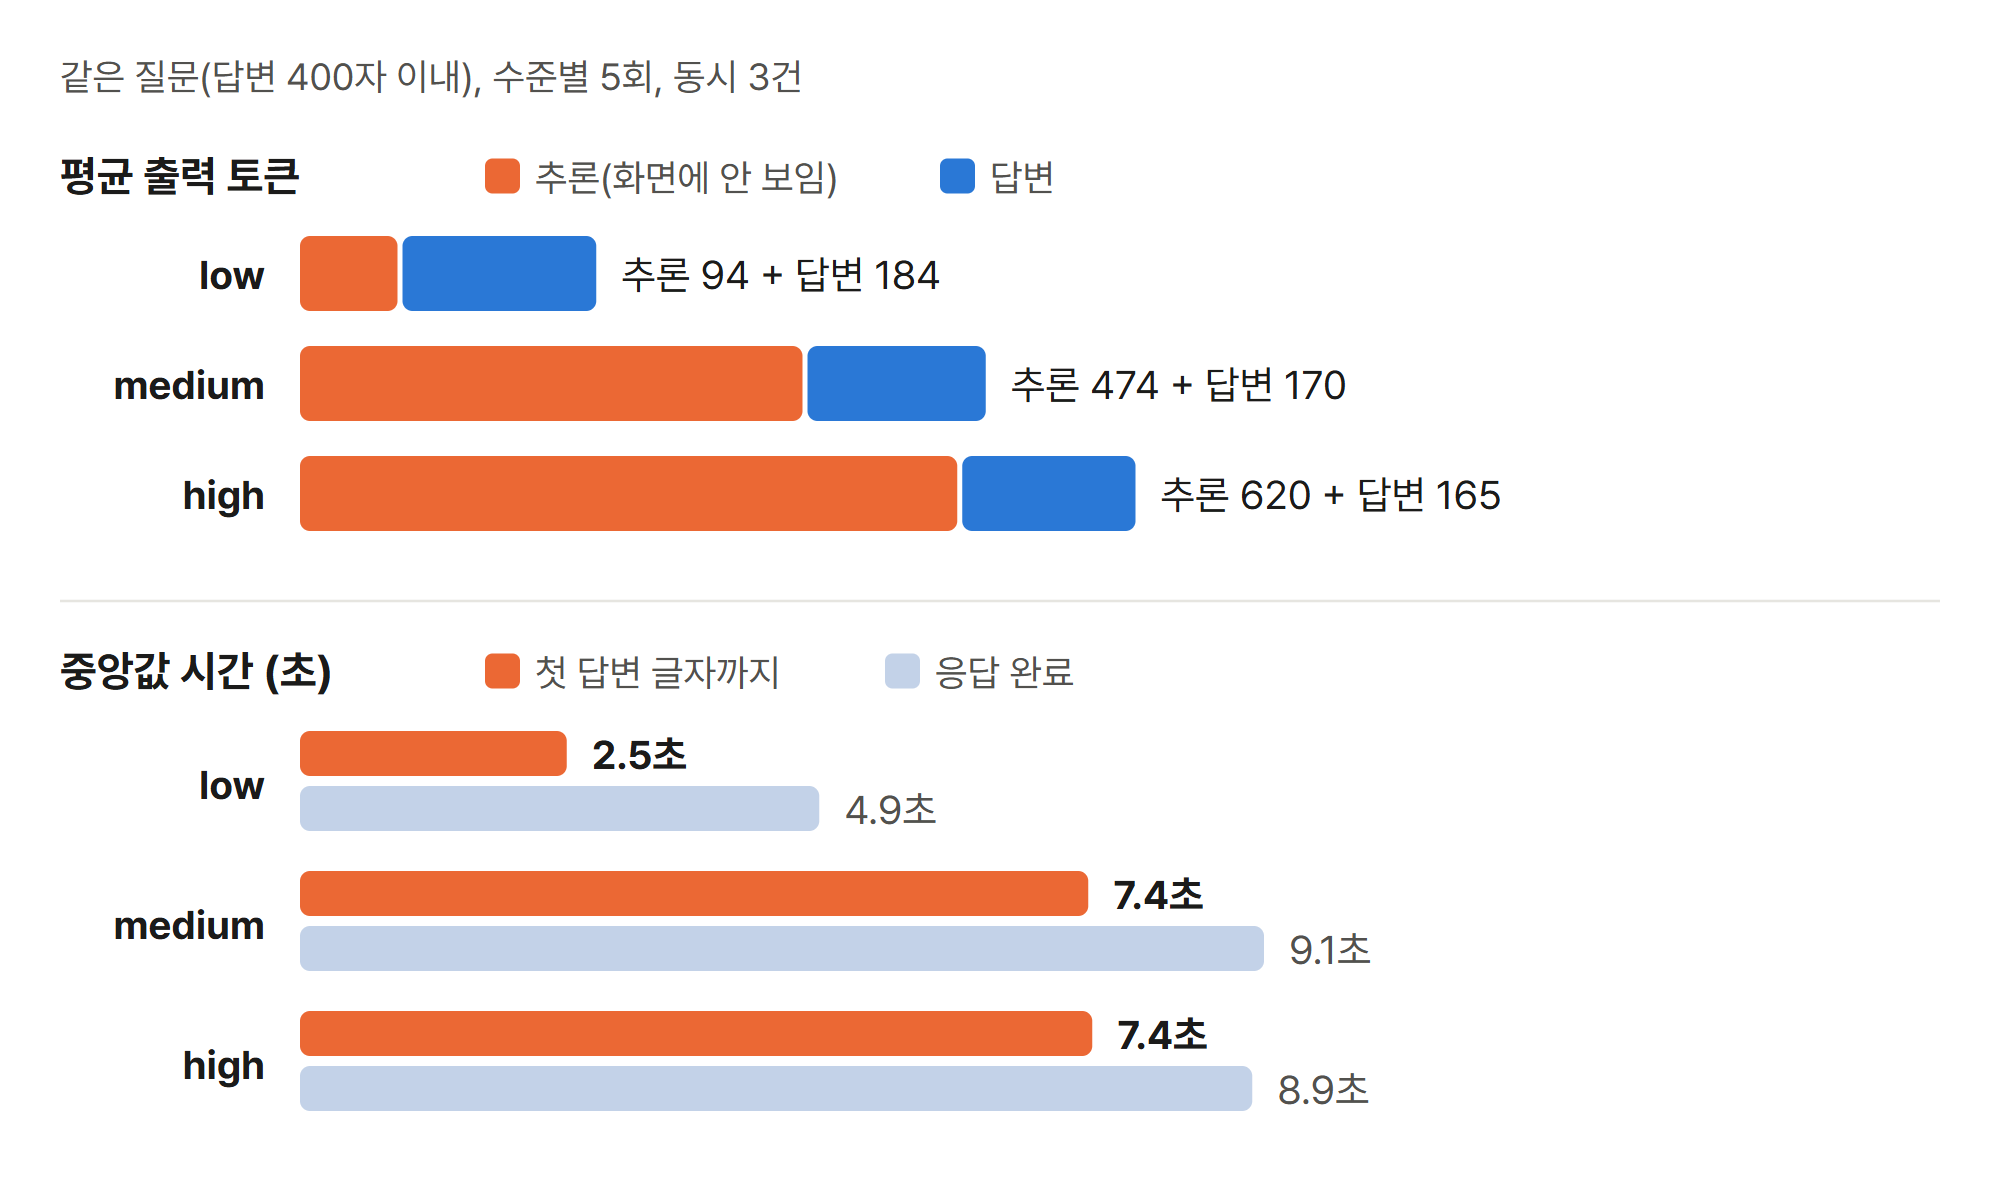
같은 설계 질문(“답변은 400자 이내”)을 추론 강도만 바꿔 보냈습니다.
| effort | 추론 토큰 (평균) | 답변 토큰 (평균) | 첫 답변 글자 | 응답 완료 |
|---|---|---|---|---|
| low | 94 | 184 | 2.5초 | 4.9초 |
| medium | 474 | 170 | 7.4초 | 9.1초 |
| high | 620 | 165 | 7.4초 | 8.9초 |
- 답변 길이는 거의 같은데, 추론 토큰이 5배로 늘면서 응답 완료 시간이 약 2배가 됐습니다.
- 첫 스트리밍 이벤트는 모든 수준에서 1.0~1.4초에 도착하지만, 사용자가 보는 첫 글자는 2.5초에서 7.4초로 늦어집니다. Time to Response 지표만 보면 “첫 응답은 빠른데 왜 느리다고 하지?”라는 착시가 생기는 지점입니다.
- 이 질문에서는 high의 추론량이 medium과 비슷했습니다. 추론량은 effort 설정뿐 아니라 질문의 난이도에 따라서도 달라집니다.
추론 모델에서 “출력 토큰”에는 화면에 보이지 않는 추론 토큰이 포함되며, Azure Monitor의 Generated Completion Tokens도 마찬가지입니다. 운영 환경에서 요청당 출력이 길게 나온다면 그중 추론 토큰이 얼마인지 응답의 usage.output_tokens_details.reasoning_tokens로 따로 확인해 보시길 권합니다. GPU를 직접 운영하는 자체 서빙 환경에서 같은 착시를 다룬 사례는 사내 블로그의 H200 도입 후 마주한 Timeout — Reasoning 모델의 TTFT 착시와 Thinking Budget에서 함께 보실 수 있습니다.
5-4. 입력 길이: 60배 늘려도 첫 토큰은 1초도 늦어지지 않는다
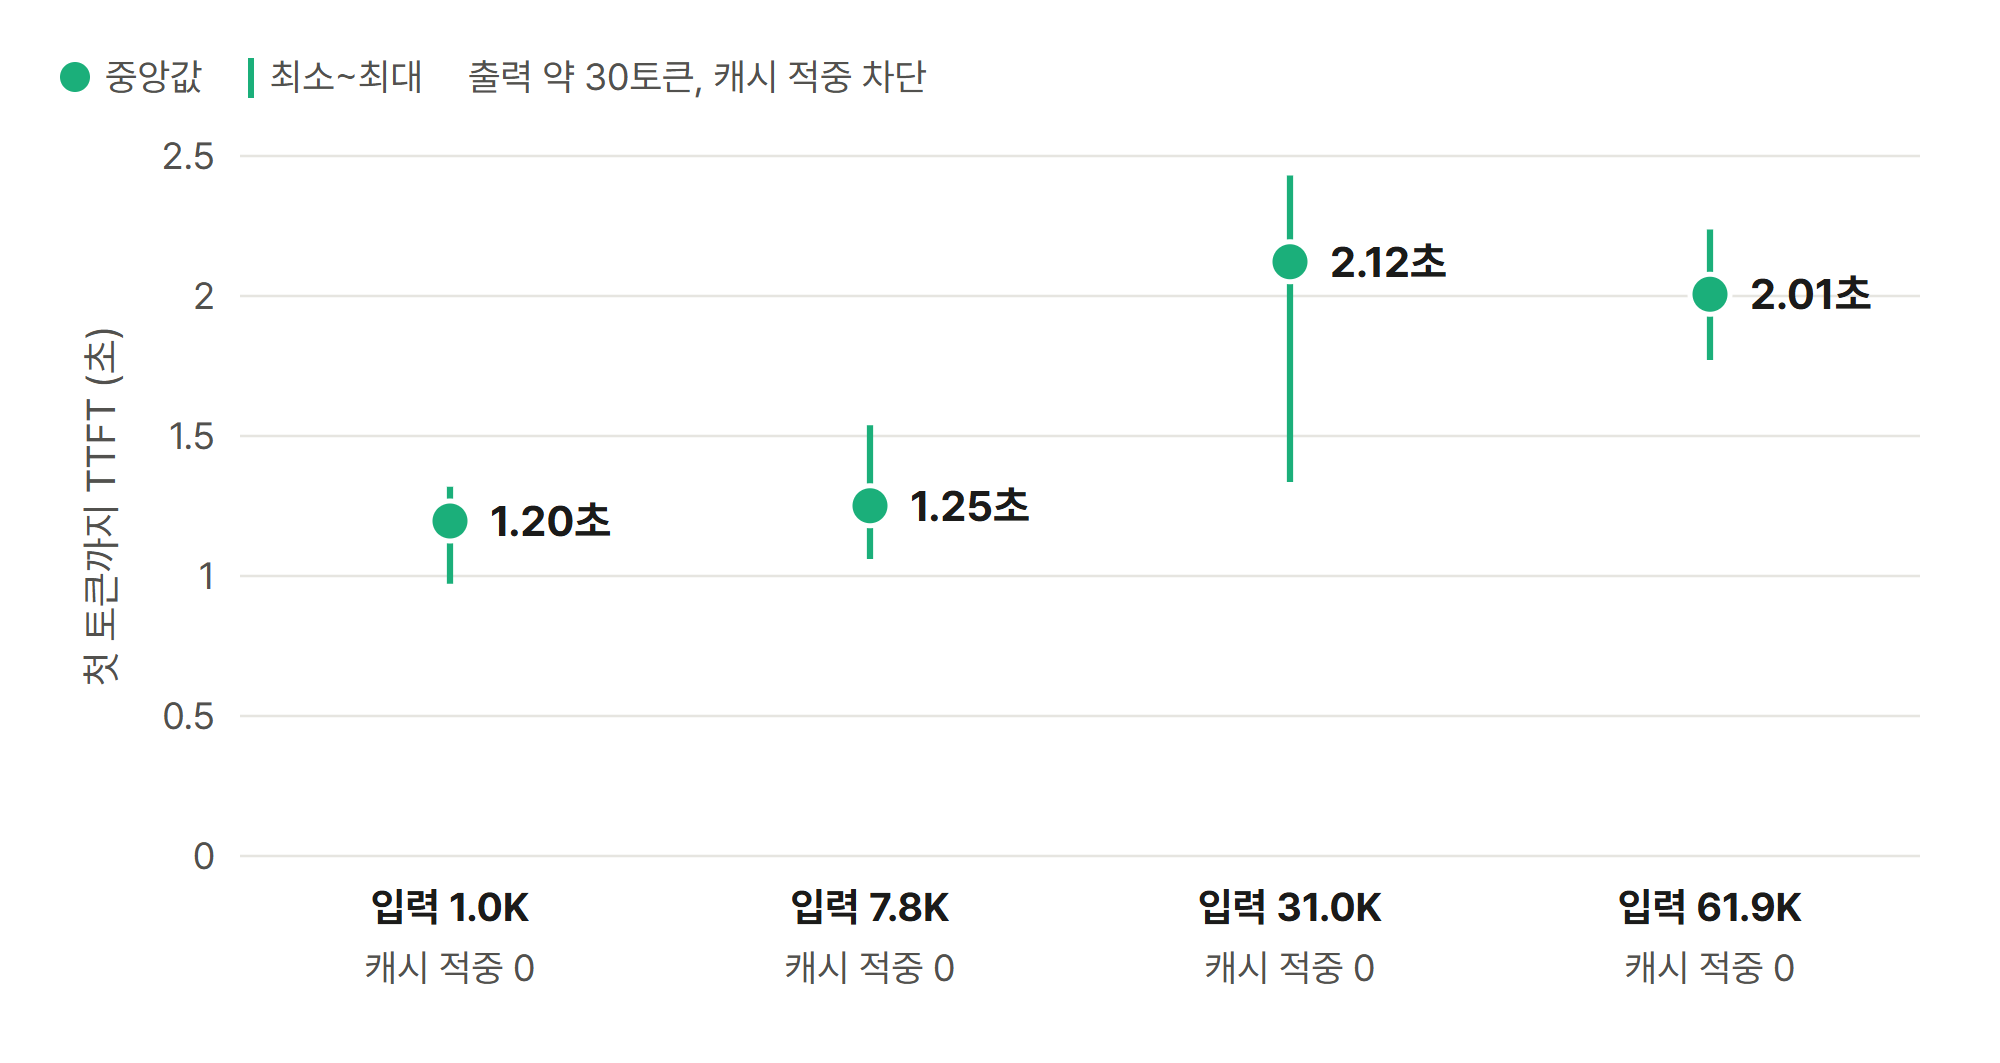
같은 프롬프트를 반복하면 프롬프트 캐시가 적중해 입력 길이의 영향이 가려질 수 있습니다. 그래서 요청마다 앞머리에 고유 문자열을 붙여 캐시를 차단하고, 응답의 cached_tokens가 0인 상태에서 측정한 결과입니다.
| 입력 토큰 | 약 1천 | 약 7.8천 | 약 3.1만 | 약 6.2만 |
|---|---|---|---|---|
| TTFT 중앙값 | 1.20초 | 1.25초 | 2.12초 | 2.01초 |
입력을 60배 늘려도 첫 토큰은 0.8초가량 늦어질 뿐입니다. 출력 1,000토큰이 약 9초를 더하는 것과 비교하면, 지연 관점에서는 입력보다 출력이 훨씬 비싸다는 것을 알 수 있습니다.
5-5. 공식으로 맞춰 보기
| 조건 | 공식 계산 (TTFT + TBT × 출력) | 실측 |
|---|---|---|
| 재현 환경, 출력 1,024토큰 | 1.78초 + 8.8ms × 1,024 = 10.8초 | 10.8초 (실험 B, 동시 1) |
| 운영 환경, 출력 약 2,300토큰 | 1.4초 + 11.5ms × 2,300 ≈ 28초 | 평균 약 26초 |
재현 환경에서 측정한 상수로 계산한 값이 실측과 일치하고, 운영 환경의 값도 같은 공식으로 설명됩니다.
6. 운영 환경에서는: Azure Monitor 지표만으로 같은 결론 내기
재현 환경에서는 클라이언트가 직접 시점을 쟀지만, 운영 중인 서비스마다 측정 코드를 심기는 어렵습니다. 운영에서 실제로 쓴 방법은 Azure Monitor 플랫폼 지표를 1분 단위로 받아 상관을 보는 것입니다. 별도 설정 없이 기본으로 수집되는 지표만으로 충분합니다.
공식 문서의 “10분 진단” 절차도 같은 방향입니다. Time to Last Byte와 Generated Completion Tokens를 한 차트에 그려 두 값이 함께 움직이면 토큰량으로 설명되는 정상 동작이고, 토큰은 그대로인데 TTLT만 오르면 용량 부족이나 429를 의심하라고 안내합니다(Evaluate your latency in 10 minutes).
재현 구간의 지표를 포털 메트릭 탐색기와 같은 구성으로 그려 보면 다음과 같습니다. 1분 단위 지표 세 개를 위아래로 놓았습니다.
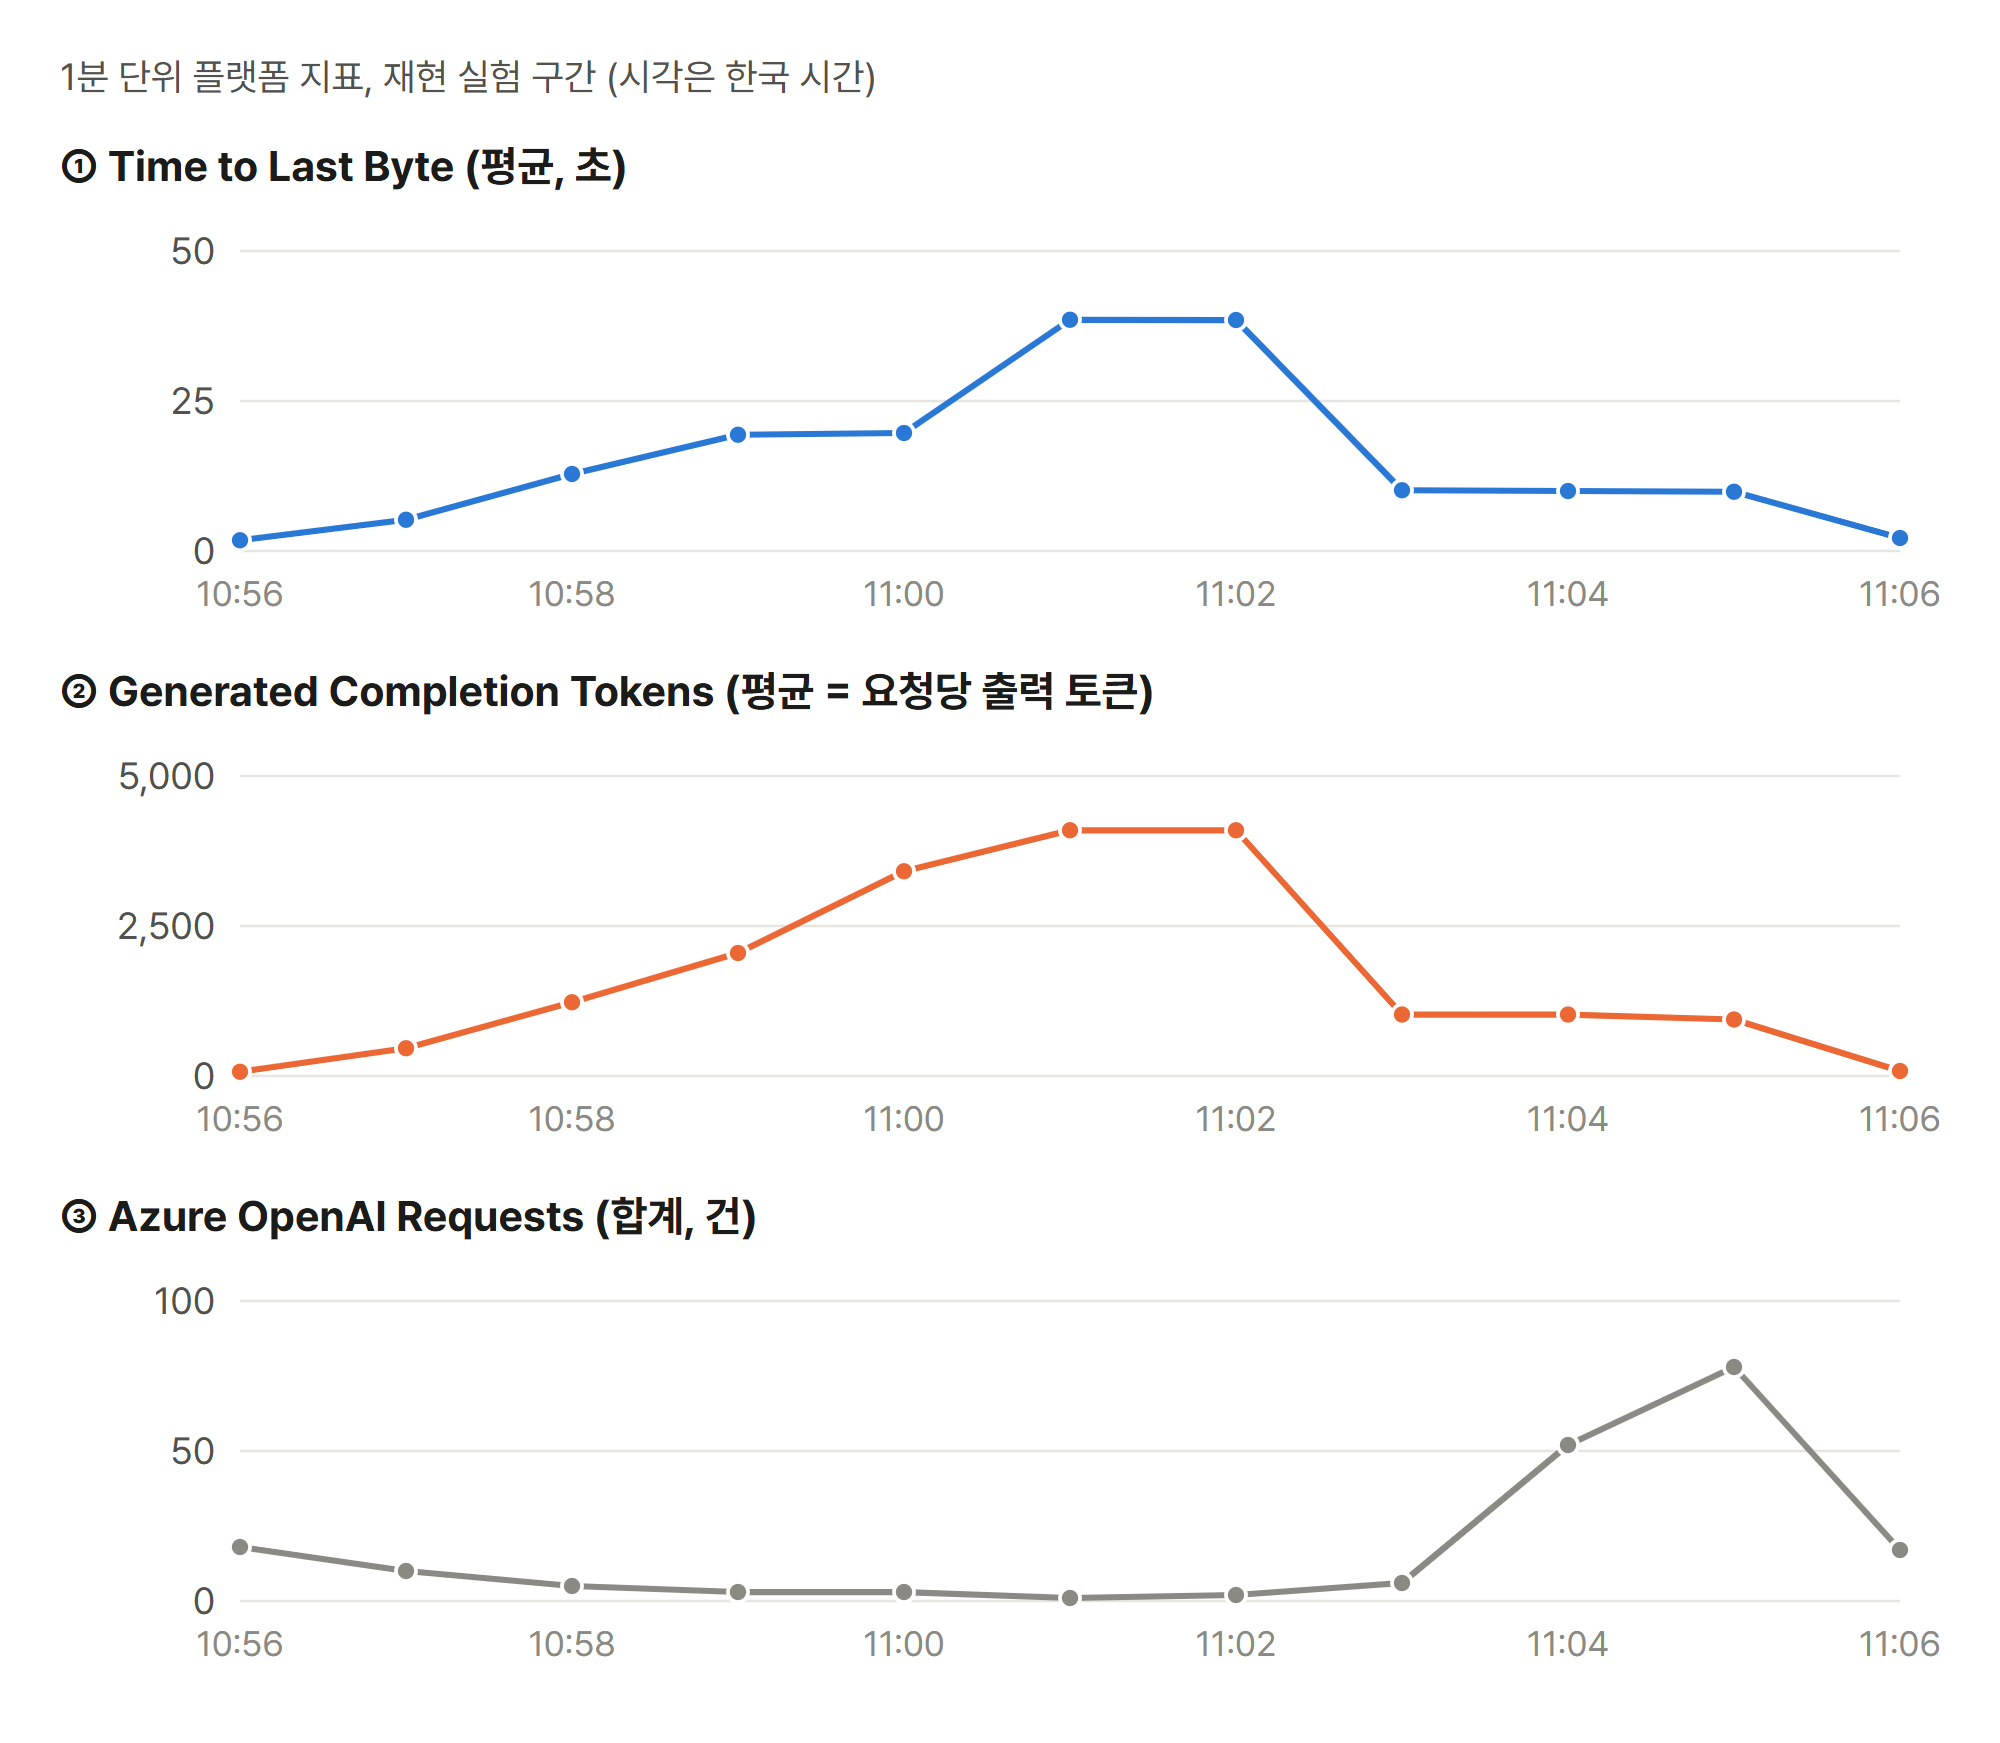
- ① 응답 시간(TTLT 평균)과 ② 요청당 출력 토큰(Generated Completion Tokens 평균)의 모양이 같습니다. 응답 시간이 출력 길이를 따라 움직인다는 뜻입니다.
- ③ 요청 수가 가장 많았던 구간(동시 32건)에서도 ① 응답 시간은 오르지 않았습니다.
팁: Generated Completion Tokens를 합계로 보면 요청 수에 비례해 커지므로 원인을 판단하기 어렵습니다. 평균으로 바꾸면 “요청당 출력 토큰”이 되어 TTLT와 바로 비교할 수 있습니다.
CLI로 지표 받기
RID=$(az cognitiveservices account show --subscription "$SUB" -g "$RG" -n "$AIF" --query id -o tsv)

# 1분 단위 요청 수, 생성 토큰, 평균 TTLT, 평균 TBT
for m in AzureOpenAIRequests:Total GeneratedTokens:Total \
         AzureOpenAITTLTInMS:Average AzureOpenAINormalizedTBTInMS:Average; do
  az monitor metrics list --subscription "$SUB" --resource "$RID" --metric "${m%%:*}" --aggregation "${m##*:}" \
    --interval PT1M --offset 3h -o tsv \
    --query "value[0].timeseries[0].data[].[timeStamp, $(echo ${m##*:} | tr A-Z a-z)]"
done
분마다 “생성 토큰 ÷ 요청 수”로 요청당 출력 길이를 만들고, TTLT·TBT와의 상관을 계산하면 됩니다. 재현 구간(1분 표본 11개)의 결과를 운영 지표와 나란히 놓아 보면 다음과 같습니다.
| 비교 | 운영 (2주) | 재현 환경 |
|---|---|---|
| 요청당 출력 토큰 ↔ TTLT | 0.91 | 0.96 |
| 요청 수 ↔ TTLT | 0.42 | −0.38 |
| 요청 수 ↔ TBT | 0.10 | 0.41 (TBT 범위 8.5~9.8ms) |
두 환경 모두 응답 시간은 출력 길이와 가장 강하게 움직였습니다. 재현 환경의 “요청 수 ↔ TBT”는 0.41로 나왔지만 TBT 자체가 8.5~9.8ms라는 좁은 폭 안에서만 움직였습니다. 상관계수는 값의 변동 폭과 함께 읽어야 한다는 좋은 예입니다.
지표 이름 주의
포털 표시 이름과 API 이름이 다르고, 이름이 비슷한 레거시 지표도 있어 헷갈리기 쉽습니다.
| 포털 표시 이름 | API 이름 | 비고 |
|---|---|---|
| Time to Last Byte | AzureOpenAITTLTInMS |
응답 완료까지 (TTLT) |
| Time to Response | AzureOpenAITimeToResponse |
첫 응답까지 (TTFT) |
| Time Between Tokens | AzureOpenAINormalizedTBTInMS |
토큰 사이 간격 (TBT) |
| Generated Completion Tokens | GeneratedTokens |
출력 토큰 (추론 토큰 포함) |
| Latency | Latency |
레거시, Azure OpenAI 진단에는 쓰지 않음 |
공식 문서 일부에는 “Time to Response와 Time Between Tokens는 Standard 배포에서 제공되지 않는다”는 문구가 남아 있습니다. 이번 GlobalStandard 배포에서는 두 지표 모두 값이 수집됐고, 지표의 TBT(약 9ms)도 클라이언트 실측(8.8ms)과 거의 같았습니다. 배포 유형에 따라 다를 수 있으니 사용 중인 배포에서 직접 확인해 보시길 권합니다.
KQL로 보기 (진단 설정을 켠 경우)
진단 설정에서 AllMetrics를 Log Analytics로 보내면 같은 지표를 KQL로 다룰 수 있습니다.
AzureMetrics
| where ResourceProvider == "MICROSOFT.COGNITIVESERVICES" and TimeGrain == "PT1M"
| where MetricName in ("AzureOpenAIRequests", "GeneratedTokens", "AzureOpenAITTLTInMS", "AzureOpenAINormalizedTBTInMS")
// 요청 수는 합계(Total), 나머지는 1분 평균(Average). GeneratedTokens의 Average = 요청당 출력 토큰
| extend v = iff(MetricName == "AzureOpenAIRequests", Total, Average)
| project TimeGenerated, MetricName, v
| evaluate pivot(MetricName, sum(v))
| project TimeGenerated,
          req            = AzureOpenAIRequests,
          tokens_per_req = round(GeneratedTokens, 0),
          ttlt_s         = round(AzureOpenAITTLTInMS / 1000, 1),
          tbt_ms         = round(AzureOpenAINormalizedTBTInMS, 1)
| where req > 0
| order by TimeGenerated asc
pivot전에 필요한 열만 남겨야 합니다.Total,Average같은 열이 남아 있으면 피벗 기준에 섞여 같은 분의 행이 하나로 합쳐지지 않습니다. 또 이 분석에는 진단 로그(AzureDiagnostics) 없이 AllMetrics만 있으면 충분합니다.
실행 결과의 일부입니다. 요청당 출력 토큰이 4배가 되면 TTLT도 4배 가까이 늘고, TBT는 9ms 안팎에서 거의 움직이지 않습니다.
| 분 | req | tokens_per_req | ttlt_s | tbt_ms |
|---|---|---|---|---|
| +3 | 5 | 1,229 | 12.8 | 8.5 |
| +4 | 3 | 2,048 | 19.4 | 8.8 |
| +6 | 1 | 4,096 | 38.5 | 9.2 |
| +9 | 52 | 1,024 | 10.0 | 8.8 |
| +10 | 78 | 941 | 9.9 | 9.8 |
7. 그래서 무엇을 해야 하나
지연이 출력 길이에서 온다면, 비용을 들이기 전에 출력부터 줄이는 것이 순서입니다. 권고안은 비용이 들지 않는 조치에서 시작합니다.
| 순서 | 대응 | 효과 | 비용 |
|---|---|---|---|
| 1 | 애플리케이션 최적화: 출력 형식 지정, max_output_tokens 상한, 추론 강도 조정, 스트리밍으로 체감 시간 단축 |
평균 응답 시간 직접 단축 | 없음 |
| 2 | 대화형과 배치 분리: 사용자 대면 요청과 대량 처리 요청을 다른 배포로 분리, 배치에는 Batch 또는 Flex 처리(Preview) | 대화형 요청이 배치에 밀리지 않음 | 배치 쪽은 오히려 절감 |
| 3 | Priority 처리: 배포 또는 요청 단위로 service_tier: priority |
꼬리 지연(가장 느린 상위 5% 요청, p95)과 변동 완화 | 출력 단가 약 2.5배 |
| 4 | PTU + Spillover: 상시 부하를 PTU(Provisioned Throughput Unit, 미리 확보해 두는 전용 처리 용량)로 처리하고, 한도를 넘는 요청은 Spillover(초과분 넘김) 기능으로 Standard 배포에 넘김 | 예측 가능한 처리량 | 시간당 고정비 |
리전 추가와 할당량 증설은 이 목록에 없습니다. 429가 0건인 상황에서는 한도를 늘려도, 이미 쓰고 있는 두 리전에 세 번째 리전을 더해도 평균 응답 시간이 달라지지 않기 때문입니다.
Priority 처리는 “빨라지는 옵션”으로 오해받기 쉬워 따로 짚어 둡니다. 공식 문서가 gpt-5.5에 제시하는 Priority 목표는 요청의 99%가 초당 50토큰 이상입니다(Priority processing). 그런데 Priority를 켜지 않은 재현 환경의 기본(Standard) 처리는 이미 초당 약 113토큰, 운영 환경도 초당 약 87토큰으로 생성하고 있었습니다. 즉 Priority는 평균 속도를 끌어올리는 기능이 아니라, 붐비는 시간대에도 생성 속도가 목표 아래로 떨어지지 않도록 바닥을 보장하는 기능입니다. 15분 안에 분당 토큰이 50% 넘게 급증하면 일부 요청이 Standard로 처리될 수 있다는 조건도 함께 고려해야 합니다.
8. 측정 범위와 해석 전제
- 할당량 이내 구간을 전제로 합니다. 사용량이 배포 한도에 가까워지면 429와 재시도 대기가 응답 시간에 더해지고, 그때는 할당량이 실제 원인이 됩니다. 증설을 검토할 때 가장 먼저 429부터 확인해야 하는 이유입니다.
- 부하 구간은 재현 환경 약 15%, 운영 환경 최대 64%입니다. 재현 환경에서 가장 붐빈 1분은 배포 한도의 약 15%였고, 운영 2주 데이터는 한도의 64%까지를 포함합니다. 두 구간 모두에서 요청량과 생성 속도(TBT)는 무관했습니다.
- 생성 속도의 절대값은 환경마다 다릅니다. GlobalStandard는 전 세계 용량에서 처리되기 때문에 TBT가 시간대와 워크로드에 따라 달라집니다(운영 초당 약 87토큰, 재현 환경 초당 약 113토큰). 공식의 구조는 같으므로, 사용 중인 환경의 TBT를 대입하면 예상 응답 시간을 계산할 수 있습니다.
- 측정 기준점이 다릅니다. 클라이언트 측정값에는 네트워크 왕복 시간이 포함되고, Azure Monitor 지표는 서비스 측 기준입니다. 그럼에도 두 TBT(약 9ms, 8.8ms)는 거의 일치했습니다.
마치며
처음 질문은 “대기열이 밀려서 느린 것 아닌가”였고, 답은 출력 길이였습니다. 정리하면 원칙은 세 가지입니다.
- 지연 숫자는 반드시 토큰 수와 짝지어 봅니다. TTLT만으로는 원인을 나눌 수 없습니다. Generated Completion Tokens를 평균으로 놓고 함께 보면 됩니다.
- 429가 없으면 할당량과 리전은 답이 아닙니다. 한도를 늘려도, 리전을 추가해도 생성 속도는 그대로입니다.
- 추론 모델은 “보이지 않는 출력”까지 계산에 넣습니다. 추론 토큰은 화면에 보이지 않지만 시간과 비용에는 그대로 반영됩니다.
비용이 드는 해법(Priority, PTU)은 그다음입니다. 출력 형식과 상한, 추론 강도를 먼저 손보는 것이 가장 저렴하면서도 효과가 큽니다.
참고 자료
- Performance and latency — Microsoft Learn
- Troubleshoot common HTTP errors for Azure OpenAI — Microsoft Learn
- Azure OpenAI monitoring data reference — Microsoft Learn
- Enable priority processing for Microsoft Foundry models — Microsoft Learn
- Use Flex processing with Azure OpenAI — Microsoft Learn
- What is Microsoft Foundry? — Microsoft Learn
- Azure OpenAI pricing
부록: 재현 환경과 비용
| 항목 | 값 |
|---|---|
| 리전 / 배포 유형 | koreacentral / GlobalStandard |
| 모델 | gpt-5.5 (2026-04-24), capacity 500 (500K TPM, 500 RPM) |
| API | Responses API (/openai/v1/responses), 스트리밍 |
| 인증 | Entra ID 토큰, 키 인증 끔, Cognitive Services OpenAI User (계정 범위) |
| 클라이언트 | Python 3.13, requests (SDK 없이 SSE 직접 파싱) |
| 총 호출 | 196건 (429 0건) |
| 총 토큰 | 입력 약 58만, 출력 약 17.5만 |
| 비용 | 약 8달러 (공시 단가: 입력 100만 토큰당 5달러, 출력 30달러) |
⚠ 정리 순서 주의: 모델 배포를 남긴 채 계정을 삭제하면, 그 배포가 쓰던 할당량이 48시간 동안 반환되지 않습니다. 계정은 삭제 후에도 보존(soft delete) 상태로 남기 때문에, 배포 삭제 → 리소스 그룹 삭제 → purge 순서로 정리해야 할당량과 사용자 지정 하위 도메인 이름을 바로 다시 쓸 수 있습니다(Manage Azure OpenAI quota — Resource deletion).
# 1) 배포 먼저 삭제 → 할당량 즉시 반환
az cognitiveservices account deployment delete --subscription "$SUB" -g "$RG" -n "$AIF" --deployment-name gpt-5.5
# 2) 리소스 그룹 삭제
az group delete --subscription "$SUB" -n "$RG" --yes
# 3) 보존 상태의 계정 purge → 이름 재사용 가능
az cognitiveservices account purge --subscription "$SUB" -g "$RG" -n "$AIF" -l "$LOC"