
컨테이너는 실행됐는데, 파이프라인은 왜 실패했을까?
#유전체분석 #NGS #AWSHealthOmics #클라우드이관
1. 들어가며
AWS HealthOmics는 유전체 등 생물학 데이터를 분석하는 워크플로우를 AWS에서 실행할 수 있도록 지원하는 완전관리형 서비스입니다. 분석 단계와 실행 조건을 정의하면, 분석에 필요한 컴퓨팅 환경을 직접 구축하고 관리하는 부담을 줄일 수 있습니다.
서비스가 처음이시라면 「Exploring AWS HealthOmics」를 먼저 참고해 주세요. HealthOmics의 주요 기능과 활용 분야를 살펴볼 수 있습니다.
이번 글에서는 온프레미스에서 운영하던 NGS(차세대 염기서열 분석) 파이프라인을 AWS HealthOmics로 이관하며 겪은 시행착오를 소개합니다. 유전체 분석이 낯설더라도, 여러 프로그램이 파일을 주고받으며 순서대로 실행되는 배치 작업을 옮긴다고 생각하면 접근하기가 한결 편합니다.
오랫동안 운영한 서버에는 문서에 적혀 있지 않은 설정이 많습니다. 특정 디렉터리에 설치된 도구, 이전 담당자가 만들어 둔 설정 파일, 스크립트 안에 남아 있는 절대 경로까지. 평소에는 잘 돌아가던 프로그램이 다른 서버로 옮겨지는 순간 이런 의존성이 하나씩 드러납니다.
유전체 분석 파이프라인도 크게 다르지 않았습니다.
분석 도구를 Docker 이미지로 만들고, Amazon ECR에 올리고, 워크플로우를 등록하는 흐름은 비교적 명확했습니다. 그런데 컨테이너 하나가 정상적으로 실행되는 것과 전체 분석이 끝까지 이어지는 것은 다른 문제였습니다.
앞 단계에서 만들어진 파일을 다음 단계가 찾지 못하거나, 로컬에서 잘 실행되던 스크립트가 컨테이너에서는 다른 경로를 바라보기도 했습니다. 결과 파일이 생성돼도 기존 환경과 수치가 달라 추가로 확인해야 하는 경우도 있었습니다.
이 글에서는 이러한 문제를 어떻게 확인하고, 실행 환경과 파일 전달 방식을 어떻게 정리했는지 살펴보겠습니다. 유전체 분석 프로젝트를 처음 맡는 AWS Solutions Architect나 클라우드 엔지니어에게도 참고가 될 수 있도록, 분석 알고리즘보다는 이관 과정의 기술적 판단에 초점을 맞췄습니다.
유전체 데이터 형식과 전체 아키텍처가 궁금하신 분은 「일반 AWS 엔지니어가 100만 샘플 하이브리드 파이프라인 아키텍처를 설계하는 방법」 함께 읽어보시면 좋습니다.
2. 파이프라인을 이해하기 위한 최소한의 용어
NGS는 Next Generation Sequencing의 약자로, 많은 DNA 또는 RNA 조각의 염기서열을 읽는 기술입니다. 클라우드 엔지니어 입장에서는 우선 대용량 파일을 입력 받아 여러 분석 단계를 거치고, 결과 파일을 생성하는 배치 작업으로 이해하면 접근하기가 편합니다.
| 용어 | 의미 | 이관할 때 확인할 부분 |
|---|---|---|
| FASTQ | 염기서열과 각 염기의 품질 정보를 담은 파일 | 입력 파일 크기, 압축 형식, R1·R2 파일의 짝 |
| Reference Genome | 읽어낸 서열을 비교할 기준이 되는 참조 유전체 | 참조 버전과 관련 인덱스 파일 |
| BAM | 읽어낸 서열을 참조 유전체에 정렬한 결과를 담는 파일 | 중간 파일 용량, 인덱스, 후속 작업과의 연결 |
| VCF | 검출된 변이 정보를 담은 파일 | 참조 유전체 버전, 필터 조건, 후속 주석 작업 |
| QC | 입력이나 분석 결과의 품질을 확인하는 과정 | 이관 전후 비교할 지표와 허용 범위 |
| Nextflow | 분석 단계와 파일 의존성을 정의하는 워크플로우 엔진 | 단계별 입력·출력, 컨테이너, 실행 자원 |
예를 들어 DNA 변이 분석은 다음과 같은 흐름으로 구성할 수 있습니다.
FASTQ 입력
   ↓
입력 데이터 품질 확인
   ↓
참조 유전체에 정렬
   ↓
BAM 가공 및 품질 확인
   ↓
변이 검출
   ↓
VCF 후처리 및 결과 정리
실제 순서와 도구는 분석 목적에 따라 달라집니다. 모든 NGS 분석이 동일한 흐름을 따르는 것은 아닙니다.
다만 이관 관점에서 공통적으로 중요한 점은 있습니다. 각 단계가 어떤 파일을 받아서 무엇을 만들어 내는지 알아야 한다는 것입니다. 도구 이름을 모두 외우는 것보다 이 연결 관계를 먼저 파악하는 편이 도움이 됐습니다.
3. AWS HealthOmics는 무엇을 대신해 주는가?
앞서 소개한 HealthOmics 기능 중 이번 이관에서 사용한 것은 자체 분석 파이프라인을 등록하고 실행하는 Private Workflows 입니다. 분석 단계와 파일 의존성을 Nextflow로 정의하고, 각 단계에서 사용할 컨테이너 이미지를 연결했습니다.
구성을 단순화하면 다음과 같습니다.
Amazon S3                     Amazon ECR
입력·참조 데이터               분석 도구·스크립트 이미지
       │                           │
       └──────────┬────────────────┘
                  ↓
       AWS HealthOmics Private Workflow
          Nextflow로 단계와 의존성 정의
                  ↓
           분석 작업(Task) 실행
                  ↓
       Amazon S3에 지정 결과 내보내기

       실행 상태·작업 로그 → CloudWatch
HealthOmics를 사용하면 워크플로우 실행에 필요한 컴퓨팅 자원과 실행 스토리지의 준비·해제를 직접 구성하고 관리하는 부담을 줄일 수 있습니다. 실행 중의 로그와 상태도 확인할 수 있습니다. 워크플로우 실행 수명 주기
그렇다고 기존 분석 프로그램의 의존성까지 자동으로 정리되는 것은 아닙니다.
컨테이너 안에 필요한 도구가 있는지, 입력 파일을 제대로 전달했는지, 출력 파일을 어디에 남길지, 분석 조건이 맞는지는 여전히 워크플로우를 만드는 쪽에서 정의해야 합니다.
HealthOmics는 분석 파이프라인을 실행할 기반을 제공하는 서비스입니다. 그 기반 위에서 기존 프로그램이 동작하도록 정리하는 일이 이관의 중심이었습니다.
4. 이관 과정: 서버에 있던 분석을 워크플로우로 정리하기
4.1 먼저 실행 명령보다 의존성을 정리했습니다
기존 서버에서는 실행 스크립트만 확인하면 될 것처럼 보였습니다. 하지만 스크립트를 따라가 보면 다른 스크립트를 호출하고, 설정 파일을 읽고, 특정 디렉터리의 참조 데이터를 사용하고 있었습니다.
그래서 각 단계에 대해 다음 내용을 확인했습니다.
- 실행하는 도구와 버전
- Python, Java 등 필요한 런타임
- 입력 파일과 참조 데이터
- 설정 파일 및 하드코딩된 경로
- 생성되는 중간 파일과 최종 파일
- 다음 단계가 기대하는 파일 이름과 위치
이 작업은 분석 담당자와 클라우드 담당자 사이의 공통 문서를 만드는 과정이기도 합니다.
“이 스크립트를 실행해 주세요”라는 요청만으로는 이관 범위를 판단하기 어렵습니다. 반면 “이 BAM과 인덱스를 입력 받아 통계 파일을 생성하며, 특정 참조 파일이 필요합니다”라고 정리하면 컨테이너, 스토리지, 권한, 실행 자원에 대한 논의가 가능해집니다.
4.2 분석 단계별로 컨테이너를 만들었습니다
정렬, 재보정, 통계, 변이 분석과 후처리 등 여러 단계를 나누어 Docker 이미지를 구성하고 ECR에 배포했습니다. 단계를 나누면 문제가 발생한 범위를 좁히기 쉽습니다. 통계 생성 단계의 수정 때문에 다른 분석 도구까지 함께 다시 구성할 필요도 줄어듭니다.
다만 나눌 수 있는 만큼 잘게 나누는 것이 항상 유리한 것은 아닙니다. 아주 짧은 작업을 과도하게 분리하면 작업 시작과 파일 전달에 드는 부담이 커질 수 있습니다. 처음에는 도구 의존성과 결과 확인이 쉬운 경계를 기준으로 나누고, 실행 기록이 쌓인 뒤 조정하는 편이 좋습니다.
로컬 Docker 테스트에서는 다음을 확인했습니다.
- 필요한 도구를 실행할 수 있는가?
- 실제 입력을 전달했을 때 결과가 생성되는가?
- 결과 파일 이름과 형식이 예상과 같은가?
- 작업이 실패하면 로그와 종료 코드로 확인할 수 있는가?
여기까지 통과해도 워크플로우 테스트는 별도로 필요했습니다. 컨테이너를 직접 실행하는 방식과 워크플로우 엔진이 컨테이너를 호출하는 방식에는 차이가 있었기 때문입니다.
4.3 파일 전달과 결과 보관을 구분했습니다
온프레미스에서는 여러 단계가 같은 파일 서버를 바라보는 구성이 자연스럽습니다. 앞 단계가 정해진 경로에 파일을 쓰면 다음 단계가 그 경로를 읽는 방식입니다.
워크플로우로 옮길 때는 이 관계를 더 명시적으로 정의해야 합니다.
Nextflow의 input과 output은 단계 사이에서 어떤 파일을 전달할지 표현합니다. 반면 publishDir는 외부로 보관할 결과를 내보내는 데 사용합니다. 다음 단계의 입력을 게시된 결과 경로에서 다시 찾도록 구성하면, 게시 시점이나 파일 이름에 의존하는 구조가 될 수 있습니다. 단계 간에는 선언된 출력을 연결하는 편이 명확합니다. Nextflow의 publishDir 설명
HealthOmics에서 publishDir를 사용하는 경우에는 /mnt/workflow/pubdir 아래에 내보낼 결과를 배치하는 방식이 안내되어 있습니다. 실제 S3 출력 위치는 실행 요청의 outputUri로 지정합니다. HealthOmics 작업 출력 문서
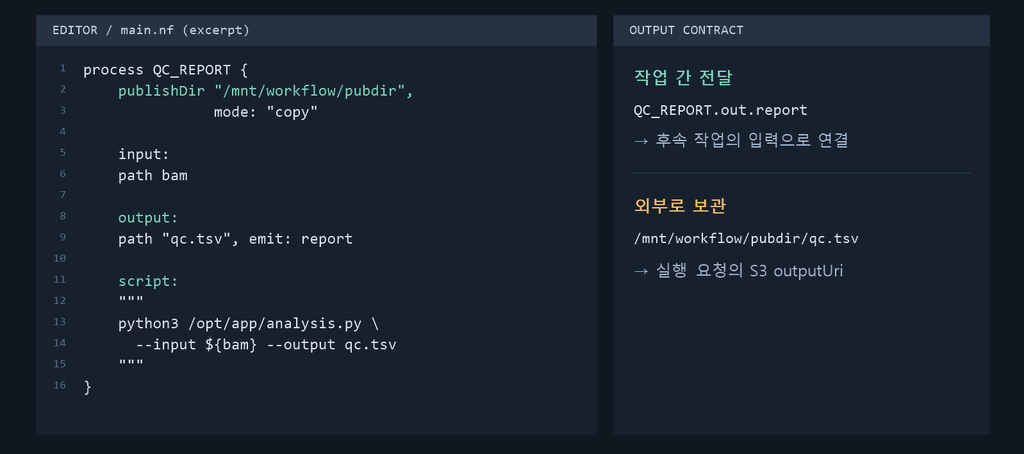
여기서 확인해야 할 질문은 두 가지입니다.
다음 단계가 사용할 파일인가?
실행이 끝난 뒤 사용자가 받을 파일인가?
이 둘을 구분하니 중간 파일의 전달 문제와 최종 결과의 누락 문제를 따로 추적할 수 있었습니다.
5. 실제로 막혔던 지점들
5.1 로컬에서 성공한 ENTRYPOINT가 워크플로우에서는 문제가 됐습니다
초기 컨테이너에는 분석 스크립트를 바로 실행하도록 ENTRYPOINT를 지정한 경우가 있었습니다.
직접 실행할 때는 편리했습니다. 이미지 뒤에 분석 인자를 붙이면 스크립트가 실행됐기 때문입니다.
하지만 HealthOmics의 워크플로우 엔진은 작업을 실행하기 위해 Bash 스크립트를 컨테이너 명령으로 전달합니다. 고정된 ENTRYPOINT가 있으면 엔진이 전달한 명령이 의도와 다르게 해석될 수 있습니다. AWS도 HealthOmics용 이미지는 지정된 ENTRYPOINT 없이 구성하도록 안내합니다. Private Workflows 컨테이너 문서
이관 과정에서는 ENTRYPOINT를 제거하고, 분석 스크립트를 실행하는 명령을 워크플로우 쪽에 명시하는 형태로 변경했습니다.
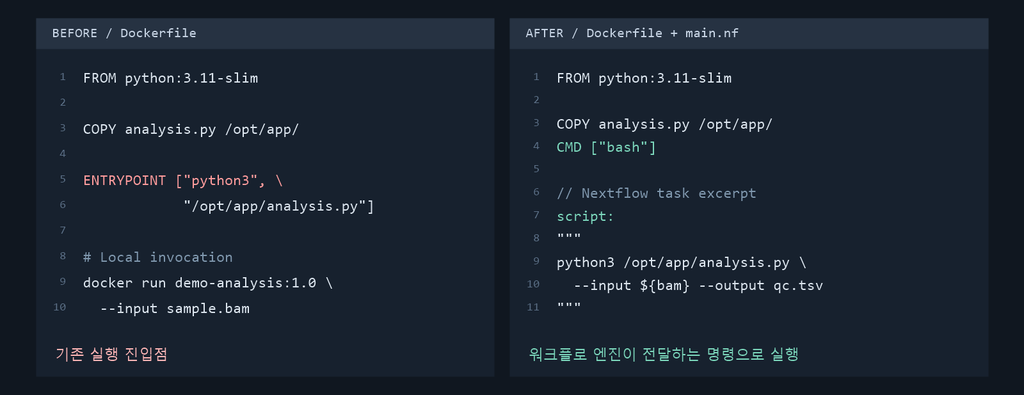
이 경험을 통해 컨테이너 테스트에서 “프로그램이 실행된다”는 사실만 확인해서는 부족하다는 것을 알게 됐습니다. 실제 실행 주체가 어떤 명령을 전달하는지까지 확인해야 했습니다.
5.2 스크립트가 기억하고 있던 서버 경로가 남아 있었습니다
또 다른 문제는 절대 경로였습니다.
메인 스크립트의 경로를 수정해도, 그 안에서 호출하는 하위 스크립트나 설정 파일에 기존 서버 경로가 남아 있으면 실행은 실패했습니다. 이관 기록에도 설정 경로를 수정하고, 하드코딩된 파일 위치를 설정으로 옮기는 작업이 반복해서 등장합니다.
정리 기준은 다음과 같이 잡을 수 있습니다.
| 구분 | 정리 방향 |
|---|---|
| 분석 도구·라이브러리·스크립트 | 컨테이너 안에서 관리 |
| 샘플 입력·참조 데이터 | 워크플로우 입력으로 명시 |
| 분석 조건 | 파라미터나 설정 파일로 전달 |
| 작업 중 생성되는 파일 | 작업 디렉터리에서 생성 |
| 보관할 결과 | 워크플로우 출력으로 선언하고 내보내기 |
기존 서버의 디렉터리 구조를 모두 그대로 재현하면 당장 실행하는 데 도움이 될 수는 있습니다. 하지만 오래 운영할 파이프라인이라면, 각 경로가 어떤 역할을 하는지부터 구분하는 것이 이후 수정과 장애 대응에 유리합니다.
5.3 오류가 난 위치와 원인이 시작된 위치가 달랐습니다
테스트 중에는 S3에서 중간 BAM 파일을 가져오다가 404 오류가 발생한 적이 있었습니다. 로그만 보면 S3에 파일이 없는 문제입니다.
그런데 요청한 객체 경로 자체가 예상과 달랐습니다. 샘플 식별자가 들어가야 할 위치에 shell 실행과 관련된 값이 섞여 있었습니다.
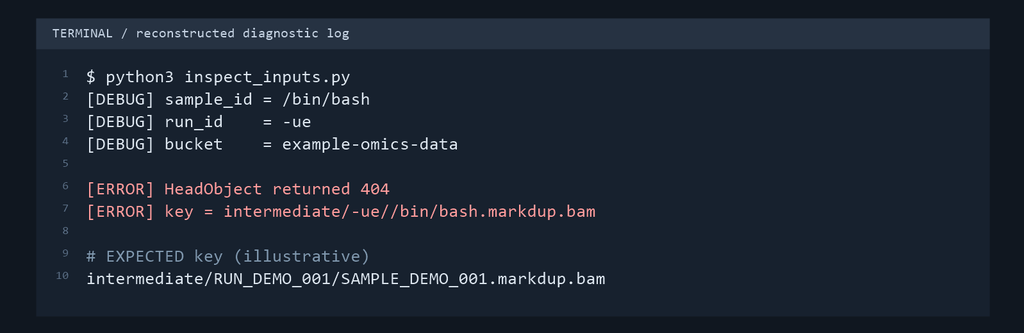
이런 상황에서 S3 권한을 먼저 넓혀도 잘못 만들어진 경로는 해결되지 않습니다. 확인 순서는 다음과 같아야 합니다.
- 실제 요청한 버킷과 객체 키가 무엇인가?
- 그 키를 조합한 인자는 무엇인가?
- 워크플로우와 컨테이너 사이에서 인자가 어떻게 전달됐는가?
- 앞 단계는 어떤 이름으로 파일을 만들었는가?
클라우드 서비스에서 오류가 보였다고 해서 원인이 항상 클라우드 설정에 있는 것은 아니었습니다. 애플리케이션이 만들어 낸 잘못된 입력이 서비스 오류로 나타나기도 했습니다.
5.4 오래된 런타임 의존성도 함께 옮겨야 했습니다
일부 도구에 포함된 스크립트는 Python 2를 전제로 작성되어 있었습니다. 컨테이너를 새로 만들면서 Python 3 환경만 준비하면 해당 스크립트가 정상적으로 실행되지 않았습니다.
이때는 런타임만 바꿀 수 있는지, 스크립트 수정이 필요한지, 도구 버전까지 변경해야 하는지를 함께 확인해야 합니다.
특히 기존 분석 결과를 유지해야 하는 이관에서는 도구를 최신 버전으로 바꾸는 작업과 실행 환경을 옮기는 작업을 한꺼번에 진행하면 차이의 원인을 찾기 어려워집니다. 가능하면 변경을 나누고, 각 변경이 결과에 미치는 영향을 확인하는 편이 좋습니다.
6. 일반 AWS SA에게 남는 허들: 실행 성공과 분석 검증의 경계
일반적인 클라우드 엔지니어에게 낯선 부분은 파일 확장자보다 분석 조건이 결과에 미치는 영향일 수 있습니다.
예를 들어 참조 유전체가 GRCh37인지 GRCh38인지에 따라 좌표 해석이 달라집니다. 패널과 타깃 영역 파일, 도구 버전, 필터 기준도 결과에 영향을 줍니다.
이관 과정에서도 컨테이너가 실행되고 결과가 생성됐지만, 기존 결과와 수치가 달라 추가 검토가 필요한 단계가 있었습니다. 프로세스가 정상 종료됐다는 사실만으로 분석 결과가 동등하다고 판단할 수는 없었습니다.
역할을 나누면 검증 범위가 명확해집니다.
| 검증 영역 | 확인 내용 | 주요 협업 대상 |
|---|---|---|
| 실행 환경 | 이미지, 파일 접근, 권한, 자원, 종료 상태 | 클라우드·플랫폼 담당자 |
| 워크플로우 | 단계 간 파일 연결, 조건 분기, 결과 내보내기 | 파이프라인 개발자 |
| 분석 결과 | QC 지표, 변이 일치, 차이의 원인과 허용 기준 | 생물정보학·분석 담당자 |
실행 전부터 같은 입력과 참조 데이터, 도구 버전, 분석 조건을 확보해야 비교가 가능합니다. 결과 비교에서도 파일의 완전한 바이트 일치가 필요한지, 정렬 순서나 메타데이터 차이를 제외한 분석적 일치가 필요한지를 구분해야 합니다.
AWS SA가 모든 분석 알고리즘을 직접 판단할 필요는 없습니다. 대신 분석 담당자가 판단할 수 있도록 어떤 조건으로 실행됐고, 어느 단계에서 차이가 발생했는지 추적 가능한 환경을 만드는 역할이 중요합니다.
민감한 데이터를 다루는 경우에는 입력 데이터, 샘플 식별자, 출력과 로그에 무엇이 포함되는지도 함께 확인해야 합니다. 로그는 문제 해결에 필요하지만, 불필요한 식별정보까지 남기는 방식은 피해야 합니다.
7. 안정적으로 실행된 다음에 최적화하기
이관 중에는 전체 파이프라인을 완성하기 전에 한 단계씩 확인하는 편이 도움이 됐습니다.
컨테이너 단독 실행
   ↓
로컬 Nextflow 실행
   ↓
HealthOmics에서 작은 입력으로 실행
   ↓
단계별 결과 및 기존 결과 비교
   ↓
대표 입력으로 자원·시간 확인
로컬 Nextflow 테스트에서는 실패 이후 -resume 옵션을 사용하기도 했습니다. 다만 로컬 Nextflow의 실행 캐시와 HealthOmics의 Run Cache를 같은 설정으로 취급해서는 안 됩니다. HealthOmics에서는 별도의 Run Cache 구성과 적용 조건을 확인해야 합니다. HealthOmics Run Cache 문서
장애가 발생하면 전체 실행 상태뿐 아니라 실패한 작업의 로그와 실제 입력을 함께 확인해야 합니다. HealthOmics는 엔진 로그, 실행 로그, 작업 로그 등을 제공하므로 문제의 범위를 나누어 볼 수 있습니다. CloudWatch 로그 모니터링 문서
그다음에 CPU·메모리·스토리지를 조정할 수 있습니다. 한 번 성공한 작은 입력만으로 운영 자원을 줄이면, 더 큰 입력에서 메모리 부족이나 실행 시간 증가가 나타날 수 있기 때문입니다.
이 단계는 앞서 소개한 「AWS HealthOmics 리소스 최적화 — Kiro MCP 활용」과 연결됩니다. 해당 글은 Run Analyzer와 Kiro MCP를 활용한 자원 분석·최적화 접근을 다룹니다.
이관 단계에서 입력·도구·파라미터와 실행 기록을 정리해 두면, 이후 자원을 변경했을 때 비용과 시간뿐 아니라 결과가 유지되는지도 비교하기가 쉬워집니다.
8. 마치며
HealthOmics로 파이프라인을 옮기면서 가장 많은 시간을 쓴 부분은 기존 서버에서 당연하게 사용하던 조건을 찾아내는 일이었습니다.
컨테이너에 고정된 실행 명령, 하위 스크립트의 절대 경로, 오래된 런타임, 앞 단계의 파일 이름을 가정하는 코드까지. 하나씩 확인하다 보니 분석이 돌아가는 데 필요한 조건을 이전보다 분명하게 설명할 수 있게 됐습니다.
처음 유전체 분석 프로젝트를 맡는 AWS SA라면 생물학 용어부터 부담스럽게 느껴질 수 있습니다. 하지만 첫 출발은 익숙한 질문으로도 가능합니다.
어떤 입력을 받는가? 어떤 프로그램과 버전으로 처리하는가? 무엇을 출력하는가? 실패하면 어디에서 확인하는가? 같은 조건으로 다시 실행할 수 있는가?
이 질문에 답할 수 있으면 분석 담당자와 대화를 시작하고, 이관할 범위도 구체화할 수 있습니다. 그 이후에는 클라우드 담당자의 실행 환경 이해와 분석 담당자의 도메인 지식이 함께 필요합니다.
이번 이관은 서버를 바꾸는 작업이면서, 오래 운영해 온 파이프라인의 의존성을 다시 정리하는 기회였습니다. HealthOmics에서 실행 가능한 형태로 정리해 둔 입력·출력과 실행 조건은 다음 파이프라인을 옮길 때도 사용할 수 있는 가이드가 되었습니다.